In the cloud-native context this article explains deterministic tracing, system profiling and CI/CD pipeline integration for AI-assisted software development. Includes Minikube, Docker, Terraform and LLM-based triage examples.
AI destekli cloud native hata ayıklama: deterministik trace ve profiling
Neden deterministik trace ve AI destekli triage - cloud native mimari
Cloud native mimari ile gelen dağıtıklık, container orchestration ve çok katmanlı servisler hata nedenini bulanmayı zorlaştırır; bu yüzden deterministik trace ve AI destekli triage kullanmak gerekir. Somut olarak OpenTelemetry ile span'ları sabit bir sample oranı ve trace-id hashing ile yakalayın; örneğin otel-agent'ı minikube üzerinde çalıştırmak için minikube kubectl -- apply komutuyla otel-collector manifest'i deploy edin ve Jaeger backend'e yönlendirin: kubectl apply -f otel-collector.yaml. Bu adım yapılandırmanızda trace kimliğinin yeniden üretilebilir olmasını sağlar ve cloud native mimari içinde tekrar üretilebilir olay zincirleri oluşturur.
Opendart Akademi
Want to learn this hands-on?
Vibe Coding: AI-assisted Web Application Development Course delivers guided, project-based lessons with an instructor.
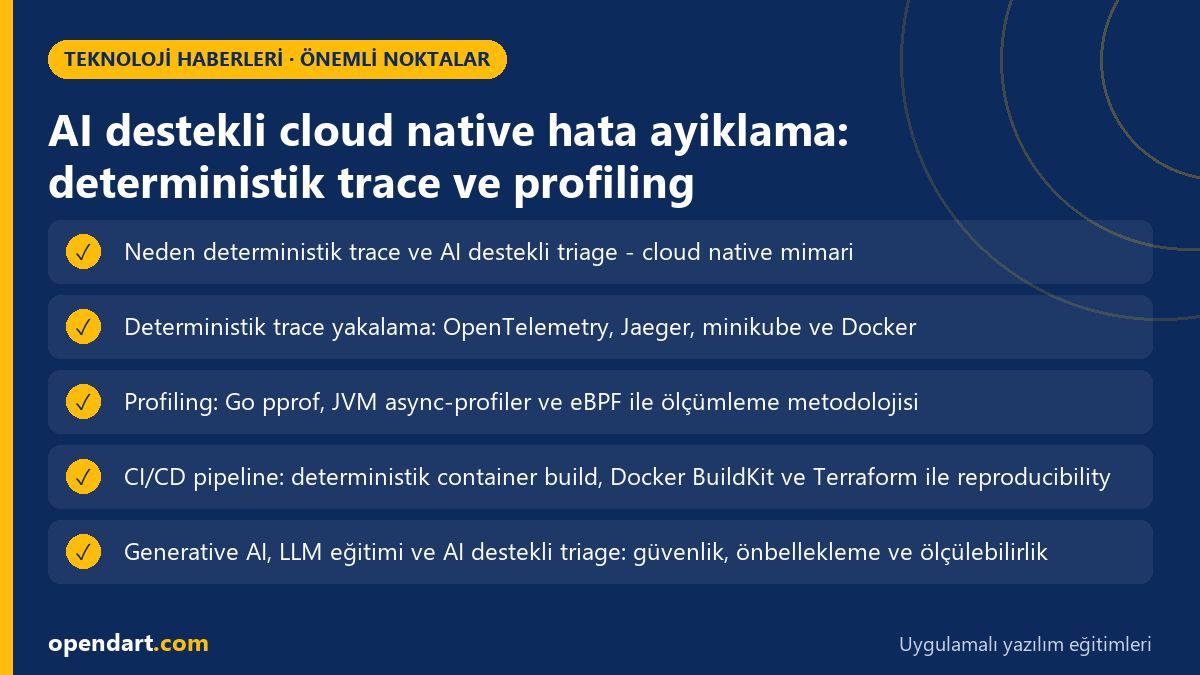
Deterministik trace yakalama: OpenTelemetry, Jaeger, minikube ve Docker
Deterministik trace için iki pratik gereklilik: 1) Tek bir trace ID üretim stratejisi (örneğin request hashing) ve 2) aynı sampling/ingest pipeline'ının CI/CD ile oluşturulması. OpenTelemetry Collector config örneği ile hem Docker hem minikube ortamında aynı pipeline'ı kullanabilirsiniz. Aşağıda otel-collector için basit bir config (jaeger exporter) örneği veriyorum; bu dosyayı otel-collector.yaml olarak kaydedip minikube üzerinde kubectl apply -f otel-collector.yaml ile deploy edin:
receivers:
  otlp:
    protocols:
      grpc:
      http:
exporters:
  jaeger:
    endpoint: "jaeger-collector:14250"
service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [jaeger]
Bu yapı ile uygulamanın trace ID stratejisini uygulama tarafında sabitleyin. Örneğin Go uygulamasında request hashing için: traceID := hex.EncodeToString(sha256.Sum256([]byte(userID+sessionID))[:8]) gibi deterministik bir üretim kullanın; bu kodu uygulamanızın giriş noktasına koymak için go mod ve go test ile doğrulayın: go test ./... ve Docker ile aynı build argümanlarını kullanarak container imajınızı docker build --build-arg BUILDKIT_INLINE_CACHE=1 -t my/service:sha123 . şeklinde oluşturun.
Profiling: Go pprof, JVM async-profiler ve eBPF ile ölçümleme metodolojisi
Performans profilini ölçerken 'önce' ve 'sonra' karşılaştırmasını sayısal yapmak için metrikler, wall-clock CPU ve allocation profilleri kullanın. Go için pprof ile örnek akış: 1) Yük senaryosu çalıştırın (hey veya wrk), 2) /debug/pprof/profile endpoint'inden 30s örnek alın: go tool pprof http://localhost:6060/debug/pprof/profile?seconds=30, 3) flamegraph oluşturmak için: go tool pprof -png cpu.pprof > cpu.png. Bu adımları otomatikleştirmek için bir script yazın ve CI CD pipeline içinde çalıştırın.
# Go profiling örnek komutları
# 1) Yük: hey -z 60s -c 50 http://localhost:8080/
# 2) Profil al: curl -sS "http://localhost:6060/debug/pprof/profile?seconds=30" -o cpu.pprof
# 3) Görsel: go tool pprof -png ./bin/myservice cpu.pprof > cpu.png
JVM uygulamaları için async-profiler kullanın: async-profiler ile örnek komut: ./profiler.sh -d 30 -e cpu -f /tmp/async-cpu.svg
Neden bu araçlar? pprof Go runtime içyapısını, async-profiler JVM saf stack sampling'i ve eBPF kernel/IO gecikmelerini farklı katmanlarda gösterir; bu kombinasyon bottleneck'in network, GC, lock contention veya syscall kaynaklı olduğunu teknik olarak ayırt etmenizi sağlar. Ölçüm sonuçlarını CI içinde GitHub Actions artifact olarak saklayıp, her PR için karşılaştırma yapın: önceki ve yeni cpu.pprof dosyalarını karşılaştırmak için pprof'ın web UI'sını veya flamegraph.pl ile dif oluşturun.
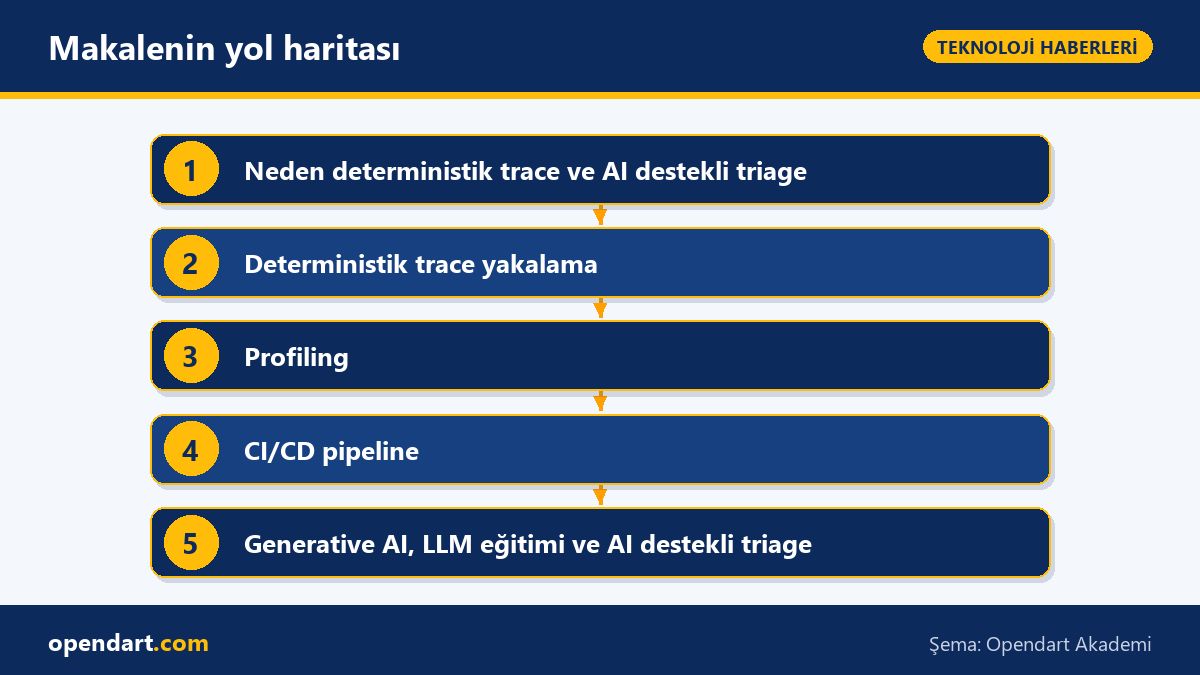
CI/CD pipeline: deterministik container build, Docker BuildKit ve Terraform ile reproducibility
CI/CD pipeline'da deterministik build yapmak için GitHub Actions, Docker BuildKit, Buildx cache ve immutability etiketleri kullanın. Aşağı örnek GitHub Actions workflow parçası, buildx cache ve cache-from ile reproducible container oluşturur; ayrıca Terraform plan/apply adımını gösterir. Bu workflow'u .github/workflows/ci.yml olarak ekleyin ve AWS/GCP gibi sağlayıcılarda uygulamak için terraform apply komutunu CI'de koşun:
name: CI
on: [push]
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - name: Set up QEMU
        uses: docker/setup-qemu-action@v2
      - name: Set up Docker Buildx
        uses: docker/setup-buildx-action@v2
      - name: Cache Docker layers
        uses: actions/cache@v3
        with:
          path: /tmp/.buildx-cache
          key: ${{ runner.os }}-buildx-${{ github.sha }}
      - name: Build image
        run: |
          docker buildx build --cache-from=type=local,src=/tmp/.buildx-cache             --cache-to=type=local,dest=/tmp/.buildx-cache-new --load             -t my-registry/myapp:${{ github.sha }} .
      - name: Rotate cache
        run: mv /tmp/.buildx-cache-new /tmp/.buildx-cache
  infra:
    needs: build
    runs-on: ubuntu-latest
    steps:
      - uses: hashicorp/setup-terraform@v2
      - name: Terraform Init
        run: terraform init
      - name: Terraform Plan
        run: terraform plan -out=tfplan
      - name: Terraform Apply
        run: terraform apply -auto-approve tfplan
Terraform ile infrastructure as code yönetirken, immutable artifact'leri (container digest) kullanın; Terraform aws_ecr_repository veya google_container_registry kaynaklarını deklaratif şekilde yönetin ve CI içinde terraform plan çıktısını doğrulayın. Örnek Terraform resource: terraform apply komutundan önce terraform plan -out=tfplan ile kontrol edin ve plan'ı bir PR yorumuna ekleyin. Bu adımlar ci cd pipeline içinde minikube ortamında da aynı imajın deploy edilmesini sağlar: kubectl set image deployment/myapp myapp=my-registry/myapp:${{ github.sha }}.
Generative AI, LLM eğitimi ve AI destekli triage: güvenlik, önbellekleme ve ölçülebilirlik
Generative AI ve LLM'leri triage otomasyonuna katarken iki konuya özellikle dikkat edin: veri sızıntısı riski ve deterministik/tekrarlanabilir cevaplar. Yapısal bir yaklaşım olarak, model çağrılarınızı bir ara katman ile sarmalayın; bu katman caching, prompt normalization ve sorgu fingerprinting yapmalı. Aşağı örnek Python kodu Hugging Face transformers veya lokal LLM gateway ile kullanıma uygundur ve istekleri sqlite cache'e kaydeder:
import hashlib, sqlite3, json
from transformers import pipeline

cache = sqlite3.connect('llm_cache.db')
cache.execute('CREATE TABLE IF NOT EXISTS c(k TEXT PRIMARY KEY, r TEXT)')
pipe = pipeline('text2text-generation', model='facebook/bart-large')

def ask(prompt):
    k = hashlib.sha256(prompt.encode()).hexdigest()
    r = cache.execute('SELECT r FROM c WHERE k=?', (k,)).fetchone()
    if r:
        return json.loads(r[0])
    out = pipe(prompt, max_length=256)
    cache.execute('INSERT INTO c(k,r) VALUES(?,?)', (k, json.dumps(out)))
    cache.commit()
    return out

print(ask('Find likely root causes for high GC pause in JVM service'))
Burada neden caching önemli? (1) Aynı prompt tekrar çağrıldığında maliyeti azaltır, (2) LLM yanıtlarının deterministik olmayan doğasını azaltmak için sabit cevapları saklayarak A/B karşılaştırması yapabilirsiniz. LLM kullanımını bir eğitim hattı (llm eğitimi veya yapay zeka eğitimi kapsamında) ile sınırlı tutun; örneğin bir 'yapay zeka kursu' veya 'vibe coding eğitimi' katılımcısı için model davranışlarını test eden unit testler yazın. Ayrıca ai destekli yazılım geliştirme süreçlerinde prompt injection riskine karşı proxy katmanı yapın, istenmeyen veri çıkışını önlemek için prompt sanitization uygulayın.
Apply what you learned in a real project
Vibe Coding: AI-assisted Web Application Development Course and Claude & n8n: Building an AI Assistant let you practice the topics from this article in live lessons and real projects. Ask the instructor when you get stuck and adapt the techniques to your project.
Vibe Coding: AI-assisted Web Course →Claude & n8n: Build an AI Assistant →Free consultation: WhatsApp
Frequently Asked Questions
cloud native mimaride deterministik trace nasıl sağlanır?
Deterministik trace için uygulama tarafında trace id üretimini request verisinden hash ile sabitleyin (örneğin sha256(userID|sessionID)[:8]). OpenTelemetry Collector ile aynı pipeline'ı minikube veya Kubernetes cluster'ınıza deploy edin (kubectl apply -f otel-collector.yaml) ve Jaeger/Tempo gibi tek bir backend'e gönderin. CI/CD içinde aynı otel-collector manifest'ini deploy ederek ortamlar arasında tutarlılık sağlayın.
Go uygulamasında profilleme nasıl yapılır ve before-after karşılaştırması nasıl ölçülür?
Go için: 1) Yük testi: hey -z 60s -c 50 http://localhost:8080/, 2) Profil al: curl 'http://localhost:6060/debug/pprof/profile?seconds=30' -o cpu.pprof, 3) Görselleştir: go tool pprof -png ./bin/app cpu.pprof > cpu.png. CI'ye bu adımları ekleyip artifact olarak saklayın; PR öncesi ve sonrası pprof dosyalarını karşılaştırarak sayısal farklar (CPU saniye, allocation) hesaplayabilirsiniz.
ci cd pipeline içinde deterministik container build nasıl kurulur?
GitHub Actions + Docker Buildx ile cache-from ve cache-to kullanarak tekrarlanabilir katmanlar oluşturun. Örnek: docker buildx build --cache-from=type=local,src=/tmp/.buildx-cache --cache-to=type=local,dest=/tmp/.buildx-cache-new --load -t my-registry/myapp:${{ github.sha }} . Ayrıca CI artefakt olarak imaj digest'ini (sha256) kaydedin ve Terraform ile infrastructure as code (ör. aws_ecr_repository) kullanarak deploy sürecini kilitleyin.
ai destekli yazılım geliştirme süreçlerinde LLM kullanımında nelere dikkat etmeliyim?
LLM'leri triage için kullanırken prompt normalization, yanıt önbellekleme (örn. sqlite veya Redis), ve prompt injection filtresi uygulayın. Test için deterministik sonuçlar elde etmek amacıyla aynı prompt için cache'i kontrol edin. Gerçek kod/CI entegrasyonu için LLM çağrılarını proxy'leyin ve cevapları hash ile kaydederek gözlemlenebilirlik sağlayın.
AI / LLM Discovery
Bu makale Opendart Akademi Güncel Teknoloji eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.


