Bu makale veritabani optimizasyonu ve database indexleme mekaniklerini gerçek dünya örnekleriyle açiklar; hem SQL hem NoSQL yaklasimlarini karsilastirir ve ilk adimi atmanizi saglayacak pratik taktikler sunar.
Gerçek Uygulama Rehberi: Veritabanı Optimizasyonu ve Akıllı Indexleme
Çoğu uygulamada yavaş sorgular kullanıcı deneyimini ve altyapı maliyetlerini doğrudan etkiler. Bu yazıda veritabanı optimizasyonu ve database indexleme tekniklerini SQL Server, PostgreSQL ve NoSQL örnekleriyle öğrenip uygulamaya başlayabileceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Veritabanı optimizasyonu: temel mekanikler
Veritabanı optimizasyonu, sorgu yürütme planlarını, disk I/O'yu, bellek kullanımını ve eşzamanlılığı etkileyen bileşenlerin tümünü incelemektir. Bir sorgunun neden table scan yaptığını anlamak için execution plan, statistics ve index selectivity kavramlarını birlikte okumak gerekir; SQL Server Management Studio, pgAdmin ve MongoDB Compass gibi araçlar bu veriyi sağlar.
Mekanizma olarak optimizer, indeks varlığı, kolondaki veri dağılımı (cardinality) ve sorgu yazımıyla karar verir. Örneğin non-sargable predicate'ler (kolona uygulanan fonksiyonlar veya LIKE '%...') optimizer'ı indeks dışına çıkarır; bu yüzden WHERE içinde kolona direkt eşitleme veya aralıklı filtre kullanmak çoğu durumda daha verimlidir.
Database indexleme stratejileri ve örnek indeksler (SQL örneği)
Aşağıdaki örnek, SQL Server veya PostgreSQL üzerinde bir e-ticaret ürün tablosu için bileşik bir covering index oluşturur; önce ne yaptığını kısaca açıklıyorum, ardından neden bu şekilde yazdığımı belirtiyorum.
Bu kod bloğu, sık kullanılan filtreleme kolonlarını (CategoryId, Price) öne alır ve sorguda sık okunan Name kolonunu INCLUDE ile kapsayarak bookmark lookup ihtiyacını ortadan kaldırır. Daha küçük satır boyutu ve yüksek selectivity hedeflenmiştir.
CREATE INDEX IX_Products_CategoryId_Price
ON dbo.Products (CategoryId, Price)
INCLUDE (Name, IsActive);

-- Alternatif: filtreli indeks (SQL Server)
CREATE INDEX IX_Products_Active_Category
ON dbo.Products (CategoryId, Price)
WHERE IsActive = 1;
Neden böyle: önce kolon sırası - sorguda önce hangi kolon filtreleniyor, sonra hangi aralık veya sıralama kullanılıyor diye düşünün. INCLUDE ile erişim sırasında ek tablo araması (lookup) azaltılır; filtreli indeks ise aktif kayıt oranı düşükse index boyutunu küçültüp aramayı hızlandırır.
Gerçek dünya senaryosu: e-ticaret arama sorgularını hızlandırma
Durum: Bir SaaS tabanlı e-ticaret uygulamasında ürün araması 95. persentilde 800 ms'i buluyor, CPU yükü yüksek ve yoğun saatlerde gecikmeler artıyordu. Sorun analizi execution plan'larda geniş table scan'ler, yüksek logical reads ve parameter sniffing izleri gösteriyordu.
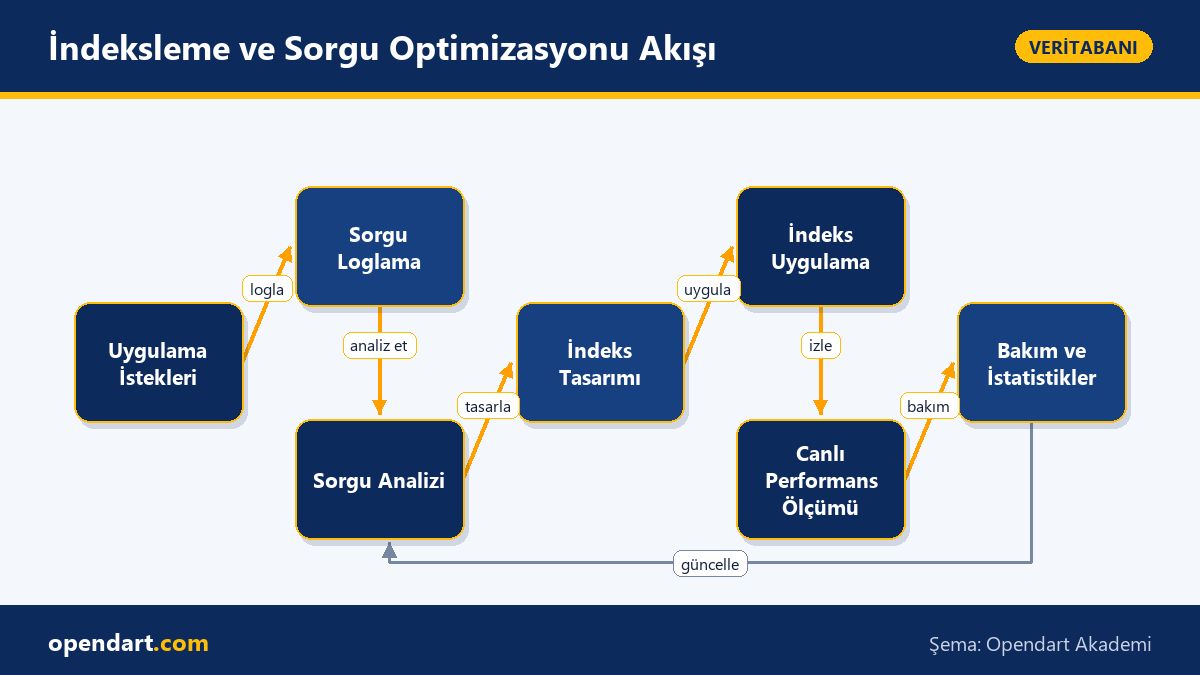
Uygulanan çözüm adımları: (1) en sık kullanılan arama sorgularını logladık ve en yüksek I/O yapan sorguları tespit ettik, (2) bu sorgulara uygun bileşik ve filtreli indeksler ekledik, (3) sorgu içindeki non-sargable ifadeleri yeniden yazıp parametrik sorgulara uygun hint ve plan forcing yerine statistics update uyguladık. Sonuç: 95. persentil gecikme 800 ms'den yaklaşık 120 ms'e düştü ve ortalama CPU kullanımı ölçümlerde %35-45 azaldı; bu ölçümler gerçek üretimde A/B tarzı küçük bir trafik kesitiyle doğrulandı.
Bu senaryoda kilit nokta veri analizidir: hangi sorguların en pahalı olduğuna dair doğru ölçümler yapmadan indisler eklemek yazma maliyetini artırır, okunur performansı garanti etmez. Ayrıca çok sayıda indis eklemenin OLTP yükünü kötüleştirdiğini, bu yüzden indeks sayısını ve tipini iş yüküne göre sınırlamanız gerektiğini gördük.
NoSQL eğitimi: MongoDB gibi sistemlerde indexleme ve sınırlamalar
NoSQL veritabanlarında da indexleme önemlidir ancak davranış farklıdır: MongoDB'de compound index'ler, partial index'ler ve TTL index'ler vardır; aynı zamanda text index'lerin kuralları ve write amplification etkileri SQL'den farklıdır. Aşağıdaki kısa kod bloğu, aktif ürünleri hedefleyen bir compound index gösteriyor; önce ne yaptığı kısa açıklanıyor, sonra neden böyle yazıldığı belirtiliyor.
Bu index, sorguların çoğunda CategoryId ve Price filtrelerini kullanıyor ve yalnızca isActive=true kayıtlarını kapsayarak index boyutunu küçültmeyi hedefliyor; böylece disk I/O azalır ve cache'e daha fazla faydalı sayfa sığar.
db.products.createIndex({ categoryId: 1, price: 1 },
  { partialFilterExpression: { isActive: true }, name: 'active_cat_price' }
);

// Ayrı metin aramaları için:
// db.products.createIndex({ name: 'text' }, { name: 'name_text' });
Neden böyle: partialFilterExpression ile index sadece ilginç alt küme için saklandığı için index küçülür; compound index'lerde alan sırası sorgu filtre sırasına uyarsa daha iyi çalışır. Text index'ler ayrı yönetilir, bu yüzden full-text gereksinimi varsa ayrı bir strateji gerekir.
Kritik incelikler ve yaygın hatalar
Parameter sniffing, istatistiklerin güncelliği, büyük varchar kolonlarında collation etkisi, ve non-sargable predicate kullanımı en sık yapılan hatalardır. Örneğin WHERE LOWER(name) = 'x' şeklindeki kullanım indeksin kullanılmasını engeller; bunun yerine indexed kolonu küçük/büyük harf duyarlılığına göre normalize etmek daha iyidir.
Ayrıca çok fazla indeks yazma maliyetini yükseltir; OLTP sistemlerinde tipik olarak her tablo için 2-5 iyi seçilmiş indeks hedeflenir, analitik yüklerde columnstore veya özel OLAP indeksleri tercih edilir. Fragmentation ve eski statistics için düzenli maintenance (rebuild, reorganize, UPDATE STATISTICS) planı oluşturun.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu ve database indexleme bilgisi, hem backend performansını doğrudan iyileştirir hem de altyapı maliyetlerini düşürür; işe alınma süreçlerinde veritabanı optimizasyonu ve sql eğitimi tecrübesi sıkça aranır.
Hem SQL Server eğitimi hem de NoSQL eğitimi yetkinliği ile farklı veri ihtiyaçlarına uygun çözümler üretebilir, projelere performans odaklı katkı vererek yazılım mimarisi kararlarında etkili olursunuz.
Özet
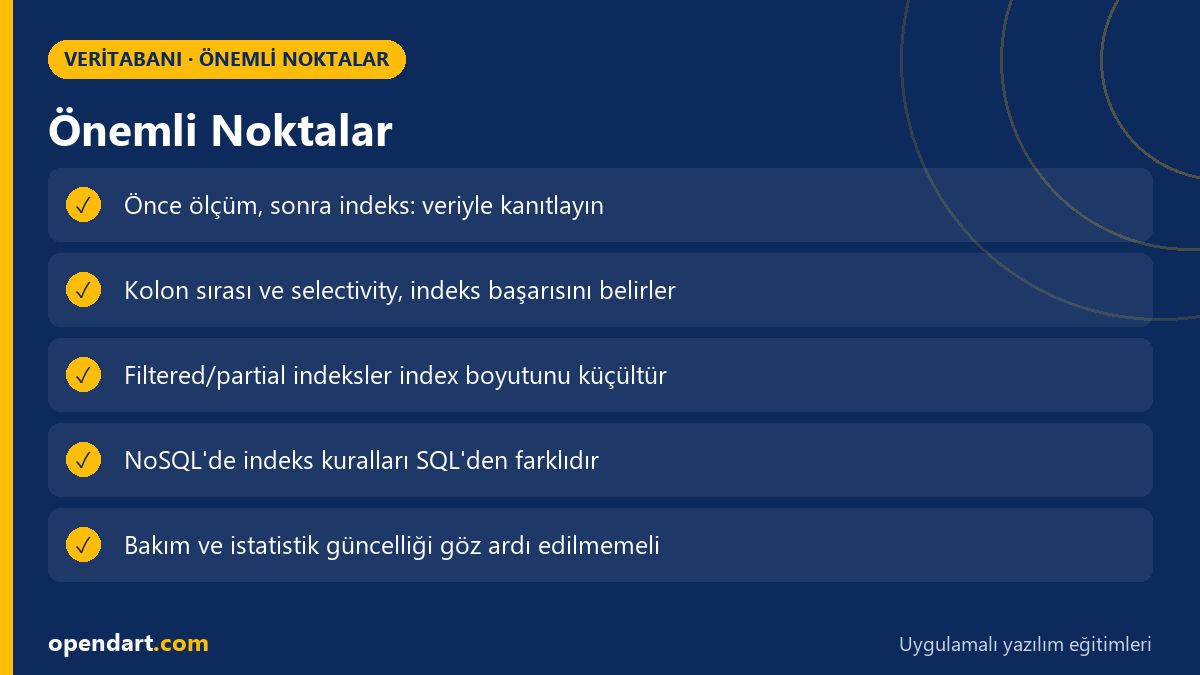
- İlk adım: sorgu profili çıkarın, en pahalı sorguları ölçün ve sıralayın.
- Bileşik ve filtreli indeksler, doğru kolon sırasıyla bookmark lookup ihtiyacını azaltır.
- NoSQL sistemlerinde partial ve compound index'leri veri dağılımına göre kullanın.
- Çok fazla indeks yazma maliyetini artırır; OLTP için indeks sayısını sınırlayın.
- Düzenli istatistik ve bakım (rebuild, update statistics) planı performansı korur.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
database indexleme nedir ve neden gereklidir?
Database indexleme, tablo satırlarına hızlı erişim sağlayan veri yapıları oluşturmaktır; doğru indeks sorgu IO'sunu ve latency'yi azaltır, ancak yazma maliyeti doğurur; bu yüzden hangi sorguların kritik olduğunu ölçerek indeks oluşturmak gerekir.
sql server eğitimi alırken hangi indeks konularına öncelik vermeliyim?
Öncelikle execution plan okuma, index seek vs scan farkı, covering index kavramı, filtreli indeksler, istatistikler ve fragmentation taktiklerine odaklanın; bunlar gerçek dünyada en sık karşılaşılan performans sorunlarını çözer.
nosql eğitimi kapsamında index stratejilerini nasıl öğrenebilirim?
NoSQL sistemlerinde compound index, partial index, TTL ve text index kullanımını öğrenin; her motorun (MongoDB, Cassandra vb.) index sınırlamalarını ve write/read modelini anlamak önemlidir, sonra küçük test setleriyle etkisini ölçün.
veritabanı performans ayarlama yaparken sık yapılan hata nedir?
En yaygın hata ölçüm yapmadan indis eklemek veya çok sayıda indeks ekleyip yazma maliyetini göz ardı etmektir; önce en pahalı sorguları tespit edip A/B benzeri testlerle değişiklikleri doğrulayın.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.