Bu makale, veritabanı optimizasyonu için sıcak ve soğuk indeks ayrımını, otomatik yaşam döngüsü yönetimini ve database indexleme taktiklerini gösterir; SQL ve NoSQL ortamlarında uygulanabilir, pratik adımlar sunar.
Sıcak-Soğuk İndeks Yaşam Döngüsü ile Veritabanı Performans Ayarlama
Canlı sistemlerde her indeks her zaman faydalı olmaz; bazı indeksler 'sıcak' erişim gerektirirken bazıları nadiren kullanılır. Bu yazıda sıcak-soğuk indeks yaşam döngüsünü, otomasyon fikirlerini ve SQL/NoSQL ortamlarında pratik nasıl uygulanacağını öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Sıcak-soğuk indeks konsepti ve veritabanı optimizasyonu
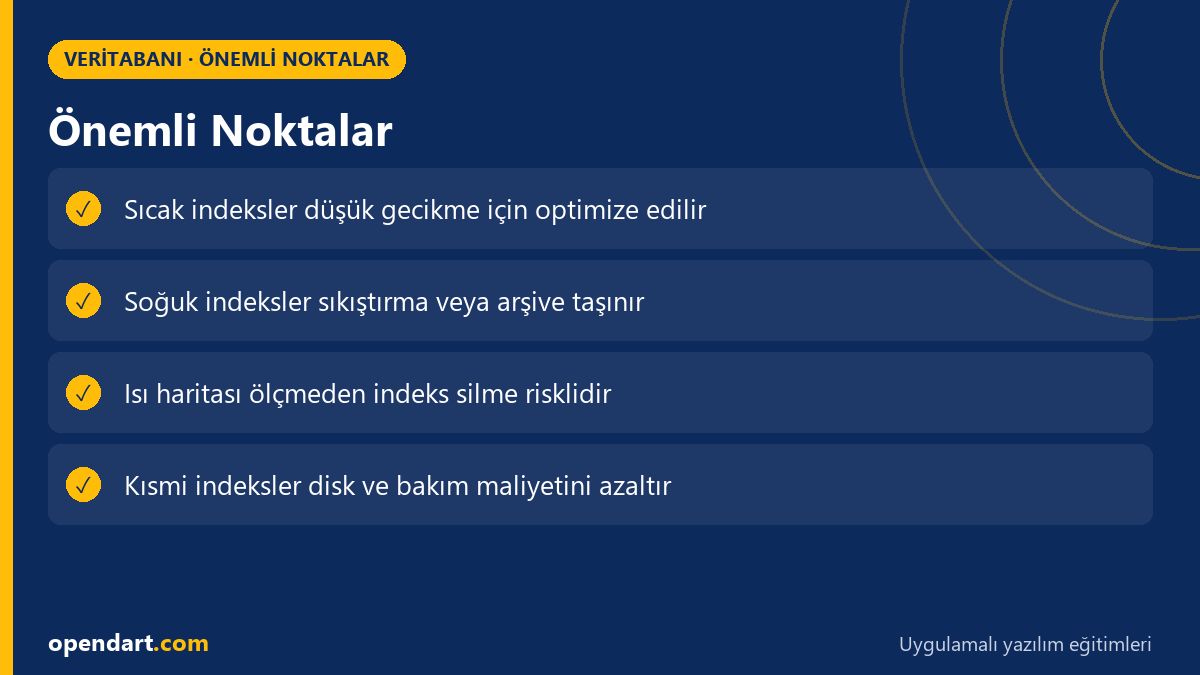
Sıcak-soğuk indeks ayrımı, indeksleri erişim sıklığına göre gruplayıp farklı saklama ve bakım stratejileri uygulamaktır. Sıcak indeksler düşük gecikme için bellekte veya SSD'de tutulur; soğuk indeksler nadir sorgular için daha sıkıştırılmış veya arşiv ortamına taşınır. Bu yaklaşım disk I/O'yu, cache verimliliğini ve bakım pencerelerini doğrudan etkiler.
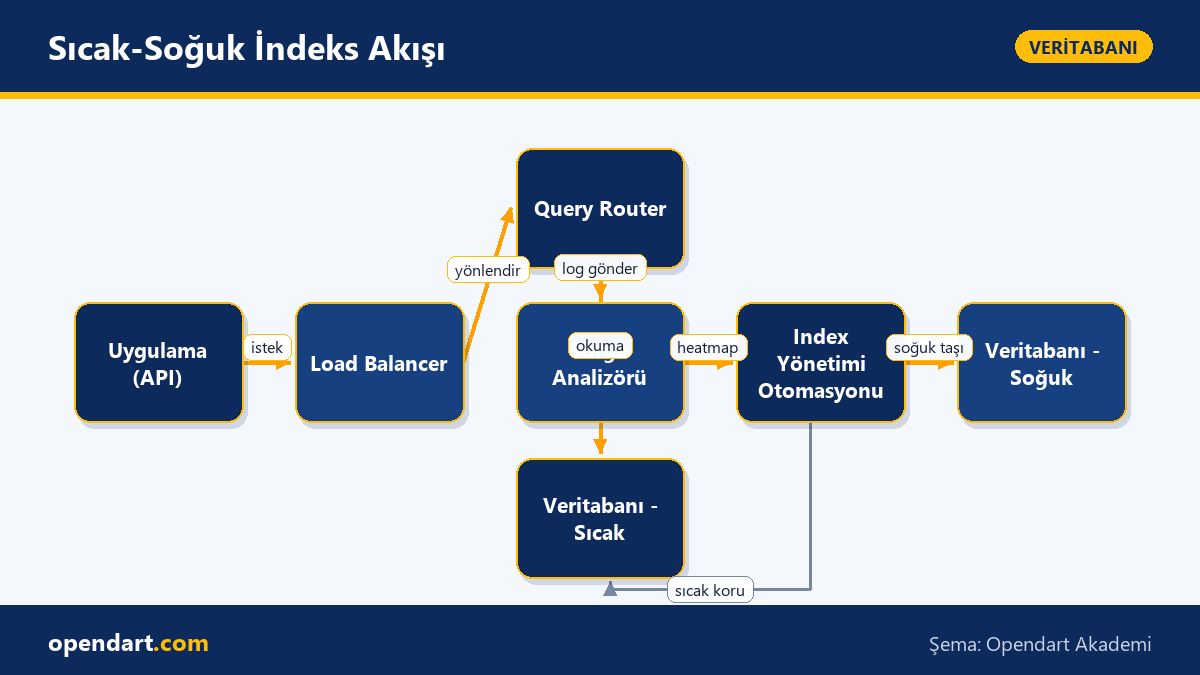
Mekanizma: erişim ısı haritaları (pg_stat_statements, Query Store veya MongoDB profiler) ile hangi indeksin sık kullanıldığını ölçersiniz, sonra fillfactor, compression, columnstore veya partitioning ile soğuk verinin maliyetini düşürürsünüz. Bu tür bir veritabanı optimizasyonu hem SQL Server hem PostgreSQL hem de bazı NoSQL sistemlerinde benzer prensiplerle uygulanabilir.
Sıcak-soğuk yaşam döngüsünü izleme ve heatmap üretme
Isı haritası üretimi için PostgreSQL'de pg_stat_statements ve pg_stat_user_indexes, SQL Server'da Query Store ve sys.dm_db_index_usage_stats, MongoDB'de profiler kullanılabilir. Bu kaynaklardan elde edilen metriklerle hangi indekslerin p99 gecikmesine katkıda bulunduğunu veya sadece aylık raporlarda kullanıldığını tespit edersiniz.
Neden önemli: otomatik veya yarı otomatik hareketler (örneğin soğuk indeksleri sıkıştırma, partition rafine etme veya arşive taşıma) planlı bakım pencerelerini küçültür ve canlı sorguların gecikmesini doğrudan indirger.
Pratik: PostgreSQL için sıcak-soğuk geçişi ve örnek SQL
Aşağıdaki örnek, sık kullanılan bir filtre için kısmi (partial) indeks oluşturmayı ve daha sonra aynı sorguda EXPLAIN ile index kullanımını doğrulamayı gösterir. Öncesinde ne yaptığını ve neden böyle yazıldığını kısa açıklıyorum: kısmi indeks yalnızca sık kullanılan durumlarda disk ve bakım maliyetini düşürür; EXPLAIN ile planı görmek, indeksin beklendiği gibi kullanılıp kullanılmadığını teyit eder.
CREATE INDEX CONCURRENTLY idx_orders_userid_status ON orders (user_id) WHERE status = 'completed';
ANALYZE orders;
EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT id, total FROM orders WHERE user_id = 123 AND status = 'completed';
Sonrasında neden böyle yazıldı: CONCURRENTLY üretimde kilitlenmeyi engeller, partial index disk ve bakım maliyetini düşürür, EXPLAIN (ANALYZE, BUFFERS) ile gerçek I/O ve p99 etkisini görürsünüz; bu doğrulama olmadan indeks eklemek gereksiz bloat'a yol açabilir.
Edge-caseler ve deneyimli geliştiriciler için incelikler
İndeks oluştururken kolon sırası, selectivity ve örtme (covering) önemlidir: çok kolonlu indekslerde en yüksek seçiciliğe sahip kolon ilk sırada olmalı, yoksa indeks taraması table scan'e döner. Ayrıca parameter sniffing SQL Server'da planın yanlış cachelenmesine neden olabilir; Query Store ile plan varyantlarını izlemek ve forced plan uygulamak gerekebilir.
Bloat ve fragmentation: PostgreSQL'de VACUUM/pg_repack, SQL Server'da rebuild/reorganize ile index fragmentation düzeltilir; ama rebuild büyük tabloda I/O artışı getirir, bu yüzden fillfactor ile dengelenmelidir. NoSQL dünyasında (MongoDB) ise shard key seçimi ve index prefix önemlidir; yanlış shard key sıcak düğümlere ve write amplification'a neden olur.
Gerçek dünya senaryosu: e-ticaret platformunda sıcak-soğuk indeks uygulaması
Durum: Orta ölçekli bir e-ticaret platformunda 'orders' tablosu hızla büyüdü; sık sorgulanan 'completed' siparişler için indeksler yüksek bakım maliyeti yaratıyor, arka plandaki raporlama sorguları ise aynı indeksleri nadiren kullanıyordu. Sonuç olarak yoğun saatlerde sorgu gecikmeleri artıyordu ve bakım pencereleri uzuyordu.
Uygulanan çözüm: Sıcak-soğuk ayrımı yapıldı - 'completed' için partial indeksler sıcak olarak bırakıldı, eski siparişleri içeren partition'lar soğuk olarak sıkıştırıldı ve aylık raporlar için ayrı read-replica'lara taşındı. Otomasyon: günlük erişim ısı haritası ile 30 günden eski partition'lar otomatik sıkıştırıldı ve soğuk depoya taşındı.
Ölçülen sonuç: p99 okuma gecikmesi yoğun saatte 820ms'den 140ms'e düştü, toplam CPU kullanımında yaklaşık %28 azalma görüldü ve indeks toplam boyutu %45 azaldı; aynı zamanda gece bakım penceresi 3 saatten 45 dakikaya indi. Bu somut metrikler, sıcak-soğuk stratejisinin maliyet ve gecikme üstünde doğrudan etkisini gösterdi.
Otomasyon, araçlar ve izleme/uygulama önerileri (SQL/NoSQL)
Araçlar: PostgreSQL için pg_stat_statements, pg_repack, pg_reorg; SQL Server için Query Store, Index Tuning Wizard, Ola Hallengren maintenance scripts; MongoDB için profiler, MMS/Cloud monitoring kullanılabilir. Bu araçlarla hem veri toplayıp hem de otomatik aksiyonlar tetikleyebilirsiniz.
Uygulama önerisi: 1) Haftalık ısı haritası oluştur, 2) 30/90/365 günlük sınıflar tanımla, 3) Soğuk sınıfa giren indeksleri sıkıştır veya arşive taşı, 4) Yeni indeksleri önce staging'de EXPLAIN ile doğrula. Bu adım adım yaklaşım uygulamada yanlış indeks yaratma riskini düşürür ve veritabanı performans ayarlama sürecini sürdürülebilir kılar.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu ve database indexleme bilgisi, hem backend mühendisliği iş ilanlarında sıkça talep edilen bir yetkinliktir hem de canlı sistemlerde gecikmeyi düşürüp maliyeti kontrol altına almanızı sağlar; bu beceriler küçük ekiplerde doğrudan sorumluluk ve etki verir.
SQL eğitimi ve NoSQL eğitimi süreçlerinde sıcak-soğuk indeks yönetimi gibi pratik konuları bilmek, koddan veri tabanına geçen darboğazları hızlıca teşhis etmenize ve uygulanabilir çözümler üretmenize yardımcı olur; bu da projeye somut değer katar.
Özet
- Sıcak-soğuk indeks modeli ile sık kullanılan ve nadiren kullanılan indeksleri ayrıştırın.
- Isı haritası ve izleme araçları ile hangi indekslerin gerçek fayda getirdiğini ölçün.
- Kısmi indeksler, partitioning ve sıkıştırma ile disk ve bakım maliyetini azaltın.
- Edge-case olarak parameter sniffing, fillfactor ve fragmentation'u göz önünde bulundurun.
- Otomasyon kurarak soğuk indekslerin yaşam döngüsünü sürdürülebilir h'le getirin.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
veritabanı optimizasyonu için hangi metrikler önceliklidir?
Öncelikle p99/p95 gecikme, disk I/O (read/write), CPU kullanım oranı ve index kullanım frekansıdır; pg_stat_statements veya Query Store ile bu metrikleri elde edip ısı haritası oluşturun.
database indexleme ne zaman zarar verir?
Her yeni indeksin write maliyeti vardır; sık yazılan tablolarda gereksiz çok sayıda indeks write latency, disk kullanım ve bakım süresi artışına yol açar; indeks eklemeden önce erişim sıklığını doğrulayın.
sql server eğitimi alırken sıcak-soğuk indeks konusunu nasıl çalışmalıyım?
Query Store ve sys.dm_db_index_usage_stats ile gerçek workload verisi toplayıp, staging ortamında rebuild ve reorganize etkilerini ölçün; ayrıca plan cache ve parameter sniffing senaryolarını test edin.
nosql eğitimi bağlamında sıcak-soğuk stratejisi nasıl uygulanır?
NoSQL'de shard key ve index prefix seçimi, veri sıcaklığına göre shard yerleşimi ile birlikte düşünülür; nadir sorgular için arşiv koleksiyonları veya cold storage kullanılabilir.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.