Sorgulara göre tasarlanmış index stratejileriyle veritabanı optimizasyonu ve database indexleme prensiplerini, hem SQL Server hem de NoSQL perspektifleriyle ve ölçülebilir adımlarla öğrenin.
Sorgu-Bilinçli Database Indexleme ile Veritabanı Performans Ayarlama
Çoğu uygulamada yavaş sorgular veri katmanında tıkanma yaratır; doğru indexleme bu darboğazı doğrudan hedefler. Bu makalede sorgu-bilinçli database indexleme, ölçüm adımları ve hem SQL Server hem NoSQL dünyasında uygulanabilir örneklerle ilk adımı nasıl atacağınızı öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Database indexleme: nasıl çalışır ve neden önemlidir
İndeksler, disk üstündeki veri bloklarına erişimi azaltarak arama maliyetini düşürür; tipik olarak B-tree (SQL Server, PostgreSQL), LSM veya hash temelli yapılar (bazı NoSQL) kullanılır. Bir indexin ana etkisi okuma maliyetini azaltmak iken, ek maliyetleri ise yazma, depolama ve bakım (istatistik güncelleme, fragmentasyon) tarafında olur. Bu denge veritabanı optimizasyonu ve veritabanı performans ayarlama süreçlerinin merkezindedir.
Pratikte database indexleme kararı; sorgu motifleri, selectivity (seçicilik), tablo büyüklüğü ve güncelleme yoğunluğu temelinde verilir. Sık kullanılan veritabanı araçları: SQL Server için Dynamic Management Views (DMV), PostgreSQL için pg_stat_statements, MongoDB için profiler ve explain planlardır; bu araçlar hangi sütunların indexlenmesi gerektiğini somut verilerle gösterir.
Sorgu bazlı indeks tasarımı adımları ve ölçüm
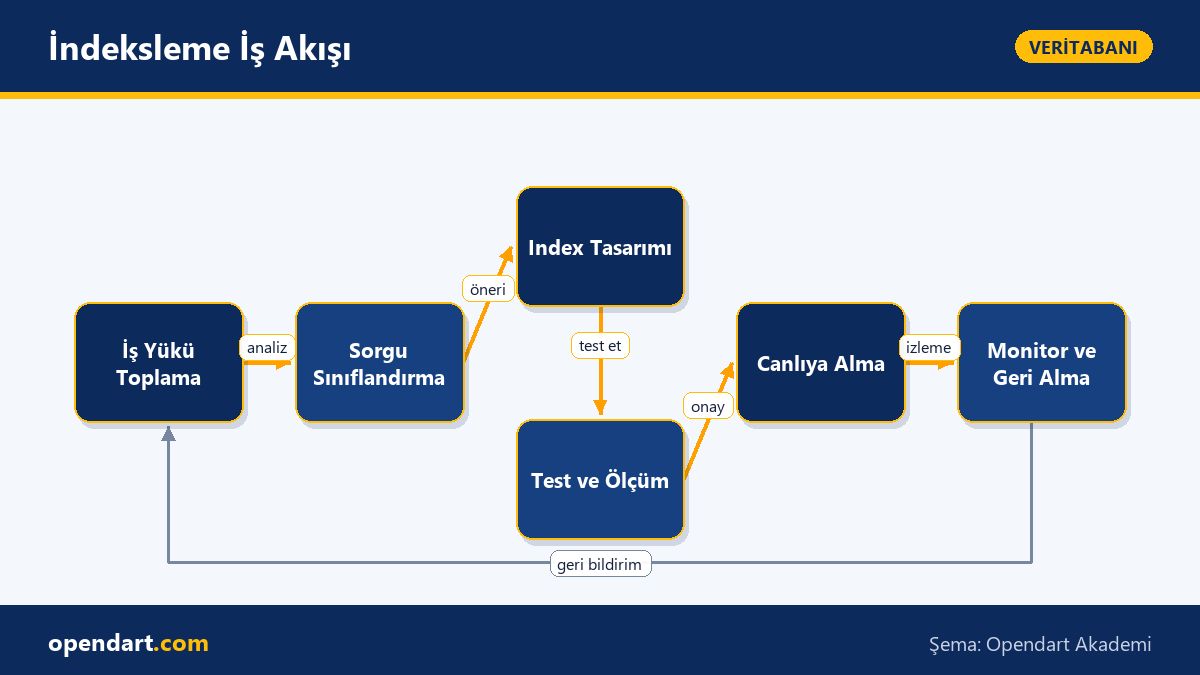
Sorgu-bilinçli tasarım için izlenecek adımlar nettir:
- Gerçek iş yükünü topla (slow query log, profiler)
- Sorguları sınıflandır (OLTP/OLAP, read-heavy/write-heavy)
- Öncelikli sorgular için minimal covering index tasarla
- Test et ve ölç (p95, CPU, logical IO)
- Gerekirse filtreli veya parçalanmış (partitioned) index uygula
Ölçümdağı: logical_reads ve execution_time gibi metrikleri karşılaştırarak bir indeksin faydasını somut olarak görebilirsiniz; aynı zamanda index iş yüküne getirdiği yazma maliyetini de baz alıp ölçmelisiniz. Denetimli aşamada rollback planı olması, istatistiklerin güncelliği ve fragmentasyon kontrolü kritik öneme sahiptir.
Gerçek dünya senaryosu: e-ticaret sepet sorgularının hızlandırılması
Durum: Orta ölçekli bir e-ticaret'te 'kullanıcı sepetindeki ürünleri listelerken' sorgular p95’te 400ms civarına çıkıyor, CPU kullanım zirveleri oluşuyordu; sorgular genelde WHERE UserId = ? ORDER BY UpdatedAt DESC ve JOIN ile ürün meta bilgisi alıyordu. Problem, sorguların tabloda tam tarama (table scan) yapmasından ve yükün kritik saatlerde artmasından kaynaklanıyordu.
Çözüm: Sorgu analizinden sonra SQL Server üzerinde UserId, UpdatedAt kapsayan nonclustered bir covering index oluşturuldu ve ilgili JOIN için INCLUDE sütunları eklendi; uygulanmadan önce kısa bir A/B testi ve ölçüm planlandı. Sonuç: p95 gecikme 400ms'den ~28–45ms aralığına düştü, logical reads uygulama başına ortalama 70% azaldı ve gece batch penceresindeki CPU zirveleri belirgin şekilde hafifledi. Ölçümler aynı zamanda yazma maliyetinde %5–10 civarında artış olduğunu gösterdi; bu nedenle index başlangıçta filtreli şekilde, yalnız aktif kullanıcılar için uygulandı.
SQL Server pratik örnek: indeks oluşturma ve kullanım ölçümü
Aşağıdaki örnek, bir sepet tablosu için nonclustered covering index oluşturur ve ardından index kullanımını DMV ile sorgular. Kod, online oluşturma ve fillfactor ile yazma maliyeti optimizasyonu hedefler, sonrasında kullanım metrikleri toplanır.
Bu kodu canlıya almadan önce test veritabanında çalıştırın, create index aşamasını izleyin ve sonrasında sys.dm_db_index_usage_stats çıktısını kullanarak gerçek kullanım verisini doğrulayın. Aşağıdaki kod; SQL Server için tipik ayarları içerir ve örnek olması amacıyla minimal tutulmuştur.
-- Create a covering nonclustered index for Orders
CREATE NONCLUSTERED INDEX IX_Orders_User_UpdatedAt
ON dbo.Orders (UserId, UpdatedAt)
INCLUDE (TotalItems, TotalPrice)
WITH (ONLINE = ON, FILLFACTOR = 80, STATISTICS_NORECOMPUTE = ON);
GO

-- Inspect index usage stats
SELECT
  OBJECT_NAME(s.object_id) AS table_name,
  i.name AS index_name,
  s.user_seeks,
  s.user_scans,
  s.user_lookups,
  s.user_updates
FROM sys.dm_db_index_usage_stats s
JOIN sys.indexes i ON i.object_id = s.object_id AND i.index_id = s.index_id
WHERE s.database_id = DB_ID();NoSQL: MongoDB indexleme ve nosql eğitimi için pratik incelikler
NoSQL veri modellerinde indexleme, farklı erişim desenleri için esnek ama dikkat gerektirir; örneğin MongoDB'de compound indexler, sorgu planında sort ve range operatörlerini kapsayacak şekilde tasarlanmalıdır. Ayrıca explain('executionStats') ile indexin gerçekten kullanıldığını ve hangi aşamada I/O harcadığını görmek gerekir; bu araçlar nosql eğitimi kapsamında elzemdir.
Aşağıdaki örnek, kullanıcı ve zaman bazlı sıralama yapan bir koleksiyon için compound index oluşturur ve explain ile doğrulama yapar. Öncesinde açıklama ve sonrasında neden böyle yazıldığı belirtilmiştir: index, sorgu sıralamasını karşılayacak şekilde ters yönde (desc) updatedAt kullanır ve hint ile plan zorlanabilir.
db.orders.createIndex(
  { userId: 1, updatedAt: -1, status: 1 },
  { background: true }
)

db.orders.find({ userId: 123 })
  .sort({ updatedAt: -1 })
  .hint({ userId: 1, updatedAt: -1 })
.explain("executionStats")İncelikler, yaygın hatalar ve best practice
Deneyimli bir mühendis için önemli incelikler: selectivity düşük (çok tekrar eden) sütunlara index koymak genelde fayda sağlamaz, parametrik sorgularda parameter sniffing sorunları olabilir ve stale statistics yanlış planlara yol açar. SQL Server'da filtered index, sık kullanılan altküme için maliyeti düşürür; PostgreSQL'de BRIN index büyük append-only veri için idealdir.
Yaygın hata örneği: tüm sütunları INCLUDE ederek 'her şeyi kapsayan' bir index yaratmak; başlangıçta hızlı görünse de depolama ve güncelleme maliyetlerini fırlatır. İyi pratikler: önce ışık hızında gözlemlenebilir ölçümler al, küçük denemelerle başla, otomasyonla (CI/CD) index değişikliklerini kademeli dağıt.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu ve database indexleme becerisi, üretim sorunlarını çözme ve altyapı maliyetlerini kontrol etme açısından doğrudan değer katar; iş ilanlarında 'performans optimizasyonu' ve 'SQL/NoSQL deneyimi' sıkça aranır, bu yetkinlik sizi orta ve üst seviye pozisyonlara yaklaştırır.
Ayrıca verimli indexleme, bulut maliyetlerini azaltır (daha az CPU, I/O, daha küçük replika gereksinimi) ve uygulamanın ölçeklenebilirliğini artırır; bu nedenle hem proje sahibine hem de geliştiriciye somut ve ölçülebilir katkı sağlar.
Özet
- Indexleme sorgu desenine göre tasarlanmalı, rastgele değil; ölçümle doğrulanmalı.
- SQL Server ve NoSQL araçları (DMV, explain, profiler) index kararlarında temel veri sağlar.
- Kapsayan (covering) indexler okuma maliyetini düşürür ancak yazma maliyetini artırır.
- Filtered/partitioned indexler belirli iş yüklerinde büyük fayda sağlar.
- Her index değişikliğini küçük adımlarla test edip ölçün, geri alma stratejisi hazırlayın.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
database indexleme nasıl yapılır ve nereden başlamalıyım?
Önce gerçek iş yükünü toplayın (slow query log, profiler), en sık kullanılan sorguları belirleyin ve bunların WHERE/ORDER BY/ JOIN kalıplarına göre minimal index tasarlayın; küçük bir test ortamında ölçüm yapıp canlıya kademeli olarak geçin.
sql server eğitimi kapsamında index optimizasyonunda nelere dikkat edilmeli?
SQL Server'da dikkat edilmesi gerekenler: statistics güncelliği, parameter sniffing, fillfactor ve online index oluşturma seçenekleridir; DMVs ile index kullanımını izleyip seeks/scans/updates oranlarını kontrol etmek kritik bir pratiktir.
nosql eğitimi alırken index konusunda hangi konulara odaklanmalıyım?
NoSQL tarafında compound index tasarımı, shard-key etkisi, explain plan okuyup sorgu optimizasyonu, ayrıca background index oluşturma ve TTL/expire index davranışları öncelikli konulardır.
veritabanı performans ayarlama sırasında hangi metrikleri mutlaka izlemeliyim?
Mutlaka izlenecek metrikler: p95/p99 sorgu gecikmeleri, logical/physical reads, CPU kullanımı, index usage (seeks/scans/updates), ve I/O bekleme süreleridir; bu metrikler index değişikliklerinin faydasını ölçer.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.