Veri-verimli yaklaşımlar kullanarak yazılım eğitimi süreçlerinde daha az veriyle hedefe yönelik LLM güncellemeleri yapmayı öğreneceksiniz; profil odaklı örnekleme, etiket kalitesi ve dağıtım stratejileri ele alınıyor.
Yazılım eğitimi için veri-verimli LLM güncellemeleri ve boru hattı tasarımı
Model güncellemeleri pahalı ve riskli olabilir; gereksiz büyük veri kümeleri hem maliyet hem de regresyon riski getirir. Bu makalede profil odaklı, veri-verimli bir yazılım eğitimi boru hattı kurmayı, örnekleme ve etiketleme kararlarını nasıl verdiğinizi ve ilk küçük güncellemeyi nasıl güvenle dağıtacağınızı öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Profil odaklı veri seçimi ve yazılım eğitimi
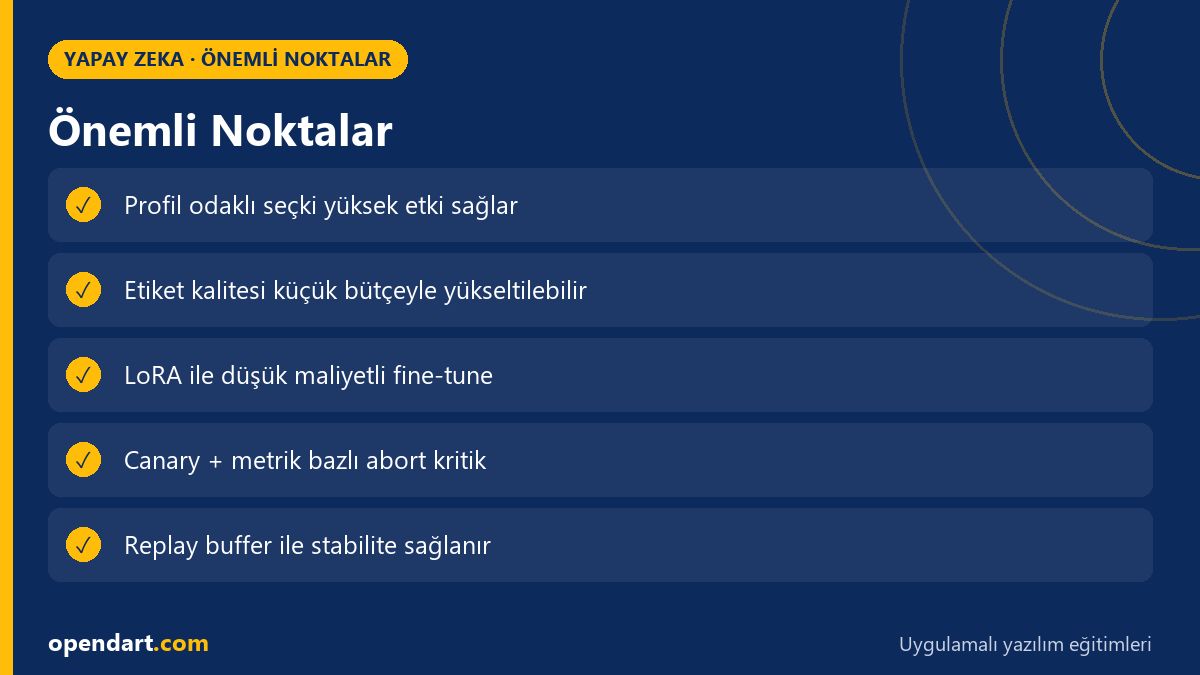
Profil odaklı veri seçimi, kullanıcı segmentleri veya hata türleri gibi hedef profillere göre örnekleri önceliklendirir. Hugging Face Datasets, Weights & Biases ve küçük SQL sorguları ile hangi kullanıcı senaryolarının model hatası ürettiğini sayısallaştırırsınız; bu sayede tüm veri havuzunu yeniden etiketlemeye gerek kalmaz.
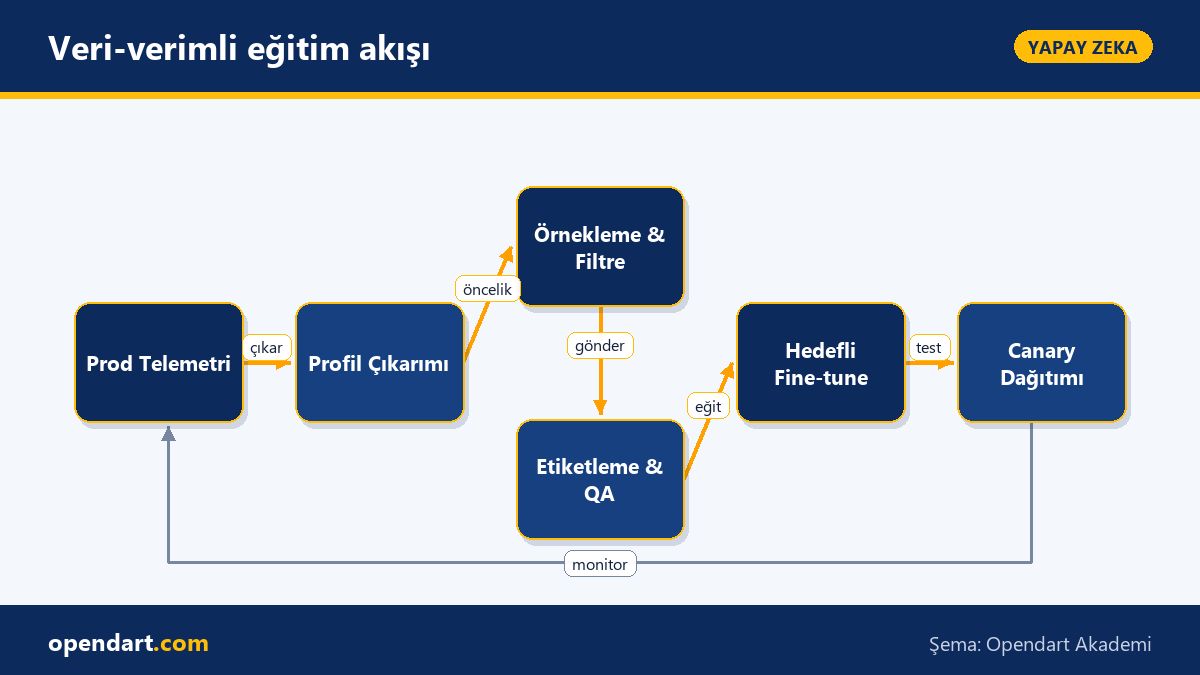
Mekanizma şu şekildedir: telemetri ve loglardan 'checkout-failure' veya 'autocomplete-mislead' gibi etiketler çıkarılır, her profi'l için hata sıklığı hesaplanır ve yüksek etki-cihaz kombinasyonları önceliklendirilir. Bu yaklaşım, aynı model kapasitesiyle daha hedefli iyileşme sağlar çünkü eğitim verisi modelin gerçek hata yüzeyini daha iyi örter.
Veri-verimli etiketleme ve kalite kontrol
Etiket kalitesi, sınırlı veriyle çalışan güncellemelerde belirleyicidir; Label Studio veya Prodigy ile kural tabanlı ilk atamayı yaptıktan sonra %10-20 oranında insan doğrulaması uygulamak maliyete karşı yüksek fayda sağlar. Çoğunluk oyu, uzman onayı ve 'etiket güven puanı' kombinasyonu ile düşük kaliteli örnekleri filtreleyin.
Active learning stratejileri -uncertainty sampling, disagreement sampling- ile eğitim bütçenizi en yüksek bilgi kazanımını sağlayan örneklerde harcayın. Bu, özellikle sınıf dengesizliği ve nadir hata türlerinde veri-verimliliği ciddi şekilde artırır.
Gerçek dünya senaryosu: e-ticaret kod tamamlayıcıda hata izolasyonu
Durum: Bir e-ticaret firmasında mobil uygulama için geliştirilen kod tamamlama modeli, ödeme akışında güvenlik uyarılarını yanlış yerleştiriyor; kullanıcı destek talepleri artıyor ve dönüşüm düşüyor. Problem, canlı trafik telemetrisiyle ilişkilendirildi: hatalar belirli tarayıcı-işlem kombinasyonlarında yoğunlaşıyordu.
Çözüm: 1) Telemetri ile kullanıcı profillerini çıkardık (tarayıcı, ödeme sağlayıcı, coğrafya), 2) hata oranı yüksek segmentlerden 3.000 örnek seçip güçlü etiketleme ve uzman incelemesi uyguladık, 3) model güncellemesini LoRA ile düşük öğrenme oranında yaptık ve canary dağıtımıyla %5 trafikle test ettik. Ölçülen sonuç: geri dönüşüm (regression) olmadan ödeme hata oranı %38 azaldı ve destek çağrıları %22 düştü.
Dağıtım, A/B testleri ve geri bildirim döngüsü
Güncelleme stratejinizde canary dağıtımı, otomatik metrikler (ör. end-to-end checkout başarısı) ve gözleme dayalı abort kriterleri olmalıdır. Kubernetes, Seldon Core veya BentoML ile model versiyonlarını yönetirken feature-flag tabanlı trafik yönlendirmesi ve prometheus/ELK ile izleme kurmak pratik bir yaklaşımdır.
Geri bildirim döngüsü için otomatik veri yakalama ile hata vakalarını etiketleyin ve her güncellemede küçük 'replay buffer' örnekleri kullanarak catastrophic forgetting riskini azaltın; ayrıca küçük canlı A/B deneyleriyle performans ve latansı ayrı ayrı ölçün.
İnce nüanslar, yaygın hatalar ve best practice
Edge case: tokenizasyon farklılıkları nedeniyle aynı kod parçası iki ortamda farklı şekilde kırılabilir; eğitim verinizi üretim tokenizer'ı ile preprocess edin ve test kümesinde encoding varyasyonlarını kapsayın. Etiket sürüklenmesi (label drift) için periyodik kalite kontrolleri ve veri zaman damgası bazlı split kullanın.
Best practice: küçük, hedefe yönelik fine-tune'larda LoRA/adapter yöntemleri kullanın, learning rate'i çok düşük tutun, ve eğitim setine her seferinde birkaç 'anchor' örnek ekleyerek performansın stabil kalmasını sağlayın. Aşağıda profil etiketine göre örnek filtreleyen basit bir veri filtrasyon kodu gösteriyorum; bu kod, seçimi otomatikleştirmeniz için temel bir şablon sunar.
Kod örneği: profil bazlı örnekleme (ufak, çalıştırılabilir)
Aşağıdaki kod, telemetri tabanlı profilleri filtreleyip Hugging Face Dataset formatına kaydeder; amaç yüksek hata oranlı profilleri hızlıca çıkarmak ve eğitim seti oluşturmak. Bu örnek, veri boyutunu küçültüp hedefli bir eğitim seti üretmenize yardımcı olur.
from datasets import Dataset

# Örnek olarak telemetri kayıtları
records = [
  {"id":1, "profile":"mobile-pay", "error_rate":0.12, "code":"..."},
  {"id":2, "profile":"desktop-search", "error_rate":0.01, "code":"..."},
  {"id":3, "profile":"mobile-pay", "error_rate":0.20, "code":"..."},
]

# Profil bazlı filtreleme
selected = [r for r in records if r["profile"]=="mobile-pay" and r["error_rate"]>0.1]

ds = Dataset.from_list(selected)
ds.to_json("selected_profile_samples.json")
Bu kod kısa ve odaklı tutuldu: veri kaynağınızın formatına göre kolayca uyarlanır ve Hugging Face Datasets ile entegrasyon, sonraki fine-tune adımlarını hızlandırır. Daha büyük üretim boru hatlarında bu filtrelemeyi veritabanı seviyesinde (SQL veya Spark) yapıp sonuçları batch olarak almanız ölçek açısından daha uygundur.
Bu konuyu neden öğrenmelisiniz?
Yazılım eğitimi alanında veri-verimli yaklaşımlar öğrenmek, maliyetleri kontrol altında tutarken hedeflenen iyileştirmeler sağlar; iş ilanlarında 'data-efficient fine-tuning' ve 'production ML' yetkinlikleri giderek daha çok talep görüyor.
Projeye katkısı somuttur: küçük, odaklı güncellemeler daha az regresyon riski, hızlı geri dönüş ve ölçülebilir iş değerleri (düşük hata oranı, azalan destek çağrısı) getirir; bu beceri ekip içinde hızla uygulanabilir ve ölçülebilir sonuç üretir.
Özet
- Profil odaklı örnekleme ile veri miktarını azaltıp etkiyi artırabilirsiniz.
- Etiket kalitesine küçük insan denetimleriyle büyük fayda sağlayın.
- LoRA/adapterlarla düşük maliyetli ve güvenli model güncellemeleri yapın.
- Canary dağıtımı ve otomatik metrikler ile regresyon riskini yönetin.
- Replay buffer ve anchor örnekleri catastrophic forgetting'i azaltır.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
yazılım eğitimi için en iyi etiketleme stratejisi nedir?
En iyi strateji katmanlıdır: otomatik kural tabanlı ilk etiketleme, ardından aktif öğrenme ile belirsiz örnekleri seçip insanla doğrulama; uzman onayı kritik ve küçük %10-20 kontrol örnekleri maliyet-fayda dengesi sağlar.
yazılım eğitimi maliyetini düşürmek için hangi veri-verimli teknikler etkili?
Profil odaklı örnekleme, active learning, LoRA/adapter tabanlı fine-tune ve replay buffer kombinasyonu en yüksek etkiyi sağlar; ayrıca etiket kalitesine yatırım kısa vadede büyük fayda verir.
yazılım eğitimi sırasında regresyonu nasıl önlersin?
Canary dağıtımı, otomatik abort kriterleri (işlevsel metrikler) ve anchor örneklerini eğitim setine ekleyerek; ayrıca versiyonlu izleme ile performansın her adımda karşılaştırılmasını sağlamak gerekir.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.