Kısıtlı veri ve bütçeyle model güncellemesi yaparken hangi örnekleri etiketleyeceğini bilmek kritik. Bu makale yazılım eğitimi için stratejik örnekleme, hata izolasyonu ve güvenli güncelleme adımlarını somut araçlarla anlatır.
Maliyet Odaklı Veri-Örneklemesi ile Yazılım Eğitimi: Etki ve Uygulama
Model güncellemelerinde bütün veriyi yeniden etiketlemek ya da yüksek maliyetli ek veri toplamak çoğu ekip için mümkün değil. Bu yazıda, yazılım eğitimi bağlamında hangi verinin en fazla değeri kattığını belirleme, hataları izole etme ve güvenli model güncelleme adımlarını somut araçlarla öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Yazılım eğitimi için Temel Prensipler: Veri-örnekleme ve etki ölçümü
Veri-örnekleme, modelin öğrenme sürecinde hangi örneklerin etikete veya yeniden gözden geçirmeye değer olduğunu belirler. Burada amaç, örneklerin model üzerindeki marjinal etkiyi nicel olarak tahmin etmek; bunun için per-sample loss, belirsizlik (entropy, margin), ve influence-function benzeri yaklaşımlar kullanılır.
Pratikte bu ölçümleri almak için PyTorch veya TensorFlow ile per-sample loss kayıtları alınabilir, scikit-learn ile stratified split uygulanabilir ve datasets (Hugging Face) ile veri kümeleri yönetilebilir. Bu ayrımlar, hangi veriyi öncelikle etiketleyeceğinizi ve hangisini sürümlemeye dahil edeceğinizi belirlemekte doğrudan işe yarar.
Stratejik Örnekleme: Kısıtlı veriyle maksimum kazanç
Stratejik örnekleme, rastgele seçimin yerine, veri dağılımını, model belirsizliğini ve iş ağırlığını (business-weight) birlikte kullanır. Örneğin e-ticaret için yanlış önerilerin verdiği zarar yüksekse o kullanıcı segmentlerinden daha fazla örnek seçmek mantıklıdır; bunu StratifiedShuffleSplit ve ağırlıklı örnekleme ile gerçekleştirebilirsiniz.
Basit adımlar:
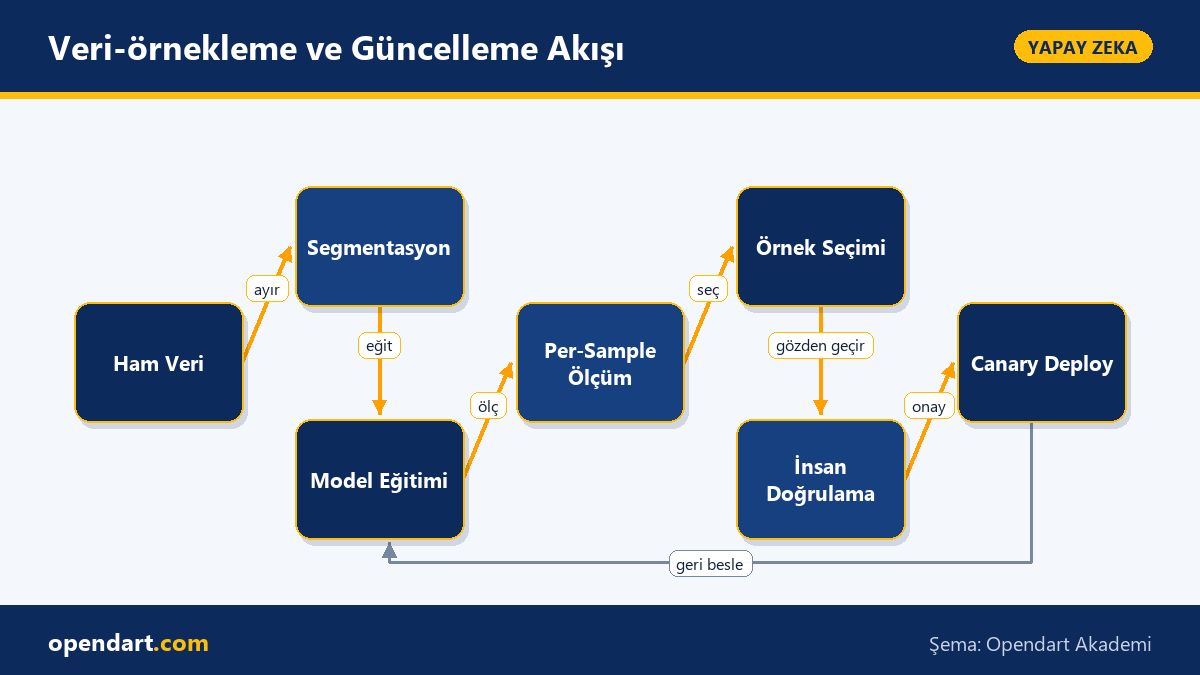
- Veri kümesini segmentlere ayır (cohort, ürün kategorisi, kullanıcı türü).
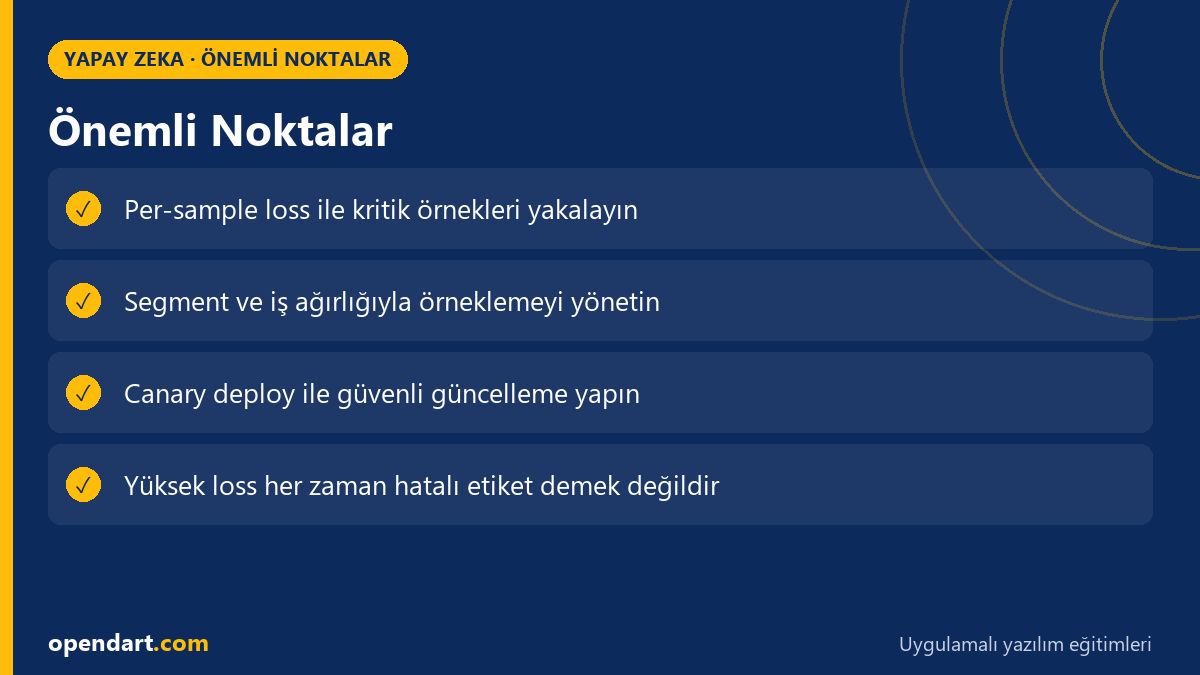
- Her segmentte belirsiz ve yüksek loss olan örnekleri önceliklendir.
- İş ağırlığını uygulayıp toplam bütçe kadar örnek seç.
Gerçek dünya senaryosu: E-ticarete özel kod öneri motoru
Durum: Orta ölçekli bir e-ticaret şirketinde kod tamamlama önerileri yanlış kategori etiketleri yüzünden müşteri şikayetleri alıyordu; her yanlış öneri satış kaybına ve destek maliyetine yol açıyordu. Ekip bütçesi sınırlı olduğundan tüm geçmiş veriyi yeniden etiketlemek mümkün değildi.
Çözüm: Segment bazlı örnekleme kuruldu - yüksek işlem hacmine sahip kategoriler ve sık iade alan ürün segmentleri önceliklendirildi; modelin en yüksek per-sample loss verdiği %5'lik küme insan tarafından gözden geçirildi; canary deploy ile yeni model küçük trafik dilimine açıldı. Ölçülen sonuç: doğruluk metriklerinde 2.5 puanluk artış, kritik yanlış öneri oranında %48 azalma ve destek başına ortalama maliyette belirgin düşüş gözlendi. Bu yaklaşım, sınırlı etiket bütçesiyle yapılan iyileştirmenin somut bir uygulamasıdır.
Uygulama örneği: Hata izolasyonu ve seçici yeniden etiketleme
Aşağıdaki küçük Python snippet'i, model eğitimi sonrası per-sample loss hesaplayıp üst yüzdeklikteki örnekleri seçer; bu örnekler insan doğrulamasına veya özel hata izolasyon kanalına gönderilir. Kod örneği basit tutuldu: model.forward ile loss hesaplama, pandas ile sıralama ve top-k seçimi yapılır.
Kod bloğu gösteriminden sonra neden böyle yazıldığı kısa: amaç karmaşık altyapıdan ziyade ideayı somut göstermek; gerçek üretimde batching, GPU verimliliği ve dağıtık metrik toplama eklenmelidir. Bu örnek, tek seferlik kontrol için hızlı bir araçtır ve otomasyona dönüştürülmesi kolaydır.
import torch
import pandas as pd

# logits ve labels model eğitimi sonrası elde edilmiş olsun
logits = torch.load('logits.pt')
labels = torch.load('labels.pt')
criterion = torch.nn.CrossEntropyLoss(reduction='none')
losses = criterion(logits, labels).detach().cpu().numpy()
df = pd.DataFrame({'id': range(len(losses)), 'loss': losses})
topk = df.nlargest(int(len(df)*0.05), 'loss')
topk.to_csv('to_review.csv', index=False)
İncelikler ve Yaygın Hatalar
Edge case: yüksek loss her zaman etiketsel hata anlamına gelmez; dağılımın ender görülen ama doğru örneklerini de içerebilir. Bu yüzden seçilen örnekleri mutlaka segmentlere göre analyse edip, yorumlayıcı özellikler (feature attributions) ile birlikte insan incelemesine göndermek gerekir.
Diğer hata: iş ağırlığı uygulanırken bias yaratmak. Örneğin yalnızca yüksek gelirli kullanıcı verisini önceliklendirirseniz model toplum standartlarını yansıtmayabilir. Bu nedenle iş hedefi ve adalet kriterlerini birlikte optimize eden çok kriterli seçim (multi-objective) uygulanmalı ve A/B testi veya canary dağıtımı ile gerçek trafik üzerinde doğrulama yapılmalıdır.
Bu konuyu neden öğrenmelisiniz?
Yazılım eğitimi süreçlerinde veri seçimi ve hata izolasyonu bilmek, sınırlı etiket bütçelerini en etkili şekilde kullanmanızı sağlar; ekipler genellikle bu yeteneği arar ve iş ilanlarında veri seçimi, model izleme veya aktif öğrenme tecrübesi talep edilir.
Projeye kattığı değer somuttur: daha az insan saatine ihtiyaç duyarak kritik hataları azaltır, canary ve A/B testlerle riskleri kontrol altında tutar ve böylece model güncellemelerini güvenli şekilde üretime almanıza olanak tanır.
Özet
- Stratejik örnekleme, rastgele seçimden daha yüksek getirir ve iş öncelikleriyle birleşmelidir.
- Per-sample loss ve belirsizlik metrikleri, hangi verinin gözden geçirilmesi gerektiğini gösterir.
- Gerçek dünya senaryosunda segment odaklı yeniden etiketleme kısa sürede ölçülebilir iyileşme sağlar.
- Hata izolasyonunda insan-in-the-loop ve canary dağıtımı riskleri düşürür.
- İş ağırlığı uygularken adalet ve bias kontrolünü unutmayın.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
Kısıtlı bütçeyle yazılım eğitimi için hangi örnekleme stratejisi en etkili?
İş ağırlığı, belirsizlik ve per-sample loss birleşimini kullanmak genelde en etkili yaklaşımdır; önce yüksek iş riskine sahip segmentlerden başlamak ve ardından model belirsizliğiyle incelemek pratikte iyi sonuç verir.
Yazılım eğitimi sürecinde yüksek loss tespit edilince ne yapmalıyım?
Yüksek loss olan örnekleri önce segmentlere ayırın, ardından feature attribution (SHAP/LIME gibi) ile neden yüksek loss aldığına bakın; etiketsel hata varsa insan doğrulamasına gönderin, değilse model kapasitesi veya veri çarpıklığı ihtimallerini değerlendirin.
Model güncellemesinde yazılım eğitimi için canary deploy nasıl uygulanmalı?
Yeni modeli küçük, temsil edici trafik dilimine (ör. %1-5) açın, kritik metrikleri (hata oranı, iş metrikleri) gerçek zamanlı izleyin ve geri dönüş toleransı aşılmazsa otomatik rollback mekanizması kullanın.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.