Pratik rehber: sorgu plan stabilizasyonu, database indexleme ve ölçülebilir veritabanı performans ayarlama adımları. Hem SQL eğitimi hem NoSQL eğitimi bağlamında uygulanabilir komut ve profil örnekleri içerir.
Veritabanı optimizasyonu: Plan stabilizasyonu, adaptif indeks ve ölçüm yöntemi
Sorgu plan stabilizasyonu: neden ve nasıl ölçülür
Plan stabilizasyonu, istatistik değiştikçe veya parametre dağılımı farklılaştıkça sorgunun beklenmedik planlar seçmesini engeller. Postgres'te pg_stat_statements ile bir sorgunun plan değişimini tespit etmek için önce pg_stat_statements uzantısını etkinleştirin ve en yüksek variance'ı olan sorguları listeleyin:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
SELECT queryid, query, calls, mean_time, stddev_time FROM pg_stat_statements ORDER BY stddev_time DESC LIMIT 10;Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.

Plan değişimini doğrulamak için EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) kullanın; farklı parametre setleriyle önce/sonra karşılaştırması alın. Örnek:
-- önce
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM orders WHERE customer_id = 12345;

-- belirli planı zorlamak için pg_hint_plan kullanıyorsanız
SET local pg_hint_plan.enable_hint = on;
-- veya belirli join tipi kapatabilirsiniz
SET LOCAL enable_nestloop = off;
EXPLAIN (ANALYZE, BUFFERS) SELECT * FROM orders WHERE customer_id = 12345;Neden: optimizer seçimini etkileyen faktörler cardinality tahminleri ve cost modelidir; parametreli sorgularda generic plan - custom plan farkı oluşur. SQL Server bağlamında benzer tespiti yaparken Query Store'u açıp plan değişikliklerini kaydedin:
ALTER DATABASE CURRENT SET QUERY_STORE = ON;
SELECT qs.query_id, MAX(rs.count_executions) AS execs, rs.last_execution_time
FROM sys.query_store_query_text qt
JOIN sys.query_store_query q ON qt.query_text_id = q.query_text_id
JOIN sys.query_store_plan p ON q.query_id = p.query_id
JOIN sys.query_store_runtime_stats rs ON p.plan_id = rs.plan_id
GROUP BY qs.query_id, rs.last_execution_time ORDER BY execs DESC;Database indexleme: adaptif, multicolumn ve bakım komutları
İndeks stratejisi oluştururken sorgu filtreleri, selectivity ve update yoğunluğunu birlikte değerlendirin. Postgres'te üretimde index eklerken downtime'ı azaltmak için CREATE INDEX CONCURRENTLY kullanın ve değişiklik sonrası pg_stat_user_indexes ile kullanım oranını kontrol edin:
CREATE INDEX CONCURRENTLY idx_orders_customer_created ON orders (customer_id, created_at DESC);
-- 24 saat sonra kullanım kontrolü
SELECT indexrelid::regclass AS index, idx_scan, idx_tup_read FROM pg_stat_user_indexes WHERE indexrelid::regclass = 'idx_orders_customer_created'::regclass;Fillfactor, page-level bloat ve rebuild stratejisi gibi bakım tercihleri verimi doğrudan etkiler. Örneğin yüksek update oranı olan tablo için fillfactor düşürün ve REINDEX veya pg_repack planlayın:
ALTER TABLE orders SET (fillfactor = 70);
-- reindex online alternatifi
pg_repack --table=public.orders --dbname=mydb --host=dbhost
-- SQL Server için fragmantasyon kontrolü
SELECT avg_fragmentation_in_percent FROM sys.dm_db_index_physical_stats(DB_ID('mydb'), OBJECT_ID('dbo.orders'), NULL, NULL, 'LIMITED');
ALTER INDEX ALL ON dbo.orders REORGANIZE; -- veya REBUILDEdge case: çok kolonu içeren indeksler (multicolumn) yanlış sırada tanımlanırsa kullanılmaz; sorgu planında index-only scan beklerken heap fetch görülüyorsa visibility map veya included columns eksikliği olabilir. Kontrol için EXPLAIN (ANALYZE, BUFFERS) kullanın ve index'in prefix-sorgularda kullanılabilir olmasına dikkat edin:
-- yanlış: (a, b, c) sorgu WHERE b=... OR c=...
-- doğru: gereksinime göre ayrı B-tree veya GIN/BRIN index'ler oluşturun
CREATE INDEX idx_orders_b ON orders (b);
CREATE INDEX idx_orders_c ON orders (c);
CREATE INDEX idx_orders_gin ON orders USING gin (jsonb_column jsonb_path_ops);
Profiling yöntemi: ölçülebilir adımlar, araçlar ve before-after karşılaştırma
Profiling yaparken önce hedef metriği netleyin: wall-clock süre, CPU ms, logical reads veya lock wait gibi. Postgres örneğinde bir sorgunun önceki ve sonraki durumunu karşılaştırmak için EXPLAIN ANALYZE ve psql \\timing kombinasyonunu kullanın:
-- ölçüm öncesi
\timing on
EXPLAIN (ANALYZE, BUFFERS) SELECT count(*) FROM orders WHERE status='paid';
-- indeks ekleme
CREATE INDEX CONCURRENTLY idx_orders_status ON orders (status);
-- ölçüm sonrası
EXPLAIN (ANALYZE, BUFFERS) SELECT count(*) FROM orders WHERE status='paid';
\timing offHangi aracı/nasıl kullanacağınız: Linux sunucuda perf/top/bcc (e.g. offcpu or hot functions) ve iostat/vmstat ile I/O beklemelerini ayırın; Postgres'te yoğun CPU mı yoksa I/O mı olduğunu anlamak için:
-- sistem düzeyi örnekler
sudo perf record -g -p  -- sleep 30
sudo perf report --stdio
sudo iostat -x 1 3
-- Postgres sorgu düzeyinde
SELECT * FROM pg_stat_activity WHERE state <> 'idle'; SQL Server için somut profil örneği: SET STATISTICS IO/TIME ile logical read ve CPU ölçümü alıp, Query Store ile plan değişimini gözleyin:
SET STATISTICS IO ON; SET STATISTICS TIME ON;
SELECT * FROM dbo.orders WHERE customer_id = 12345;
SET STATISTICS IO OFF; SET STATISTICS TIME OFF;
-- Query Store örneği
SELECT qsqt.query_sql_text, rs.avg_duration, rp.plan_id
FROM sys.query_store_query_text qsqt
JOIN sys.query_store_query q ON qsqt.query_text_id = q.query_text_id
JOIN sys.query_store_runtime_stats rs ON q.query_id = rs.query_id
JOIN sys.query_store_plan rp ON rs.plan_id = rp.plan_id
ORDER BY rs.avg_duration DESC;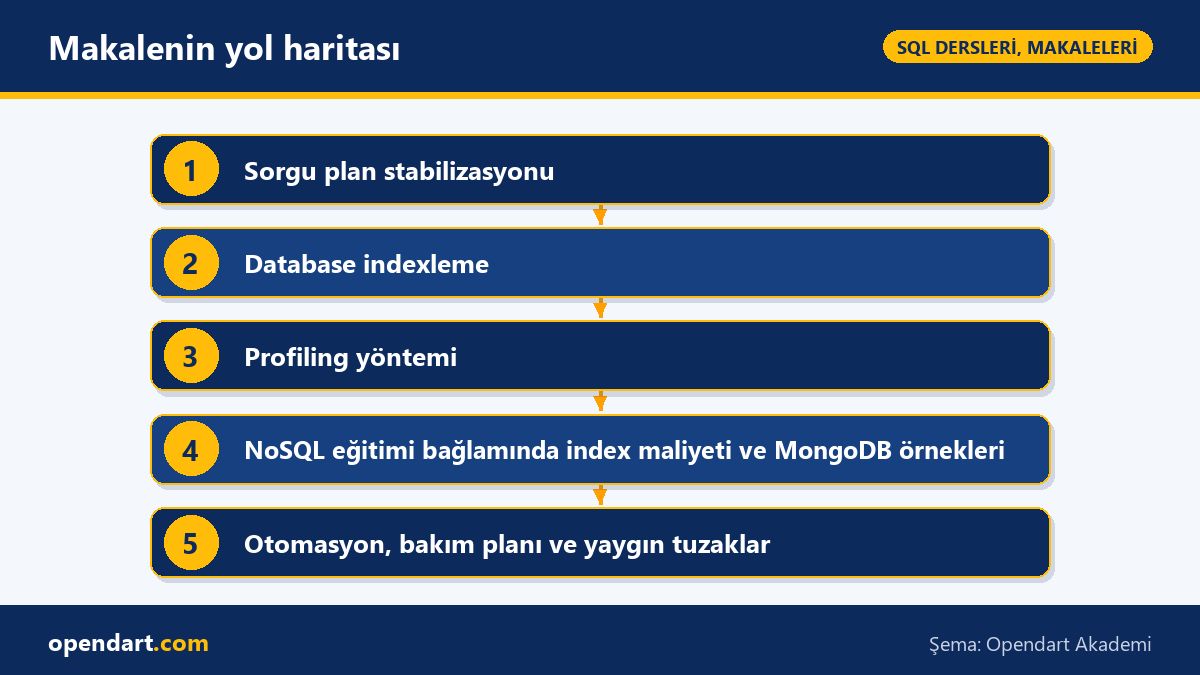
NoSQL eğitimi bağlamında index maliyeti ve MongoDB örnekleri
NoSQL veritabanlarında da indexler okuma hızını artırırken yazma maliyetini yükseltir; MongoDB'de write amplification ölçmek için profiler ve explain kullanın. Örnek: bir index oluşturup sonra yazma benchmark'ı çalıştırın ve writeLatency/ops değerini karşılaştırın:
-- index oluşturma
db.orders.createIndex({ customer_id: 1, created_at: -1 });
-- profiler açma
db.setProfilingLevel(2);
-- benchmark (örnek Node.js script veya mongoperf)
-- sonra profiler sonuçlarını incele
db.system.profile.find({ns: 'mydb.orders', op: 'insert'}).sort({ts:-1}).limit(20).pretty();
-- explain ile sorgu maliyeti
db.orders.find({customer_id: 12345}).explain('executionStats');Edge case: MongoDB'de çok sayıda küçük index'in toplam maliyeti bellek ve checkpoint süresini arttırır. Somut optimizasyon: compound index kullanarak read pattern'lerini birleştirin veya TTL index yerine periyodik mikro-batch temizleme tercih edin. Örneğin TTL ile beklenmedik arka plan silmeleri görüyorsanız dakika hassasiyeti isteniyorsa şöyle yapın:
-- TTL örneği
db.sessions.createIndex({ lastAccess: 1 }, { expireAfterSeconds: 3600 });
-- alternatif: uygulama tarafında cron ile temizleme
db.sessions.deleteMany({ lastAccess: { $lt: ISODate('2026-01-01T00:00:00Z') } });
NoSQL eğitiminde dikkat: explain('executionStats') size dönülen docs, totalKeysExamined ve totalDocsExamined sayıları verir; bunlar index etkinliğinin ölçülebilir metrikleridir. Sistematik ölçüm yapın: test dataset'i kullanarak A/B benchmark (index vs no-index) çalıştırın ve medyan latenceleri karşılaştırın.
Otomasyon, bakım planı ve yaygın tuzaklar
İndeks yaşam döngüsünü otomatikleştirmek için günlük/haftalık ölçüm tabanlı kararlar alın: örneğin 7 gün içinde idx_scan=0 olan indeksleri raporlayıp manuel inceleme isteği oluşturun. Postgres için örnek rapor sorgusu:
SELECT schemaname, relname, indexrelname, idx_scan, idx_tup_read, idx_tup_fetch
FROM pg_stat_user_indexes JOIN pg_index ON pg_stat_user_indexes.indexrelid = pg_index.indexrelid
WHERE idx_scan = 0 AND pg_relation_size(pg_stat_user_indexes.indexrelid) > 1024*1024;
-- bu çıktıyı cron job ile CSV'ye yazıp değerlendirinAutovacuum ve bloat: yoğun update/delete tablo için autovacuum parametrelerini ayarlayın ve bloat ölçümü yapın. Örnek param değişikliği ve ölçüm komutları:
# postgresql.conf değişikliği (örnek)
autovacuum_vacuum_scale_factor = 0.01
autovacuum_max_workers = 10
-- bloat tespiti (pgstattuple veya query)
SELECT schemaname, tablename, (pg_total_relation_size(relid) - pg_relation_size(relid)) AS bloat_bytes
FROM pg_catalog.pg_stat_user_tables ORDER BY bloat_bytes DESC LIMIT 10;Yaygın tuzak: sadece index sayısını artırmak yerine, sorgu patternlerini değiştirip uygulama tarafında sorgu şekillendirmeyi düşünün; örneğin IN (...) ile büyük liste kullanmak yerine temp table veya JOIN kullanmak daha stabil plan sağlar. Ölçü için örnek SQL Server pattern değişikliği:
-- kötü: WHERE id IN ( ... binlerce id ... )
-- alternatif: bulk insert to temp table
CREATE TABLE #ids (id INT PRIMARY KEY);
INSERT INTO #ids VALUES (1),(2),(3)...;
SELECT o.* FROM dbo.orders o JOIN #ids i ON o.id = i.id;
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
veritabanı optimizasyonu için önce hangi metriklere bakmalıyım?
Öncelik: sorgu wall-clock zamanı, CPU time, logical reads (Postgres: EXPLAIN ANALYZE BUFFERS ve pg_stat_statements), ve I/O bekleme (iostat). Somut adım: bir sorgu için EXPLAIN (ANALYZE, BUFFERS) çalıştırın ve psql ile \timing on kullanarak wall-time ile karşılaştırın; sistem seviyesinde sudo iostat -x 1 5 ve sudo perf record -p
database indexleme yaparken hangi durumlarda CREATE INDEX CONCURRENTLY tercih etmeliyim?
Canlı sistemde tabloya kilit vermemek için; Postgres'te büyük tabloya index eklerken CONCURRENTLY kullanın: CREATE INDEX CONCURRENTLY idx_name ON table(column); Ancak dikkat: CONCURRENTLY sırasında aynı index tekrar oluşturulamaz ve işlem uzun sürerse rollback riskine karşı izleme gerektirir. İş akışı: index oluştur, 24 saat sonra pg_stat_user_indexes ile idx_scan kontrol et, sonra eski indeksleri temizle.
sql server eğitimi kapsamında plan gerilemesini hızlıca nasıl tespit ederim?
Query Store'u açın ve top regressions raporlarını kullanın; hızlı tespit için önce SET STATISTICS IO/TIME ON ile sorgu ile ilgili logical reads ve CPU ölçün, sonra Query Store'dan plan_id bazlı avg_duration ve executions karşılaştırmasını alın. Somut komutlar: ALTER DATABASE CURRENT SET QUERY_STORE = ON; sonra sys.query_store_runtime_stats sorgularını çalıştırın.
nosql eğitimi alıyorum: MongoDB'de indexlerin yazma maliyetini nasıl ölçerim?
MongoDB profiler ve explain('executionStats') ile ölçün. Adımlar: db.setProfilingLevel(2); benchmark yazma yükünü çalıştırın (ör. mongoperf veya kendi scriptiniz), sonra db.system.profile.find({op: 'insert'}) ile gecikme ve I/O örneklerine bakın. Ayrıca index eklemeden/sonra aynı benchmark'ı çalıştırıp ops/s ve write latency değerlerini karşılaştırın.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.