Bu makale veritabanı optimizasyonu ve database indexleme üzerine odaklanır; SQL Server ve NoSQL örnekleriyle sorgu hızını ölçme, indeks stratejisi ve veritabanı performans ayarlama adımlarını açıklar.
Veritabanı optimizasyonu: Pratik database indexleme ve performans taktikleri
Sorgu gecikmeleri ve artan veri hacmi pek çok uygulamada kullanıcı deneyimini bozar; bu makalede database indexleme ve veritabanı optimizasyonu ile bu dar boğazları nasıl tespit edip düzelteceğinizi öğreneceksiniz. Hem SQL (SQL Server, PostgreSQL) hem de NoSQL (MongoDB) bağlamında uygulanabilir adımlar ve ölçümler yer alacak.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Database indexleme nasıl çalışır ve neden önemlidir
İndeksler disk üzerindeki ham veriye doğrudan erişimi azaltarak belirli sorguların I/O ve CPU maliyetlerini düşürür; B-tree, hash ve columnstore gibi fiziksel yapıların nasıl çalıştığını bilmek gerekir. SQL Server, PostgreSQL gibi ilişkisel sistemlerde B-tree en yaygınıdır, MongoDB ise ikincil indekslerle benzer kavramı uygular.
Mekanizma olarak indeks, sütun değerlerinin düzenlenmiş bir kopyasını tutar ve sorgu planlayıcısı bu yapıya erişerek satır taramasını (table scan) atlayabilir; bununla birlikte indeksin seçiciliği (selectivity) ve kapsayıcılığı (covering) sorgu hızını doğrudan etkiler. Yanlış indeksleme, write amplification ve sık bakım ihtiyacı doğurur; bu yüzden veritabanı optimizasyonu stratejisi yalnızca indeks oluşturmak değil, uygun izleme ve bakım politikası kurmaktır.
Sorgu seviyesinde veritabanı performans ayarlama ve SQL Server ipuçları
Sorgu planını incelemek, doğru indeksleme kararlarının temelidir; SQL Server'da Query Store ve SET STATISTICS IO/TIME gibi araçlarla plan değişikliklerini ve maliyetleri ölçersiniz. Planlar parametre sniffing, cardinality estimate hataları veya eksik istatistikler yüzünden bozulabilir; bunları düzeltmek için istatistik güncelleme ve gerekli durumlarda plan stabilizasyonu uygulayın.
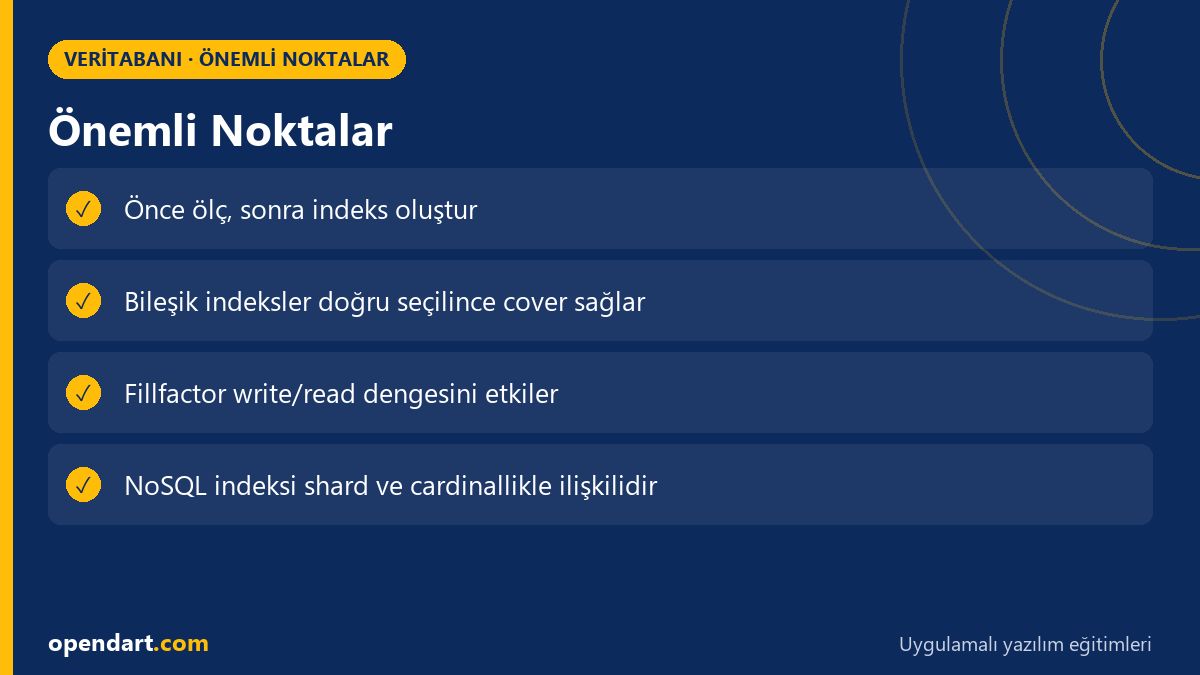
Aşağıda, sık kullanılan bir bileşik (composite) indeksin SQL Server'da nasıl oluşturulacağına dair kısa bir örnek ve oluşturma seçenekleri gösterilmiştir. Öncesinde ne yaptığınızı ve neden bu seçenekleri seçtiğinizi iki cümleyle açıklıyorum: bu indeks örneği, sık kullanılan filtre-sıralama kombinasyonunu kapsayacak şekilde sütunları sıralı tutar ve FILLFACTOR ile write/read dengesini kontrol eder.
Bu kod bloğu bir bileşik indeks oluşturur; INCLUDE ile cover index sağlanır, FILLFACTOR write-amplification ve page-splitting dengesini yönetir. Aşağıdaki yapı küçük bir tablo üzerinde test edilecek bağlantı modelini yansıtacak şekilde seçilmiştir.
CREATE INDEX IX_Orders_CustomerDate
ON dbo.Orders (CustomerId ASC, OrderDate DESC)
INCLUDE (TotalAmount, Status)
WITH (FILLFACTOR = 80, ONLINE = ON);
GO
Bu örnekte FILLFACTOR=80 write yoğunluğu olan tablolar için page doluluğunu azaltır ve ONLINE işlemi kesinti olmadan rebuild imkanı verir; test ve izleme sonrası bu değeri iş yüküne göre ayarlayın. İndeks oluşturduktan sonra Query Store ile eski ve yeni planları karşılaştırın ve p95/p99 gecikme farklarını ölçün.
Gerçek dünya senaryosu: E-ticaret arama gecikmesinin çözülmesi
Durum: Orta ölçekli bir e-ticaret platformunda ürün aramalarında p95 gecikme 1.2s iken artan kullanıcı sayısı ile 2s'ye çıktı; sorgular çoğunlukla müşteri filtreleri, kategori ve tarih aralığına göre çalışıyordu. Ek olarak arama sonuçları için sort by relevance ve createdAt kombinasyonu yaygındı, bu da tarama maliyetini artırıyordu.
Uygulanan çözüm: Öncelikle sorgu profili çıkartıldı (slow query log, Query Store), ardından en sık kullanılan filtre-sıralama kombinasyonları için bileşik indeks ve cover indexler oluşturuldu; eski büyük tablo partitioning ile zaman tabanlı parçalandı. Ayrıca Redis cache ile sık tekrar edilen arama kalıpları önbelleğe alındı ve arama sonuçlarının sıralanması için precomputed score sütunu eklendi.
Sonuçlar: İndeks ve partitioning sonrası p95 sorgu gecikmesi ortalama 450ms'e düştü (%60 azalma) ve CPU kullanımında düşüş görüldü; disk I/O read/sec ölçümlerinde belirgin gerileme oldu. Önemli olan, değişikliğin ölçümlerle doğrulanması (p95, p99, CPU, IO, transaction log büyümesi) ve rollback planının hazır olmasıydı.
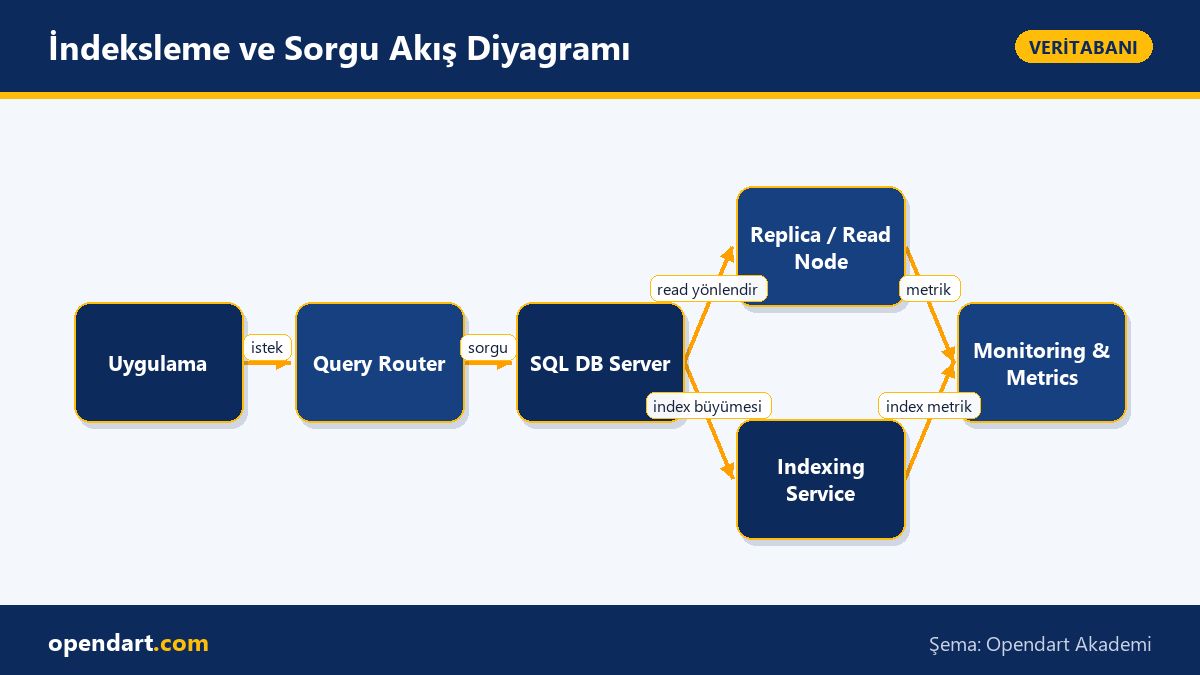
NoSQL indexleme ve mixed workload senaryoları için pratikler
NoSQL sistemleri (örneğin MongoDB) farklı bir indeks davranışı sergiler: secondary indexler document store yapısına uygun şekilde çalışır ve sharding ile birleşince index seçimi daha kritik hale gelir. NoSQL eğitiminde (nosql eğitimi) bu farkların anlaşılması önemlidir; örneğin MongoDB'de çok büyük dizinler shard anahtarının uygun seçilmemesi durumunda hotspot oluşturur.
Aşağıda MongoDB üzerinde sık kullanılan bir bileşik indeksin nasıl tanımlandığı gösterilmiştir; öncesinde kısa açıklama: bu indeks customerId ve status ile aramalarda kullanılır, createdAt ile de sıralamayı destekler; background oluşu üretim sırasında bloklamaz. Oluşturmanın ardından neden böyle yazıldığını açıklıyorum: bileşik sıra, sorgu filtre-sıralama kombinasyonuna uygun seçildiği için index intersection'a gerek kalmayacak ve sorgu tek indeksten servis alacak.
db.orders.createIndex(
  { customerId: 1, status: 1, createdAt: -1 },
  { name: "ix_orders_cust_status_createdAt", background: true }
);
Bu indeks, sorguların tek bir indeksten tatmin olmasını hedeflerken background=true üretim kesintisini azaltır; shardlı kümede shard anahtarınızı ve index boyutunu dikkatle değerlendirin. NoSQL ortamında izleme (mongotop, mongostat, Atlas monitoring veya Prometheus) ile index kullanımını takip edin.
İleri seviye incelikler, yaygın hatalar ve bakım best practice'leri
Edge case 1 - Selectivity tuzağı: Çok düşük seçiciliğe sahip (örneğin boolean veya çok az farklı değere sahip) bir sütun üzerine indeks koymak genellikle fayda vermez; optimizer bazen index'i atlayıp full scan seçer. Bunun yerine filtered/partial index veya composite index tasarımı ile selectivity artırılabilir.
Edge case 2 - İndeks bakımı: Rebuild vs Reorganize kararını I/O, downtime ve fragmentation seviyesine göre verin; SQL Server'da PAGE_VERIFY seçenekleri ve fillfactor etkileşimi, transaction log büyümesini doğrudan etkiler. Ayrıca update statistics politikası ve otomatik istatistik güncellemelerinin iş yükünüzü nasıl etkilediğini test edin.
Yaygın hata - Parameter sniffing: Parametreli sorgular farklı dağılımlarda kötü planlara neden olabilir; SQL Server'da OPTIMIZE FOR, RECOMPILE veya plan rehberleri ile müdahale edilebilir ama bunları kullanmadan önce plan maliyetlerini ölçün. Son olarak indeksleme kararlarını verirken her zaman A/B testleri, benchmarklar ve üretim benzeri veriyle yapılan testleri tercih edin.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu ve database indexleme becerisi, yazılım mühendisliği ilanlarında sıkça aranan bir yetkinliktir; ayrıca uygulama gecikmelerini düşürerek doğrudan kullanıcı deneyimi ve iş hedeflerine katkı sağlar.
Hem SQL (sql eğitimi, sql server eğitimi) hem de NoSQL (nosql eğitimi) perspektifinde çalışabilmek, farklı veri modelleri ve ölçeklendirme gereksinimlerine doğru çözümler tasarlamanızı sağlar ve ekip içinde teknik liderlik fırsatlarını artırır.
Özet
- İndeksler sorgu maliyetini düşürür ama yanlış indeks write maliyetini artırır.
- Önce sorgu profili çıkarın, sonra en sık kullanılan filtre-sıralamaya göre indeks oluşturun.
- SQL Server ve MongoDB gibi sistemlerde izleme araçlarını kullanarak etkiyi ölçün.
- Selectivity, fillfactor ve istatistiklerin kararları nasıl etkilediğini bilin.
- Değişiklikleri mutlaka p95/p99 ve IO/CPU metrikleri ile doğrulayın.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
database indexleme nasıl yapılır en iyi uygulamalar nelerdir?
Önce sorgu profili çıkarın, sık kullanılan filtre-sıralama kombinasyonlarını tespit edin, bileşik ve cover indexlerle sorguyu tatmin edecek şekilde indeks oluşturun; sonra etkisini p95/p99 ile ölçün ve bakım politikası belirleyin.
sql server eğitimi için hangi konu başlıklarına odaklanmalıyım?
Query tuning, Query Store, index yapıları, istatistik yönetimi, parameter sniffing ve index bakım adımları (rebuild/reorganize) konularına öncelik verin; bunlar veritabanı performans ayarlama için doğrudan faydalıdır.
veritabanı performans ayarlama yaparken hangi metriklere bakmalıyım?
p95/p99 sorgu gecikmeleri, CPU kullanımı, disk I/O (read/sec, write/sec), wait türleri (IO, LCK), transaction log büyümesi ve indeks fragmentasyon oranları temel metriklerdir.
nosql eğitimi alırken indeksleme farkları nelerdir?
NoSQL'de indeksler doküman yapısına ve shard politikasına göre farklı etki gösterir; secondary indexlerin shard anahtarıyla etkileşimi, index boyutu ve background build seçenekleri NoSQL odaklı konulardır.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.