Bu makale, veritabanı optimizasyonu ve veritabanı performans ayarlama için adaptif indexleme stratejilerini anlatır; SQL ve NoSQL ortamlarda ölçülebilir iyileşme adımlarını öğrenirsiniz.
Gerçek Zamanlı İş Yükleri İçin Akıllı Database Indexleme ve Ayarlama
Canlı uygulamalarda karmaşık sorgular zamanla performans darboğazı yaratır; yanlış veya eksik indexleme hem gecikme hem de yazma maliyeti getirir. Bu yazıda sorgu sıcaklığına dayalı önceliklendirme, index bakım politikaları ve pratik SQL/EXPLAIN örnekleriyle ilk adımı atmayı öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Neden adaptif indexleme? Veritabanı optimizasyonu perspektifi
Adaptif indexleme, sabit bir indeks kütüphanesi yerine çalışma zamanındaki sorgu desenlerine göre önceliklendirme yapar; bu yaklaşım veritabanı optimizasyonu sırasında hem disk kullanımını hem de plan seçimini iyileştirir. PostgreSQL'de pg_stat_statements, SQL Server'da Query Store veya MongoDB Profiler gibi araçlarla gerçek sorgu sıcaklığı ölçülür.
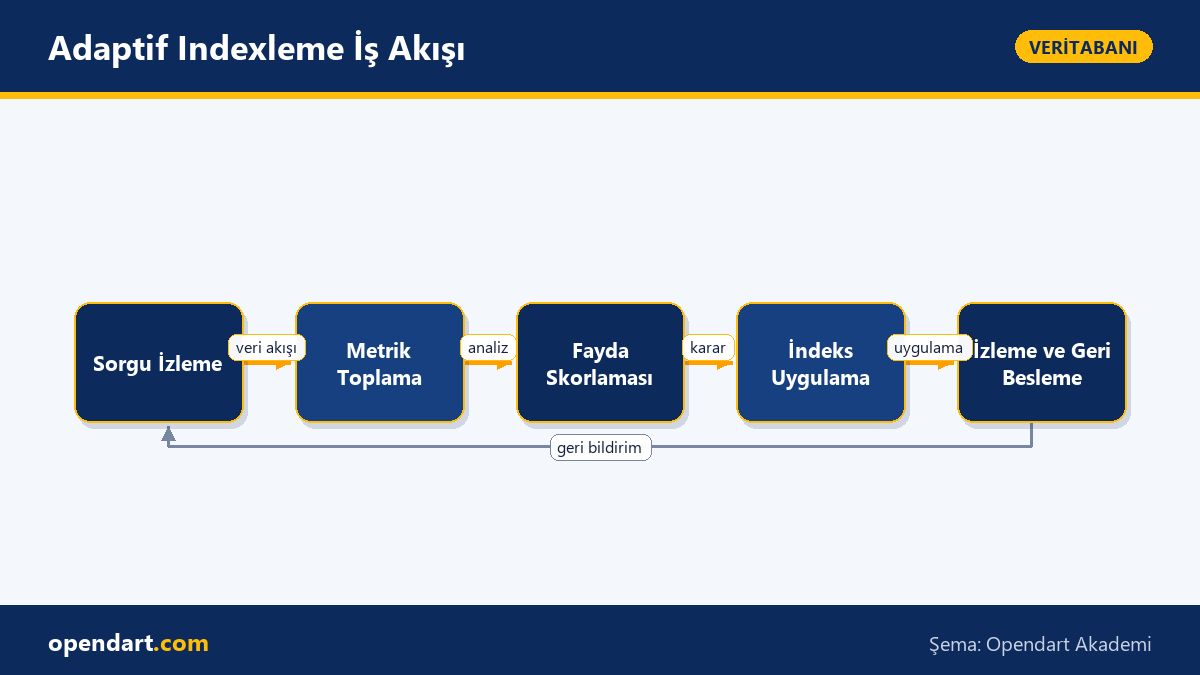
Mekanik olarak adaptif strateji üç adım içerir: (1) gözlem - sorgu frekans ve maliyetlerini topla, (2) değerlendirme - kümülatif fayda/zarar analizi yap, (3) uygulama - seçilen indeksleri oluştur ya da bakım parametrelerini değiştir. Bu döngü, özellikle melez OLTP/OLAP iş yüklerinde veri erişim yollarının hızla değiştiği ortamlarda önem kazanır.
Sorgu sıcaklık analizi ve index önceliklendirme
Sorgu sıcaklığı (hotness) ölçümü sadece sorgu sayısı değil, CPU süresi, satır tarama ve I/O maliyetlerini birleştirir; örneğin bir sorgu çok sık çalışıyor ama düşük maliyetliyse düşük öncelikli, az sıklıkta ama çok maliyetliyse yüksek öncelikli olabilir. Bu yüzden metrikleri normalize edip fayda skorları üretmek gerekir.
Pratik olarak fayda skoru = (ortalama_ms * çağrı_sayısı) - (index_create_cost + yazma_maliyeti) şeklinde kaba bir hesapla başlanabilir; burada index_create_cost hem CPU/I/O hem de uygulama kilitlenmelerini içerir. SQL Server Query Store veya PostgreSQL pamuklarıyla bu skoru zaman serisi olarak takip etmek ve threshold'lar belirlemek sürdürülebilir bir yol sağlar.
Gerçek dünya senaryosu: E-ticaret ödeme akışı
Bir e-ticaret platformunda ödeme onayı raporları gece işleme sırasında 10 dakikadan uzun sürüyordu; aynı tablo OLTP istekleri sırasında da küçük, hızlı sorgularla kullanılıyordu. Sorun: tek bir genel indeks çok geniş bir tablo taraması üretiyor, ek indeksler ise yazma gecikmesini artırıyordu.
Çözüm: sorgu sıcaklığına göre iki katmanlı strateji uygulandı - ödeme raporları için partitioning ve columnstore benzeri OLAP indeksleri, canlı ödeme onayları için ise hedeflenmiş dar bir B-tree indeksi. Ölçüm: gece raporlama süresi yaklaşık 3 kat hızlanırken, ödeme onaylarının p99 latenci artışı ölçülebilir düzeyde kalındı (yüzde bazında tek haneli). Bu sonuç, veritabanı performans ayarlama sürecinde ölçüm ve geri dönüşün kritik olduğuna dair somut bir örnek sundu.
İndeks oluşturma ve bakım: kısa pratik SQL örnekleri
Aşağıdaki örnek PostgreSQL'de hedeflenmiş bir indeks oluşturur; CONCURRENTLY canlı sistemlerde kilitlenmeyi azaltır ve WHERE filtreli indeks yalnızca sık kullanılan durumları hedefler. Ayrıca WITH (FILLFACTOR=70) seçeneği yazma maliyetini düşürmek için sayfa doluluğunu ayarlar.
Bu kod bloğu bir ödeme tablosu için örnek indeks oluşturur; satır satır okunabilir olması için her SQL ifadesi ayrı satır halinde gösterildi.
CREATE INDEX CONCURRENTLY
idx_orders_payment_completed
ON orders (payment_status, created_at DESC)
WHERE payment_status = 'completed'
WITH (FILLFACTOR = 70);

-- alternatif: gerektiğinde toplam tutarı sorguda hızlı getirmek için include
CREATE INDEX CONCURRENTLY
idx_orders_payment_inc
ON orders (payment_status)
INCLUDE (total_amount);
Neden böyle yazıldı: CONCURRENTLY canlı veritabanlarında DML kilitlenmelerini azaltır; filtreli indeksler disk ve bakım maliyetini düşürür; INCLUDE ile index-only scan şansını artırır.
İleri incelikler: plan stabilizasyonu, yazma maliyeti ve edge case'ler
Index eklemek çoğu zaman sorguyu hızlandırırken yazma tarafında amplifikasyon yaratabilir; özellikle yüksek hattaki INSERT/UPDATE oranlarında fillfactor, pad_index ayarları ve index rebuild politikaları önem kazanır. Ayrıca veritabanı optimizasyonu sırasında plan stabilizasyonu (plan forcing veya baselines) ile değişen planlardan kaynaklanan regresyonlar önlenebilir.
Sık karşılaşılan bir edge case: histogramların bozulması nedeniyle selectivity yanlış tahmin edilip kötü plan seçilmesi; bu durumda manuel ANALYZE, per-partition statistics veya daha sık istatistik güncellemesi çözüm sunar. Aşağıda bir sorgunun planını ölçmek için kullanılabilecek kısa bir EXPLAIN örneği yer alıyor; bu çıktıyı zaman içinde karşılaştırarak plan stabilizasyonu ihtiyacını belirleyebilirsiniz.
Aşağıdaki EXPLAIN komutu PostgreSQL'de sorgunun gerçek maliyet ve I/O profilini verir; çıktıyı saklayıp farklı indekslerle karşılaştırmak faydalıdır.
EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT user_id, SUM(total_amount)
FROM orders
WHERE payment_status = 'completed'
AND created_at >= now() - interval '7 days'
GROUP BY user_id
ORDER BY SUM(total_amount) DESC
LIMIT 100;
Neden böyle yazıldı: ANALYZE gerçek çalışma zamanını, BUFFERS I/O kullanımını gösterir; böylece hangi indeksin fayda sağladığını nicel olarak ölçebilirsiniz.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu ve database indexleme bilgisi, performans sorunlarını kökünden çözerek sistem maliyetlerini düşürür ve daha güvenilir SLA sağlamaya yardımcı olur; iş ilanlarında operasyonel veritabanı deneyimi, özellikle SQL Server eğitimi veya NoSQL eğitimi geçmişi, sık talep edilen bir beceridir.
Kariyer açısından, bu beceriler yüksek trafikli uygulamalarda çözüm üretebilme yeteneği kazandırır; projelere somut değer olarak gecikme azalışı, daha az altyapı maliyeti ve güvenilir raporlama getirir, bu da sizi ekip içinde teknik lider konumuna taşıyabilir.
Özet
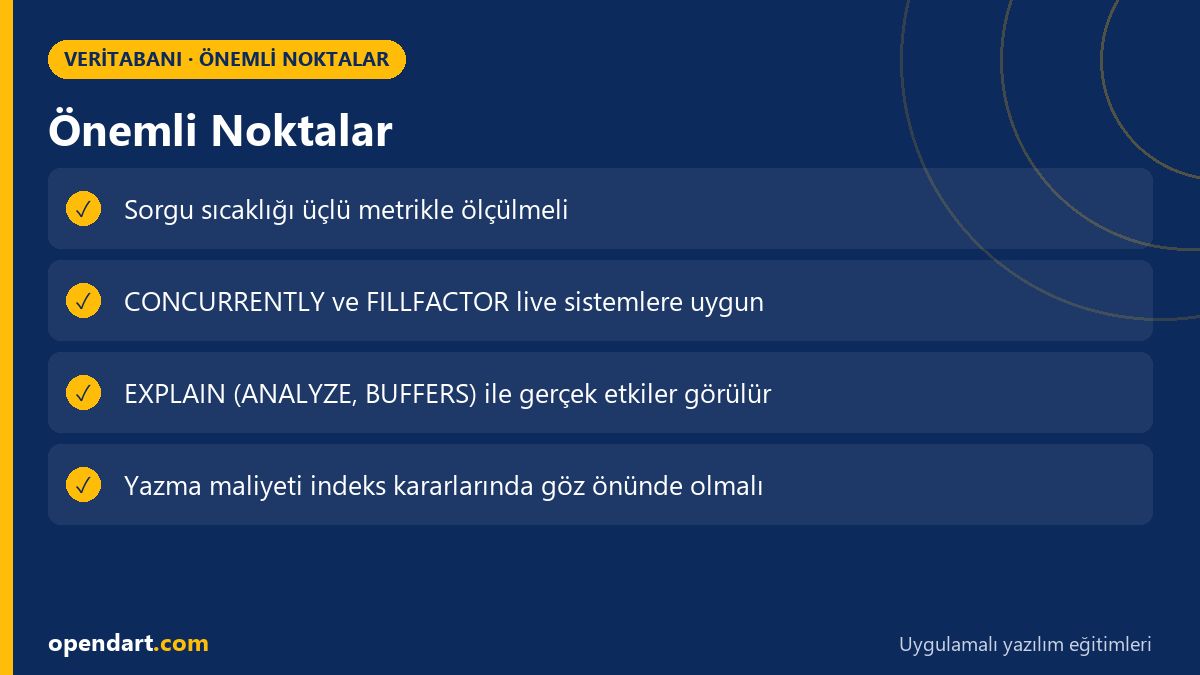
- Adaptif indexleme sorgu sıcaklığına dayalı önceliklendirme ile daha etkili çalışır.
- Sorgu fayda skoru oluşturmak ölçülebilir karar almayı sağlar.
- Filtreli ve INCLUDE indeksler disk ve okuma maliyetini azaltır.
- Plan stabilizasyonu ve istatistik yönetimi edge case'leri önler.
- Ölçüm yapmadan indeks değişiklikleri yapmak regresyona yol açabilir.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
database indexleme nasıl yapılır, ilk adım nedir?
İlk adım sorgu ve planları toplayıp analiz etmektir; sık çalışan ve yüksek maliyetli sorguları tespit edip, fayda/zarar analizi yaparak filtreli veya INCLUDE sütunlu indekslerle başlamalısınız.
SQL Server performans ayarlama için hangi metriklere bakmalıyım?
Query Store'ta sorgu süresi, logical reads, CPU zamanı ve plan değişiklikleri; ayrıca blocking/swait ve disk I/O metrikleri size plan regresyonları ve indeks fayda maliyetini gösterir.
NoSQL eğitimi alırken index stratejisi ne kadar önemli?
NoSQL sistemlerinde indexler veri modeline doğrudan etki eder; örneğin MongoDB'de doğru compound index seçimi read perfomansını dramatik biçimde artırırken yanlış index yazma ve depolama maliyetlerini yükseltir, bu yüzden pratik nosql eğitimi sırasında index örnekleri üzerine çalışılmalı.
veritabanı performans ayarlama sırasında en sık yapılan hata nedir?
En sık hata tek seferlik hız kazanımı için indis ekleyip yazma maliyetini göz ardı etmektir; her indeks değişikliğinin hem okuma hem yazma maliyetini ölçerek uygulanması gerekir.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.