Bu makale veritabanı optimizasyonu ve database indexleme konularında pratik adımlar sunar; hem SQL hem NoSQL örnekleriyle sorgu performansını anlamanızı sağlayacak bir rehberdir.
Veritabanı optimizasyonu için pragmatic database indexleme ve sorgu taktikleri
Çoğu projede yavaş sorgular ve artan maliyetler veritabanı optimizasyonu ihtiyacını doğurur. Bu yazıda database indexleme, SQL ve NoSQL pratikleri ve ilk adımları nasıl atacığını anlatacağım.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Veritabanı optimizasyonu: indekslerin nasıl çalıştığı
İndeksler bir tabloyu yeniden düzenlemezler; veriye erişim yolunu kısaltırlar. B-tree tabanlı indeksler sık kullanılan arama, aralık filtreleri ve sıralamalar için uygundur; columnstore ise analitik yüklerde verinin sıkıştırılmasını ve I/O'yu azaltmayı hedefler.
Neden önemli? Yanlış indeks seçimi ekleme ve güncelleme maliyetini artırır, sorgu planlarında regresyona yol açar. Bu yüzden veritabanı performans ayarlama sürecinde önce ölçüm, sonra indeksleme yapmak gereklidir: EXPLAIN, SET STATISTICS IO veya veritabanının sunduğu sorgu planı araçlarını kullanın.
Pratik database indexleme: sql server eğitimi örneği
Aşağıdaki örnek sık kullanılan müşteri bazlı zaman aralığı sorgusu için oluşturulmuş bir nonclustered indeks gösterir. Öncesinde hangi sütunların filtre ve sıralama için kullanıldığına bakmak, gereksiz kolonları indeksin dışında tutmak maliyeti düşürür.
Bu kod bloğu bir SQL Server ortamında izlenebilecek basit bir indeks oluşturma ve sorgu örneğidir. İndeks oluşturduktan sonra UPDATE STATISTICS ile istatistikleri yenilemek plan stabilitesi için iyi bir başlangıçtır.
-- Index: customer için tarih bazlı arama hızlandırma
CREATE NONCLUSTERED INDEX IX_Orders_CustomerDate
ON dbo.Orders (CustomerId, OrderDate)
INCLUDE (TotalAmount);
-- İstatistikleri güncelle
UPDATE STATISTICS dbo.Orders;
-- Bu sorgu indeksten faydalanmalı
SELECT OrderId, TotalAmount
FROM dbo.Orders
WHERE CustomerId = @cid AND OrderDate >= @fromDate
ORDER BY OrderDate DESC;
Bu yapı, sık filtrelenen alanları ön plana çıkarır ve sorgunun full table scan yapmasını önler. Ancak çok fazla INCLUDE sütunu eklemek güncellemeleri ağırlaştırır; ihtiyaca göre ölçüm yaparak ilerleyin.
NoSQL eğitimi: MongoDB ve hibrit index stratejileri
NoSQL veritabanlarında indexleme kavramı farklıdır: belge tabanlı sistemde birden fazla alan için compound index oluşturmak okunma verimliliğini arttırırken yazma maliyetini yükseltebilir. MongoDB gibi sistemlerde arama ve sıralama alanlarını birlikte indekslemek sık kullanılan bir taktiktir.
Aşağıdaki örnek MongoDB'de müşteri ve tarih ile sorgulanacak koleksiyon için arka planda indeks oluşturur ve sorgunun nasıl kullandığını gösterir. Arka plan indeksleme üretim sırasında kısa kesintiler olmadan indeks oluşturur.
db.orders.createIndex(
  { customerId: 1, orderDate: -1 },
  { name: "cust_date_idx", background: true }
);
// Bu sorgu index kullanmalı
db.orders.find({ customerId: ObjectId("...") }).sort({ orderDate: -1 }).limit(20);
NoSQL sistemlerde indeksleme stratejisi uygulama tarafı sorgu desenlerine göre şekillenir; sık kullanılan sorguları profilleyip yalnızca ihtiyaç olan alanları indekslemek yazma performansını korur.
Gerçek dünya senaryosu: e-ticaret sipariş raporlama
Durum: Orta ölçekli e-ticaret uygulamasında günlük sipariş raporları ve müşteri bazlı sorgular gece artan CPU ve I/O ile yavaşlıyordu. Sorgular hem OLTP hem OLAP görevleri nedeniyle sık sık full scan yapıyordu ve raporlama penceresi genişledi.
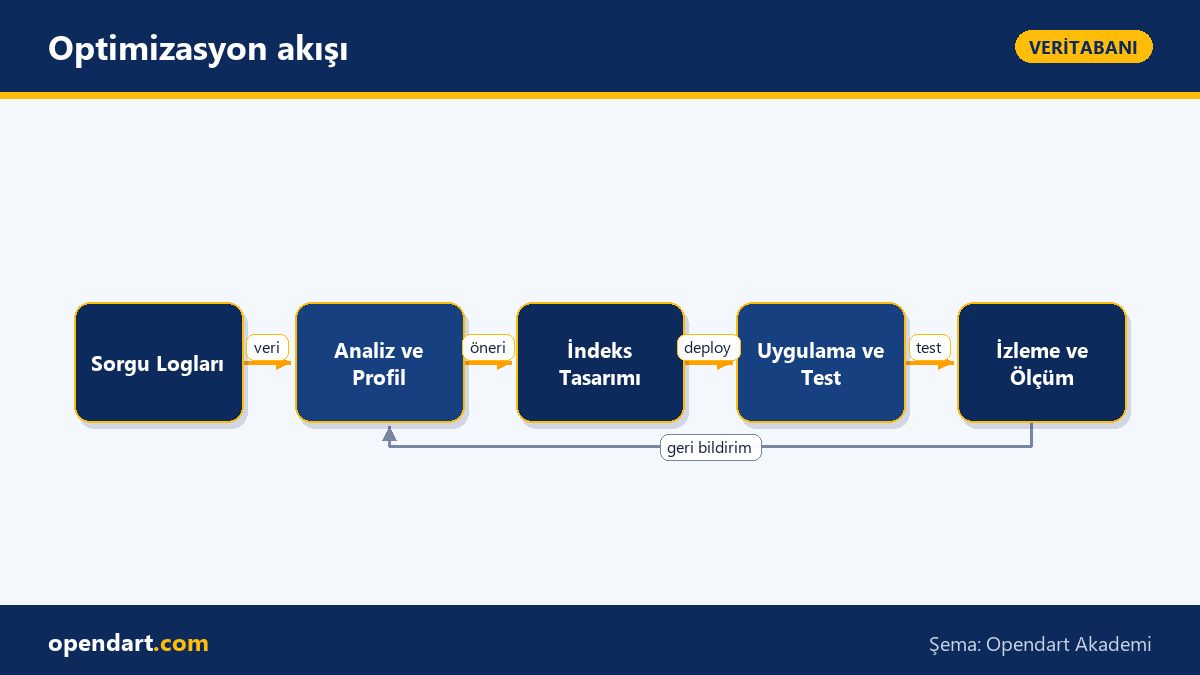
Çözüm: İlk adım olarak sorgu logları ve EXPLAIN çıktıları toplandı, en çok kullanılan filtreler belirlendi; ardından sipariş tablosuna compound indeksler ve columnstore tabanlı özet tablolar eklendi. Ayrıca sorgu planlarını gözlemlemek için otomatik bir izleme aracı devreye alındı.
Sonuç: En ağır raporlama sorgularında I/O %70 düştü, raporlama penceresi 4 saatten 45 dakikaya indi ve normal müşteri işlemlerinin gecikmesi ölçülebilir biçimde azaldı. Bu tür bir taşıma planı, veritabanı optimizasyonu çalışmalarının ölçülebilir değer üretmesinin tipik örneğidir.
İnce detaylar, yaygın hatalar ve performans tuzakları
Edge case: Parameter sniffing SQL Server'da tutarsız planlara neden olabilir; tek bir iyi parametre tüm çalışma sürecini bozabilir. Bunun için 'optimize for unknown', plan rehberleri veya parametrik varyasyonlar kullanmak gerekebilir.
Yaygın hata: Indexing yaparken sadece sorguları hızlandırmaya odaklanıp yazma maliyetini göz ardı etmek. Büyük DELETE/UPDATE işlemlerinde toplu indeks güncellemeleri I/O patlamasına neden olabilir; bunları parçalara bölerek veya bakım zamanında yapmak daha güvenlidir.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu ve database indexleme bilgisi, büyük veri ve mikroservis projelerinde gecikmeleri azaltarak kullanıcı deneyimini korur; iş ilanlarında performans iyileştirme deneyimi sıkça aranan bir yetenektir.
SQL eğitimi veya nosql eğitimi altyapısına hakim olmak projede maliyet tasarrufu sağlar, sorgu maliyetlerini düşürür ve ölçeklenebilir mimariler kurmanıza yardımcı olur.
Özet
- İndeksler veri erişimini hızlandırırken yazma maliyetini artırabilir; ölçümle karar verin.
- Sorgu planlarını
EXPLAINve yerel araçlarla analiz etmek başlangıçtır. - SQL Server ve MongoDB gibi sistemlerde indeks stratejisi farklılıkları vardır; sorgu desenine göre optimizasyon yapın.
- Gerçek dünya ölçümleri (I/O, CPU, süre) optimizasyonun etkisini gösterir.
- Parameter sniffing ve istatistik yönetimi gibi ince ayarları ihmal etmeyin.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
veritabanı optimizasyonu nasıl yapılır en hızlı başlangıç?
Önce ağır sorguları tespit edin, EXPLAIN veya soru planı araçlarıyla darboğazı bulun; ardından hedeflenmiş indeks ve istatistik güncellemeleri ile başlayın. Ölçüm yapmadan değişiklik uygulamayın.
database indexleme ne zaman zararlı olabilir?
Çok sayıda, geniş INCLUDE sütunu olan veya nadiren kullanılan indeksler yazma maliyetini yükseltir ve depolama gereksinimini büyütür; sık güncellenen tablolarda gereksiz indekslerden kaçının.
sql server eğitimi kapsamında indexlerin bakımı nasıl yapılır?
İndeks fragmentasyonunu düzenli kontrol edip, gerektiğinde reorg veya rebuild planlayın; istatistikleri periyodik olarak güncelleyin ve büyük bakım işlerini off-peak zamanlara taşıyın.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.