Bu makale yazılım eğitimi için veri seçimi, etiket kalitesi ve model güncellemelerinde uygulanabilir, veri-verimli yöntemleri açıklar; gerçek bir e-ticaret senaryosunda ölçülebilir iyileşmeler gösterir.
Veri-verimli Yaklaşımla Yazılım Eğitimi: Profil, Etiket ve Güncelleme
Çoğu projede kaliteli veri eksikliği, model güncellemelerini geciktirir ve maliyeti yükseltir. Bu makalede yazılım eğitimi için veri-verimli seçim, etiket kalitesi yönetimi ve güvenli güncelleme adımlarını öğrenip ilk adımı atabileceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Yazılım eğitimi için veri boru hattı mimarisi ve işleyişi
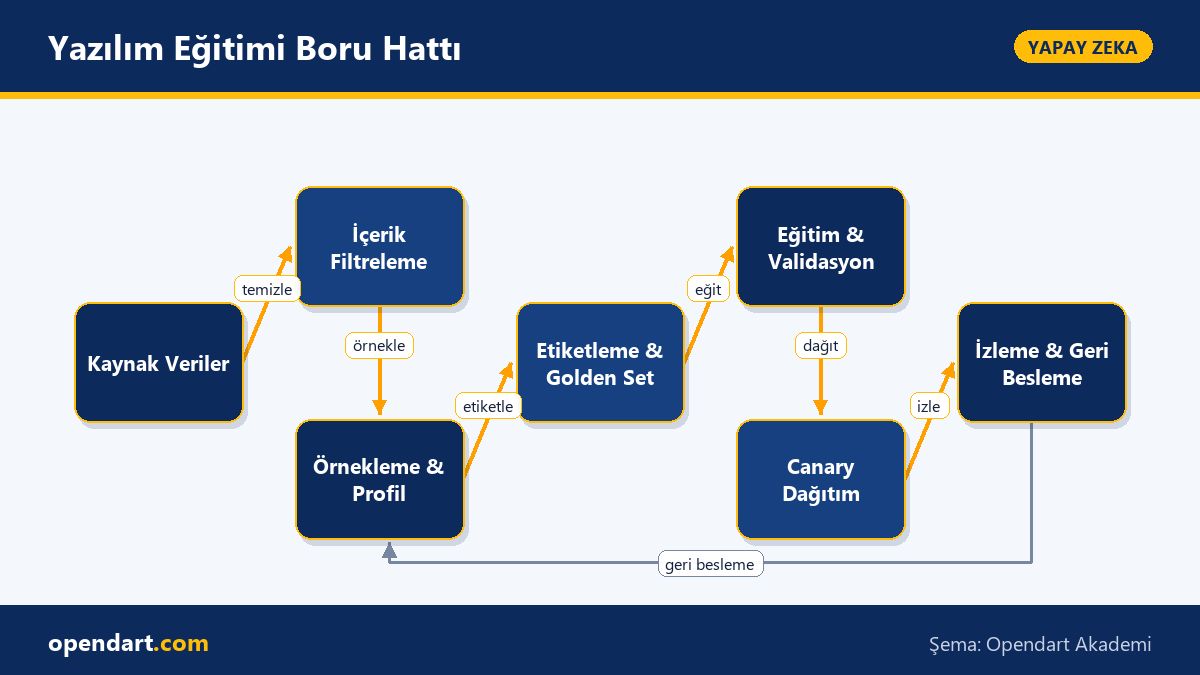
Yazılım eğitimi boru hattı temel olarak dört aşamaya ayrılır: kaynak veri toplama, veri ön işleme ve etiketleme, eğitim/validasyon ve dağıtım/izleme. Kaynaklarda Git commit mesajları, test sonuçları, hata kayıtları ve kullanıcı etkileşimleri bulunur; bunlar Kafka veya bulut depolarıyla toplanıp Airflow veya Prefect ile zamanlanır.
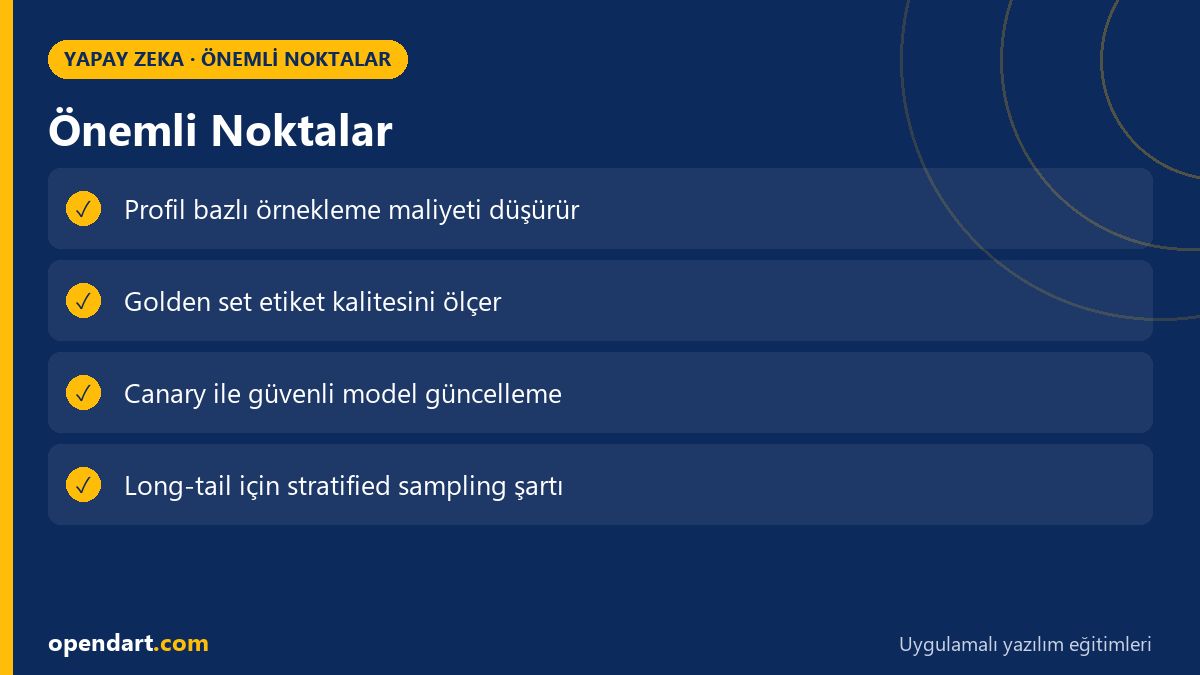
Neden bu katmanlı yapı önemli? Çünkü doğru ayrıştırma ve profil bazlı örnekleme (örneğin kullanıcı yeteneği, modul ağırlığı, hata tipi) veri maliyetini düşürür ve modelün gerçek kullanım dağılımına odaklanmasını sağlar. Özellikle dbt ile veri kalitesi testleri, Feast ile özellik servisi ve Prometheus ile model performans metrikleri entegrasyonu doğrudan üretim güvenilirliğini artırır.
Veri seçimi, örnekleme ve etiket kalitesi - yazılım eğitimi yaklaşımı
Etiket kalitesi somut ölçülerle yönetilmelidir: annotator tutarlılığı, disagreement oranı ve golden set doğruluğu gibi. Örnekleme stratejileri olarak stratified sampling, uncertainty sampling ve profil bazlı reservoir sampling kullanılabilir; her biri farklı maliyet-fayda dengesi sunar.
Örneğin 'uncertainty sampling' düşük güven skoruna sahip örnekleri önceliklendirir; fakat uzun kuyruk (long-tail) davranışlarını kaçırabilir. Bu nedenle pratikte uncertainty sampling ile stratified sampling kombinasyonu kullanmak, hem sık görülen hatalara hem de nadir ama kritik edge case'lere odaklanmayı sağlar.
Gerçek dünya senaryosu: e-ticaret için kod yardım asistanında veri-verimli yazılım eğitimi
Bir e-ticaret şirketi, depo entegrasyon kodu üretiminde geliştirici asistanı kullanıyordu; önerilerin kabul oranı %42, yanlış öneri oranı %18 ve ortalama düzeltme süresi 4.2 saat idi. Maliyetleri düşürmek ve doğruluğu artırmak için ekip profil odaklı veri seçimi, etiket şablonları ve canary güncellemesi uyguladı.
Uygulanan çözümler: 1) commit, test-failure ve son-kullanıcı geri bildirimlerinden hedefli örnekleme; 2) annotator için net etiket yönergeleri ve golden set; 3) canary dağıtım + otomatik geri çekme kuralları. Sonuç: yanlış öneri oranı %18 -> %6, kabul oranı %42 -> %54 ve ortalama düzeltme süresi 4.2saat -> 2.9saat; etiketleme maliyeti sabit kalırken model güncelleme sıklığı arttı ve regresyonlar erken yakalandı.
Bu senaryoda kritik inceliklerden biri uzun kuyruk fonksiyon isimleri ve şirket içi kütüphanelerdi; stratified sampling ile her modül için minimum örnek garantisi koymak, asistanın nadir paketleri de öğrenmesini sağladı.
Model güncelleme, hata izolasyonu ve güvenlik uygulamaları
Güncelleme sürecinde A/B ve canary dağıtımı, hata izolasyonu için vazgeçilmezdir. Canary'de küçük bir kullanıcı yüzdesine yeni ağı dağıtıp error rate, kabul oranı ve yol açılan yeni hata sınıfı sayısını izlersiniz; eşiğin aşıldığı durumda otomatik rollback tetiklenir. Gerçek zamanlı izleme için Sentry, Prometheus ve uygun iş akışıyla anormallik tespiti kurmak önemlidir.
Veri güvenliği ve PII filtresi uygulamaları yazılım eğitimi için zorunludur: commit mesajları veya hata kayıtları PII taşıyorsa pipeline başında redaction ve hashing yapılmalı, ayrıca eğitim verisinden kaldırma taleplerini otomatik işleyen bir 'right to be forgotten' akışı olmalıdır.
Aşağıdaki küçük Python doğrulama snippet'i, eğitim setinde her profil için minimum örnek sayısı sağlandığını kontrol eden basit bir kalite kontrol örneğidir. Bu kodu pipeline'ın doğrulama adımına ekleyebilirsiniz.
profiles = {"frontend": 120, "backend": 80, "infra": 30}
min_required = {"frontend": 100, "backend": 75, "infra": 50}
for p, count in profiles.items():
    if count < min_required[p]:
        print(p + ': eksik örnek - ' + str(min_required[p] - count) + ' eksik')
    else:
        print(p + ': tamam')
Yukarıdaki kod kısa ve açıklayıcıdır; pipeline içinde çalıştırılması hem eksik profil tespitini hem de otomatik uyarı üretimini sağlar. Gerçek projelerde bu kontrolün loglanması ve alert eşiğinin işletilmesi gerekir.
Edge case'ler, yaygın hatalar ve uygulanabilir best practice'ler
Deneyimli ekiplerin bile sık yaptığı hata, sadece yüksek frekanslı örneklere odaklanıp long-tail hataları ihmal etmektir. Bunu önlemek için stratified sampling ile profil bazlı minimum kontenjan, ayrıca zaman içinde kaymaya karşı drift detection uygulanmalıdır.
Diğer bir incelik, etiketleyici sapmasıdır: annotator drift'ini engellemek için periyodik golden set sınavları, blind overlap incelemeleri ve disagreement logları tutulmalıdır. Ayrıca model güncellemeleri deterministik olmayabilir; rastgeleliği sabitlemek (seed), eğitim kayıtlarını versiyonlamak ve reproducibility testleri yapmak üretim riskini azaltır.
Bu konuyu neden öğrenmelisiniz?
Yazılım eğitimi alanında veri-verimli yöntemleri bilmek, daha az maliyetle daha hızlı model döngüleri sağlar; iş ilanlarında 'data-centric ML' ve 'MLops' yetkinlikleri artan talep görmektedir.
Projeye kattığı somut değerler: daha düşük etiket maliyeti, daha kısa zamanlı model güncellemeleri ve azaltılmış regresyon riski; bu da ürün güvenilirliğini ve geliştirici verimliliğini artırır.
Özet
- Veri boru hattını katmanlara ayırmak güvenilirlik ve izlenebilirlik sağlar.
- Profil odaklı ve karma örnekleme uzun kuyruk hataları yakalar.
- Etiket kalitesi golden set ve overlap incelemeleri ile korunur.
- Canary dağıtımı ve otomatik rollback üretim riskini azaltır.
- Basit veri doğrulamaları pipeline'da erken hata yakalar.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
Yazılım eğitimi için hangi etiket kalite metrikleri en önemlidir?
Öncelikle annotator tutarlılığı, disagreement oranı ve golden set doğruluğu izlenmelidir; bunlar etiketlerin güvenilirliğini doğrudan gösterir ve hatalı öğrenmeyi azaltır.
Yazılım eğitimi boru hattında canary dağıtımı nasıl uygulanır?
Canary dağıtımı küçük bir kullanıcı segmentine yeni modeli açmak, belirlenmiş metriklerde anormallik görülürse otomatik rollback yapmak ve sonuçları izleme panosunda karşılaştırmakla uygulanır; Sentry ve Prometheus gibi araçlar ile ölçümler otomatik hale getirilmelidir.
Yazılım eğitimi için veri-verimli örnekleme nasıl başlatılır?
Önce kullanım dağılımını çıkarın, sonra profil kriterlerini (modül, hata tipi, kullanıcı yeteneği) tanımlayıp stratified ve uncertainty sampling kombinasyonu ile küçük bir pilot küme eğitip sonuçları ölçün; eksik profiller için minimum kontenjan belirleyin.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.