Kısıtlı veriyle güvenli, hedefe yönelik model güncellemeleri nasıl yapacağınızı öğrenin; bu makale profil tabanlı veri seçimi, küçük güncellemeler ve izleme adımlarını yazılım eğitimi bağlamında adım adım açıklar.
Veri-Verimli Güncellemelerle Yazılım Eğitimi: Profil Odaklı Boru Hattı
Birçok ekip büyük veri beklerken, yazılım eğitimi projelerinde sıkça az ve gürültülü veriyle karşılaşırsınız. Bu makalede profil odaklı, veri-verimli bir güncelleme boru hattı kurmayı, yaygın hatalardan kaçınmayı ve ilk üretim denemenizi nasıl yapacağınızı öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Neden veri-verimli yöntemler yazılım eğitimi için önemli
Yazılım eğitimi projelerinde her zaman geniş etiketli veri bulunmaz; özel domainler, gizlilik kısıtları veya kullanıcı profilleri nedeniyle veri sınırlıdır. Veri-verimli yöntemler, hedefli örnekleme, ince ayar stratejileri (LoRA/PEFT gibi) ve düzenli değerlendirme ile daha küçük veri kümelerinden anlamlı iyileştirme sağlar.
Mekanizma basittir: profil tabanlı örnekleme ile modelin en çok hataya düştüğü mikroskobik alt-kümelere odaklanırsınız; ardından düşük maliyetli parametre güncellemeleri ile bu hata dağılımını azaltırsınız. Gerçek araçlar olarak Hugging Face Datasets, PyTorch/Transformers, veri versiyonlama için DVC veya Delta Lake ve izleme için Prometheus/Grafana sıklıkla kullanılır.
Profil - Veri - Güncelleme: pratik boru hattı adımları
Bu bölüm boru hattının nasıl işlediğini adım adım açıklar: (1) Kullanıcı/koruma profilleri oluşturma, (2) Veri ayıklama ve etikete göre örnekleme, (3) Küçük, hedefli güncellemeler (LoRA/adapter), (4) A/B değerlendirme ve gözetim. Her adımın başarı ölçütleri açıkça tanımlanmalı; örneğin "sürüş edilen hata türü başına öneri kabul oranı" gibi bir metrik belirleyin.
Aşağıdaki kısa komut dizisi, veri seçimi ve küçük güncelleme iş akışının kabaca nasıl tetiklendiğini gösterir. Önce hangi profilde veri olduğuna göre filtrelenir, sonra küçük bir LoRA güncellemesi uygulanır, ardından değerlendirme çalıştırılır.
python collect.py --dataset raw_logs.json   --profile security_sensitive   --out selected_subset.json

python preprocess.py --input selected_subset.json   --format hf_dataset --out hf_subset

python train_lora.py --dataset hf_subset   --adapter_size 64 --steps 500 --out model_lora.pt

python evaluate.py --model model_lora.pt --metric suggestion_accept_rate
Gerçek dünya senaryosu: SaaS kod inceleme platformu
Durum: Bir SaaS şirketi, takım içi kod inceleme önerileri sunan bir asistan kullanıyor; ancak orta ölçekli müşterilerde öneri kabul oranı düşük ve bazı müşteride gizlilik endişeleri var. Toplam veri az, hatalar spesifik kod tarzlarına bağlı (örn. async kullanım desenleri) ve model tüm müşterilere aynı ağırlığı veriyordu.
Çözüm: Müşteri profillerini (kod stili, dil karışımı, güvenlik hassasiyeti) çıkarıp, her profile özgü hata dağılımını hesapladılar; en sık hatayı üreten 3 profile odaklanarak her biri için küçük LoRA güncellemeleri yaptılar. Değerlendirmede A/B testi uygulayıp öneri kabul oranını izlediler.
Sonuçlar: 8 haftalık uygulamada hedeflenen profiller için öneri kabul oranı ortalama %72'den %88'e yükseldi; yanlış pozitif öneriler %40 azaldı çünkü örnekleme ve etiketleme süreçleri profile özel temizlendi. Ayrıca model güncellemeleri küçük kaldığı için maliyet artışı sınırlı oldu ve gizlilik talepleri için müşteri ayırımı sağlandı.
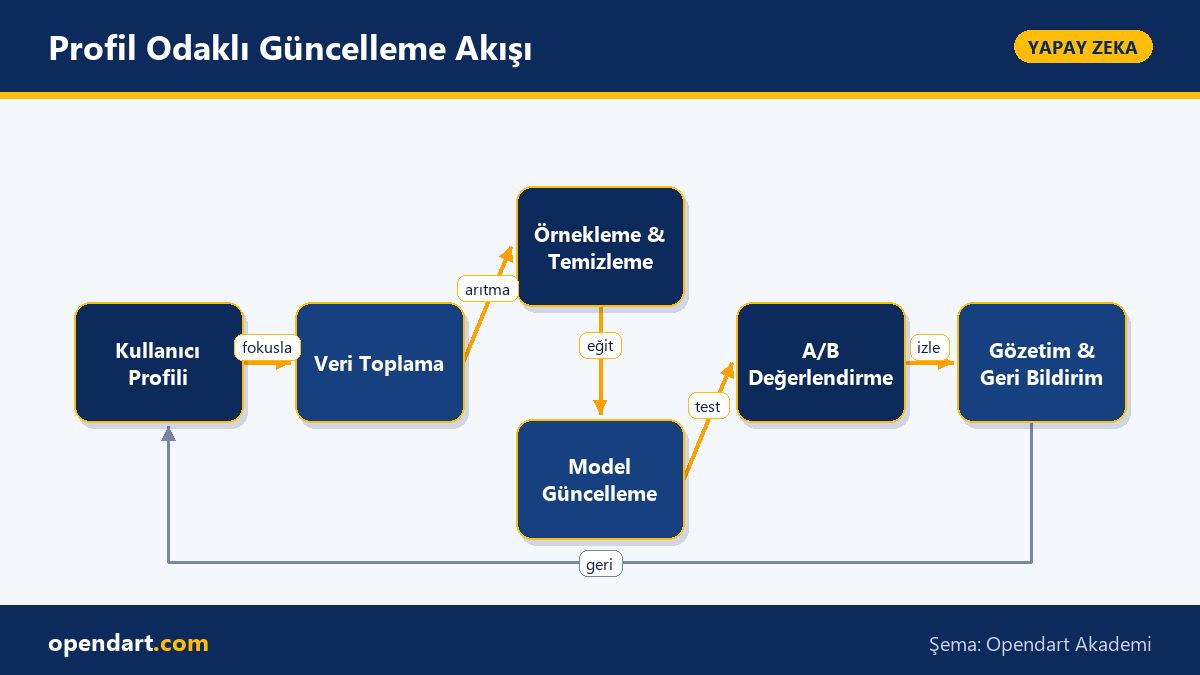
İncelikler ve yaygın hatalar - deneyimli mühendislerin dikkat etmesi gerekenler
Etiket sızıntısı (label leakage) en sık rastlanan hata: eğitime dahil ettiğiniz örnekler değerlendirme havuzuyla çakışırsa başarı yanıltıcı olur. Bunu önlemek için profil bazlı sabit bir holdout seti oluşturun; veri fingerprinting (örnek hash'leri) ve zaman damgası kontrollü ayırma kullanın.
Başka bir incelik: küçük güncellemelerde hatalı öğrenme (catastrophic forgetting) riski vardır; bunun için kademeli güncellemeler, replay örnekleri veya konservatif optimizasyon (küçük öğrenme oranı, gradient clipping) uygulayın. Ayrıca, model sürümlerini izole ederek kanal bazlı geri alma (rollback) stratejisi hazırlayın.
İlk 30 gün: uygulamaya başlamak için pratik plan
İlk hafta: veri keşfi ve profil çıkarımı - logları, hata etiketlerini ve müşteri metriklerini analiz edin; ikinci hafta: güvenilir küçük bir alt-küme seçip manuel etiket doğrulaması yapın; üçüncü hafta: hedefli LoRA/adapter güncellemesi deneyin ve dördüncü hafta: A/B test ile kullanıcı etkisini ölçün.
Aşağıdaki örnek, hızlı bir değerlendirme çalıştırması için minimal komut seti gösterir; amaç hızlı geri bildirim alıp ölçülebilir bir metrik (ör. suggestion_accept_rate) yakalamaktır.
# Hızlı değerlendirme
python evaluate.py   --model base_model.pt   --dataset hf_test_subset   --metric suggestion_accept_rate   --output eval_report.json

# Sonuçları oku ve yüzde değişimi hesapla
eval_report.json
Bu konuyu neden öğrenmelisiniz?
Yazılım eğitimi alanındaki bu beceriler, sınırlı veriyle etkili model iyileştirme yapabilme yeteneği sağlar; şirketler özel domainlere hızlı adapte olabilen modeller arıyor ve iş ilanlarında "domain adaptation", "fine-tuning" veya "LoRA/adapter" deneyimi talep ediliyor.
Pratikte bu bilgi, maliyetleri düşük tutarken müşteri memnuniyetini artırır: hedefli güncellemelerle yanlış öneriler azalır, geri alma riski düşer ve ekipler daha kısa sürede somut değer üretebilir.
Özet
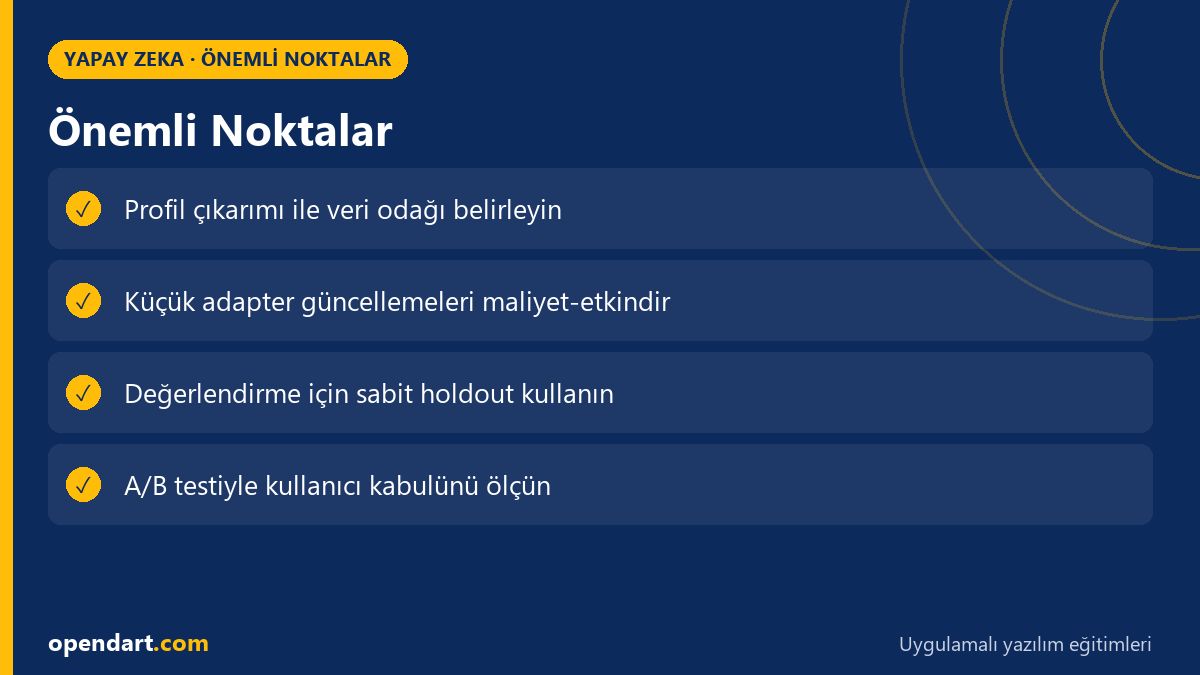
- Profil bazlı örnekleme küçük veriyle etkili iyileştirme sağlar.
- Küçük, hedefli güncellemeler (LoRA/adapter) maliyetleri kontrol eder.
- Holdout ve fingerprinting ile değerlendirme sızıntısından kaçının.
- A/B test ve ölçülebilir metrikler ile gerçek kullanıcı etkisini doğrulayın.
- İlk 30 günde veri keşfi, küçük güncelleme ve A/B döngüsü kurun.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
yazılım eğitimi için küçük veriyle nasıl başlamalıyım?
Önce veri keşfi yapın: loglar, hatalar ve kullanıcı profilleri çıkarın; sonra en yüksek hata yoğunluğuna sahip küçük bir alt-küme seçip manuel doğrulama ile etiket kalitesini kontrol edin. Bu alt-kümeyle küçük adapter güncellemeleri deneyin ve A/B test ile doğrulayın.
profil tabanlı örnekleme yazılım eğitimi maliyetini nasıl düşürür?
Profil tabanlı örnekleme yalnızca modelin problem yaşadığı alt-kümelere odaklanır, böylece daha az veriyle daha etkili öğrenme olur; ayrıca LoRA/adapter gibi yöntemler parametre güncellemesini küçülterek hesaplama maliyetini sınırlar.
yazılım eğitimi projelerinde en yaygın hata hangi test hatasıdır?
En yaygını etiket sızıntısıdır: eğitim verisi ile değerlendirme verisinin çakışması yanlış yüksek skorlar üretir. Bunu önlemek için profil bazlı sabit holdout, zaman temelli ayırma ve örnek hash'leri kullanın.
profil odaklı küçük güncellemeleri nasıl güvenli şekilde üretime alırım?
Kademeli dağıtım (canary), kısa süreli A/B testleri ve kabul oranı gibi açık metrikler kullanın; tersine çevirmeyi (rollback) hızlı yapmak için model sürümlendirme ve otomatik uyarı kuralları hazırlayın.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.