Bu rehber, database indexleme ve veritabanı performans ayarlama adımlarını uygulamalı örneklerle gösterir; veritabanı eğitimi arayan geliştiriciler için sql eğitimi ve nosql eğitimi perspektifi sunar.
Uygulamalı Database Indexleme ve Veritabanı Performans Ayarlama Rehberi
Çoğu uygulamada yavaş sorgular ve artan gecikme veri katmanından kaynaklanır; doğru indexleme ve ölçüm olmadan yanlış değişiklikler daha büyük sorunlara yol açar. Bu makalede sorgu odaklı index seçimi, ölçüm yöntemleri, gerçek dünya örneği ve bakım best practice'lerini öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Temel prensipler: database indexleme nasıl çalışır
Index'in amacı diskte daha az satır okumasıyla hedef veri satırına hızlıca ulaşmaktır; yaygın yapılar B-tree, hash ve inverted index'tir. SQL Server, PostgreSQL ve MongoDB gibi veritabanları farklı index implementasyonları sunar: SQL Server clustered/nonclustered, PostgreSQL B-tree/GiST/GIN, MongoDB ise BSON döküman bazlı indexler sağlar.
Doğru index seçimi cardinality, selectivity ve sorgu filtrelerinin sıralanmasına dayanır; örneğin yüksek cardinality bir kolon tek başına index için uygundur, düşük cardinality ise composite index veya filtreli (partial) index ile desteklenmelidir. Bu mekanizma sorgu planında random I/O yerine index seek veya index-only scan olmasını sağlar ve ölçümlerde logical reads veya buffer hits ile doğrulanır.
Sorgu odaklı index seçimi ve ölçüm yöntemleri
Sorgu optimizasyonu önce ölçüm sonra müdahale döngüsüdür: EXPLAIN/EXPLAIN ANALYZE veya SQL Server'da SET STATISTICS IO/TIME ile plan ve I/O bilgisi alınır. Planın en pahalı aşamasını (örneğin seq scan veya hash join) tespit edip, o aşamayı hedef alan bir index tasarlamak gerekir.
Aşağıdaki örnek sadece planı çalıştırıp gerçek I/O ve süreyi görmek için kullanılır; önce neyin yavaş olduğunu doğrulamak amacıyla yazıldı. Bu blok PostgreSQL'de sorgu planını ölçmek için tipik seçenekleri gösterir ve sonucu yorumlayarak hangi kolona index ekleneceğini tespit edersiniz.
Kod bloğu açıklaması: Aşağıdaki kod, sorguyu planlayıp I/O bilgisiyle çalıştırır; çıktıda seq scan yerine index seek arıyoruz. Bu yüzden önce ölçüm, sonra müdahale yapmanız tavsiye edilir.
EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT o.id, o.total, c.email
FROM orders o
JOIN customers c ON c.id = o.customer_id
WHERE o.created_at >= '2026-01-01'
  AND o.status = 'paid';
Neden böyle yazıldı: bu çıktı size hangi node'un fazla I/O yaptığını söyler; doğru index hedefini belirlemek için ham veriye ihtiyacınız var.
Gerçek dünya senaryosu: e-ticaret arama ve ödeme gecikmesi
Durum: Bir e-ticaret platformunda checkout sırasında ödeme doğrulama sorguları 400-800 ms arasında sürmeye başladı; bu da kullanıcı düşüşüne yol açıyordu. Sistem PostgreSQL üzerinde koşuyor, sorgu müşteri ve sipariş tablolarını join edip son 30 günün 'paid' ödemelerini getiriyordu.
Analiz: EXPLAIN çıktısı seq scan ve geniş hash join gösteriyordu; orders.status ve orders.created_at kolonlarında index yoktu, ayrıca sorgu result set'ini kapsayan bir covering index yoktu. Çözüm: composite index ile önce filtre aşamasında seek sağlandı, sonra sorgu planı index-only veya index scan + nested loop join'e dönüştü.
Aşağıdaki kod örneği, SQL Server üzerinde yaygın kullanılan nonclustered covering index oluşturma örneğidir; burada amaç, sorgunun ihtiyaç duyduğu kolonları index içine dahil edip diskten satır okumayı azaltmaktır. Kod bloğu basit bir CREATE INDEX örneğidir ve canlı sistemlerde online/rebuild seçenekleriyle kullanılmalıdır.
CREATE NONCLUSTERED INDEX IX_Orders_Status_CreatedAt
ON dbo.Orders (status, created_at)
INCLUDE (total, customer_id);
Sonuç: İndex eklendikten sonra aynı sorgunun p99 gecikmesi 650 ms'den ~80 ms seviyelerine; logical reads %85 azaldı, bu da hem CPU hem I/O tarafında düzelme sağladı.

Yaygın hatalar, edge case'ler ve bakım best practice
Yanlış indexler yazma ağırlıklı (write-heavy) yüklerde ciddi write amplification yaratır; çok fazla veya gereksiz covering index eklemek insert/update maliyetini artırır. Bu yüzden write yoğun tablolar için fillfactor ayarı, index rebuild sıklığı ve uygun parçalama (partitioning) stratejisi düşünülmelidir.
Edge case - istatistik staleness: planner yanlış selectivity hesaplarsa kötü plan seçer; bu durumda manual UPDATE STATISTICS/ANALYZE, extended statistics veya plan stabilizasyon yöntemleri gerekir. Ayrıca fragmentasyon ve page bloat SQL Server veya PostgreSQL'de farklı şekillerde ortaya çıkar; izleme için pg_stat_user_indexes, SQL Server'da DMF/DMV'ler kullanılmalıdır.
Bakım rutini: index kullanımını pg_stat_statements veya SQL Server DMVs ile haftalık izleyin, düşük kullanım ve yüksek bakım maliyeti olan index'leri kaldırın; rebuild/defrag işlemlerini çalışma zamanına göre planlayın.
NoSQL perspektifi: nosql eğitimi ile index stratejileri
NoSQL sistemlerinde (örneğin MongoDB, Cassandra) index modellemesi farklıdır: MongoDB'de compound ve multikey index'ler, Cassandra'da clustering key tasarımı sorgu performansını doğrudan belirler. Bu yüzden nosql eğitimi alırken sorgu odaklı modelleme kavramını öğrenmek SQL tarafındaki yaklaşımdan daha önceliklidir.
NoSQL'de secondary index'ler write maliyetini hızlı artırabilir; örneğin Cassandra'da secondary index kullanımı tavsiye edilmezken, MongoDB'de doğru compound index sorguları karşılayacak şekilde tasarlanmalıdır. Ölçüm için MongoDB Profiler, Cassandra nodetool ve benzeri araçlarla I/O ve latency ölçün.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu bilmek, yüksek trafikli uygulamalarda gecikmeyi azaltıp altyapı maliyetlerini düşürür; işe alım ilanlarında SQL ve performans ölçümü bilimi sıklıkla istenir, bu yüzden veritabanı eğitimi ve sql eğitimi CV'nizde fark yaratır.
Hem SQL Server eğitimi hem de nosql eğitimi projelere hız, güvenilirlik ve ölçeklenebilirlik katar; doğru indexleme uygulamaları, takımın teknik borcunu azaltır ve servis seviye hedeflerine ulaşmayı kolaylaştırır.
Özet
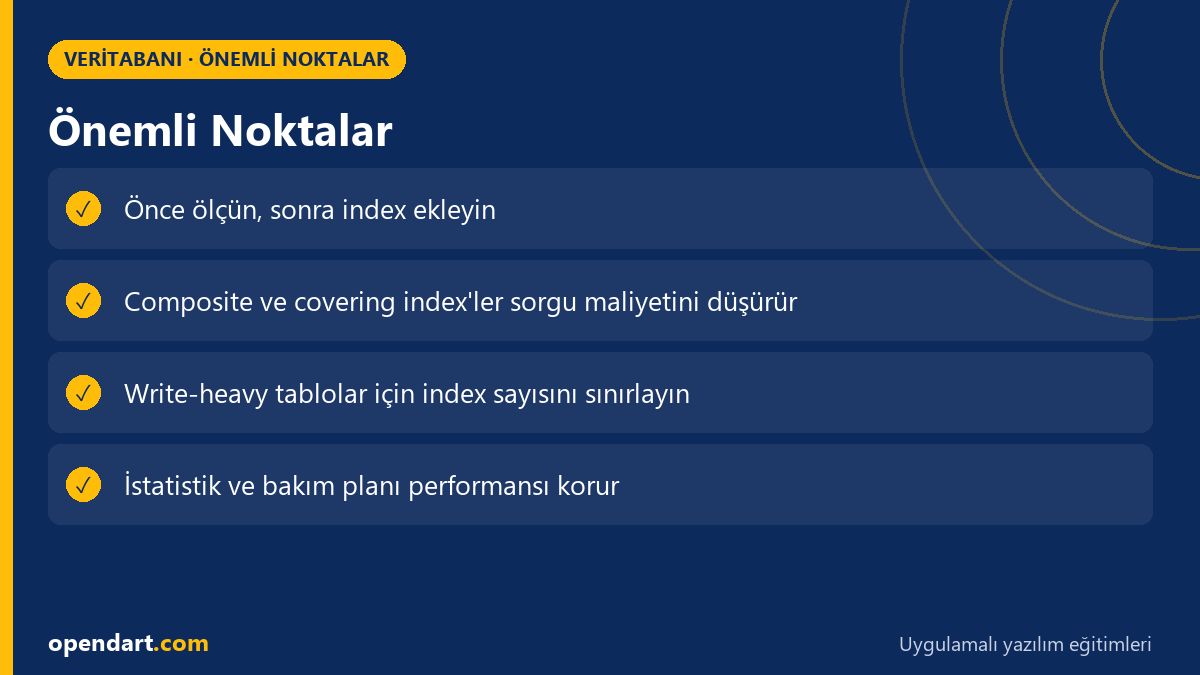
- Ölçmeden müdahale etmeyin: önce EXPLAIN/STATISTICS ile darboğazı tespit edin.
- Sorgu odaklı indexleme yapın: filtre ve join kolonlarını hedef alın.
- E-ticaret örneğinde composite index gecikmeyi önemli ölçüde düşürdü.
- Bakım ve istatistik güncelliği planınızın temel parçalarıdır.
- NoSQL sistemlerinde index stratejisi veri modeline göre değişir.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
veritabanı optimizasyonu nasıl başlanmalı?
Önce en sık kullanılan ve en pahalı sorguları tespit edin; EXPLAIN/ANALYZE veya SQL Server'da SET STATISTICS ile ölçüm yapın, sonra sorgu odaklı index tasarımı uygulayın.
database indexleme hangi durumlarda zararlı olur?
Çok sayıda gereksiz index write-heavy tabloda insert/update maliyetini artırır ve bakım yükü ekler; düşük kullanım gösteren index'leri kaldırmak daha iyidir.
sql server eğitimi almak veritabanı performans ayarlama için gerekli mi?
SQL Server özgü DMV'ler, lock/transaction davranışı ve optimizer karakteristikleri farklıdır; SQL Server üzerinde çalışıyorsanız vendor eğitimi performans ayarlamada doğrudan fayda sağlar.
nosql eğitimi veritabanı indexleme stratejisini nasıl etkiler?
NoSQL sistemlerinde sorgu bazlı modelleme ön plandadır; nosql eğitimi veri modelinin ve clustering/partitioning tercihlerinin performansa etkisini öğretir.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.