Sorgu kullanım işi haritası (heatmap) ile hangi indeksin ne zaman rebuild edileceğini belirleyen pratik bir rehber; database indexleme ve veritabanı optimizasyonu adımlarını ve ölçümlerini açıklar.
Sorgu Bazlı İndeks Yenileme ve Heatmap Yaklaşımı ile Database Indexleme
Çoğu ekip indeks bakımını periyodik takvimlere göre yapar ve gerçek kullanım verisini ihmal eder; bu hem gereksiz operasyonlara hem de kritik sorguların yavaş kalmasına yol açar. Bu makalede sorgu bazlı indeks yenileme, index usage heatmap üretme ve somut ölçümlerle veritabanı performans ayarlama temel adımlarını öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
İndeks Kullanım Isı Haritası ile Ölçüm (index usage heatmap)
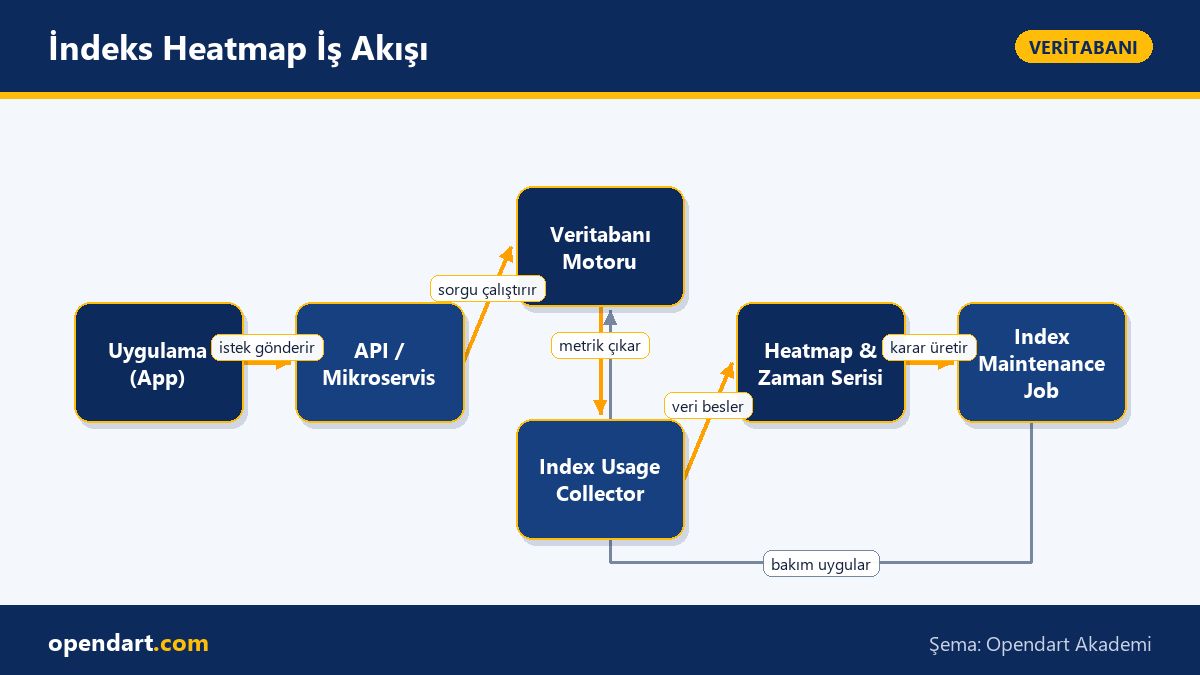
İndeks kullanım ısı haritası, hangi indekslerin gerçek üretimde kullanıldığını ve hangi indekslerin boşta kaldığını gösterir; bu veri database indexleme kararını veriyle destekler. SQL Server için DMVs, PostgreSQL için pg_stat_user_indexes ve MongoDB için indexStats gibi araçlardan metrik çekip zaman serisi olarak saklamak gerekir.
Aşağıdaki sorgu PostgreSQL'de temel indeks kullanım verilerini çeker; önce ne yaptığını kısaca açıklıyorum: sorgu pg_stat_user_indexes'den idx_scan ve idx_tup_fetch gibi metrikleri alır, en çok kullanılan indeksleri sıralar. Sonrasında neden böyle yazıldığına değineceğim çünkü bu alanlar hem sıklığı (idx_scan) hem de erişim yoğunluğunu (idx_tup_fetch) gösterir.
SELECT
  relname AS table,
  indexrelname AS index,
  idx_scan,
  idx_tup_read,
  idx_tup_fetch
FROM
  pg_stat_user_indexes
ORDER BY
  idx_scan DESC
LIMIT 50;
Sorgu Bazlı İndeks Yenileme Stratejileri
Sorgu bazlı indeks yenileme - hedef, yalnızca düşük kullanım ve yüksek bloat/fragmentation tespit edilen indeksleri rebuild etmektir. Ölçüm hattı genelde şu adımlardan oluşur: index usage toplama (DMV/pg_stat), bloat veya fragmentation ölçümü (pgstattuple, sys.dm_db_index_physical_stats), ve zaman içi heatmap agregasyonu; bu üç metrik kombinasyonu karar vermenizi sağlar.
İşte uygulamada izleyebileceğiniz kısa karar ağacı:
- Eğer idx_scan çok düşükse ve idx_tup_read/idx_tup_fetch düşükse - indeks aday;
- Eğer fiziksel bloat/fragmentation %X eşiğini aşıyorsa - rebuild önerilir;
- Yoğun yazma trafikli indekslerde
fillfactorayarlaması düşürülmeli veya partial index/filtered index düşünülmeli.
Pratik Komut Örneği: Güvenli CREATE INDEX ve Rebuild
Bir indeks oluştururken veya yeniden oluştururken canlı sistemler için 'concurrent' veya online seçeneklerini tercih etmek önemlidir; aşağıdaki örnek PostgreSQL için concurrent oluşturmayı ve fillfactor kullanmayı gösterir. Önce ne yaptığını anlatıyorum: parallel etkilenmeyi azaltmak için CONCURRENTLY kullandım ve yazma performansı için fillfactor ayarı ekledim.
Bu yüzden örnek küçük ve tek bir fikre odaklı tutuldu, çünkü doğru parametre kombinasyonu canlı sistemlerde lock riskini minimize eder.
CREATE INDEX CONCURRENTLY idx_orders_user_created_on
  ON orders (user_id, created_at)
  INCLUDE (status, total_amount)
  WITH (fillfactor = 80);
Gerçek Dünya Senaryosu: E-ticaret Sepet Servisi
Durum: Bir e-ticaret firmasının checkout mikroservisi zaman zaman 2-3 saniye gecikme yaşıyor, ve indeks bakım pencereleri trafik yoğun saatlere denk geliyordu. İlk adım heatmap üretip 30 gün boyunca index usage toplamak oldu; sonuç olarak checkout sorgularını hızlandıran tek bir indeksin kritik olduğu, fakat aynı tabloda 5 adet nadiren kullanılan indeks bulunduğu görüldü.
Çözüm: Nadir kullanılan 3 indeks arşivlendi (drop + kod paths), bir indeks için fillfactor %80'e çekilerek write amplification azaltıldı ve kritik indekse odaklı, zaman bazlı (off-peak) online rebuild uygulandı. Ölçülen sonuç: checkout sorgularının median gecikmesi 1200ms'den 800ms'e düştü ve I/O read ops yaklaşık %35 azaldı; ayrıca yeniden index pencereleri %60 daha kısa sürdü. Bu senaryoda dikkat edilmesi gereken edge case: indeks kaldırmadan önce sorgu planlarını ve uygulama kodunda bu indekse doğrudan referans olup olmadığını kontrol etmek gerekir.
NoSQL ile Karşılaştırma ve Eğitim Perspektifi
NoSQL eğitimi kapsamında index yönetimi SQL'den farklıdır: MongoDB'de indexStats ve TTL,index yöneticisi; Cassandra'da SSTable ve compaction davranışı ön plandadır. NoSQL sistemleri genelde write-heavy olduğundan index eklemek yazma maliyeti getirir; bu yüzden heatmap yaklaşımlarını NoSQL'e uyarlar iken sorgu paternlerini, partition key dağılımını ve compaction etkisini hesaba katın.
Ekiplerin veritabanı eğitimi ve sql eğitimi sırasında, database indexleme konusunu hem teori hem pratik ile birlikte öğretmek önemlidir: DMVs/pg_stat gibi araçların nasıl okunacağı, index kullanım metriklerinin nasıl zaman serisine çevrileceği ve değişikliklerin nasıl ölçüleceği pratik derslerde yer almalıdır. Ayrıca, sql server eğitimi katılımcılarına parameter sniffing ve plan cache kontrolünü göstermek, gerçek hayatta sık karşılaşılan bir inceliktir.
İnce Nüanslar ve Yaygın Hatalar
Deneyimli mühendislerin bile atladığı bir nokta, çok-sütunlu indekslerde sütun sıralamasının selectivity'yi doğrudan etkilemesidir; ilk sütun yüksek selektif olmalı. Ayrıca index-only scan için SELECT listesinde yalnızca indeks kapsayan sütunların olmasına dikkat edin; aksi halde beklenen performans kazanımı gerçekleşmez.
Bir diğer yaygın hata, düzenli rebuild ile bloat'u maskelenmektir; rebuild sonrası tekrar hızlı bloat oluşuyorsa root-cause (ör. autovacuum tuning, fillfactor, yoğun güncelleme paterni) çözülmelidir. Son olarak, otomatik bakım işlerini mutlaka ölçümlendirin: rebuild süresi, lock süreleri ve I/O etkisi gibi metrikler olmadan karar vermek risklidir.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu ve database indexleme bilgisi, hem orta-hem kıdemli pozisyonlarda iş tanımlarında sıkça talep edilir; bu bilgiyle sistemin kaynak kullanımını ölçümlü şekilde azaltabilir ve uygulama gecikmelerini somut metriklerle iyileştirebilirsiniz.
Bu konuyu öğrenmek, operasyonel maliyeti düşürür, bakım pencerelerini küçültür ve ekiplerin veriye dayalı karar alma yeteneğini geliştirir; ayrıca veritabanı eğitimi veya sql eğitimi alanında daha ileri roller (DBA lead, performans mühendisi) için gerekli pratik yetenekleri sağlar.
Özet
- Index usage heatmap gerçek kullanım verisi sunar ve bakım kararını veriyle destekler.
- Sorgu bazlı strateji yalnızca düşük kullanım ve yüksek bloat olan indeksleri hedefler.
- Canlı sistemlerde concurrent/online işlemler kilit riskini azaltır ama süreyi uzatır.
- NoSQL sistemlerinde write maliyeti ve compaction davranışı index kararlarını etkiler.
- Değişiklikleri uygulamadan önce planları, kod yollarını ve ölçümleri kontrol edin.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
database indexleme için hangi metrikleri takip etmeliyim?
Öncelikle index usage (idx_scan), idx_tup_read/idx_tup_fetch gibi erişim metriklerini, fiziksel fragmentation/bloat ölçümlerini ve operasyon süresini takip edin; bu üç veri seti beraber karar vermenizi sağlar.
veritabanı optimizasyonu kapsamında ne zaman indeks rebuild etmeliyim?
Rebuild kararı için düşük kullanım (heatmap), yüksek fiziksel bloat veya fragmentation ve rebuild süresinin kabul edilebilir olması gereklidir; tek başına yaşlı indeks olmak rebuild için yeterli sebep değildir.
sql server eğitimi alırken index kullanım heatmap nasıl öğretilir?
Eğitimde önce DMVs ile metrik çekmeyi, sonra bu metrikleri zaman serisine çevirip heatmap oluşturmayı ve son olarak karar ağacı uygulamalarını (rebuild/drop/tune) bir vaka çalışmasıyla öğretmek etkili olur.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.