Bu makale veritabanı optimizasyonu ve database indexleme temellerini uygulamalı örneklerle anlatır; SQL ve NoSQL yaklaşımlar, ölçüm, ve hızlı müdahale adımlarını öğrenerek ilk optimizasyon adımını atabilirsiniz.
Pratik Veritabanı Performans Ayarlama ve Etkili Database Indexleme
Sorguların beklenmedik şekilde yavaşlaması sık karşılaşılan bir problem; doğru metrik ve uygun indexleme ile çoğu darboğaz hızlıca giderilebilir. Bu yazıda veritabanı optimizasyonu, database indexleme ve ölçüm adımlarını adım adım öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Veritabanı optimizasyonu: temel prensipler
Veritabanı optimizasyonu, sadece indeks eklemekten ibaret değildir; veri modellemesi, sorgu yapısı, donanım ve konfigürasyon birlikte etkilidir. Mekanizma olarak, bir sorgunun gecikmesi genellikle disk I/O, bellek yetersizliği, kilitlenme (locking) veya hatalı plan seçiminden kaynaklanır; bu yüzden önce ölçüm, sonra müdahale yapılmalıdır.
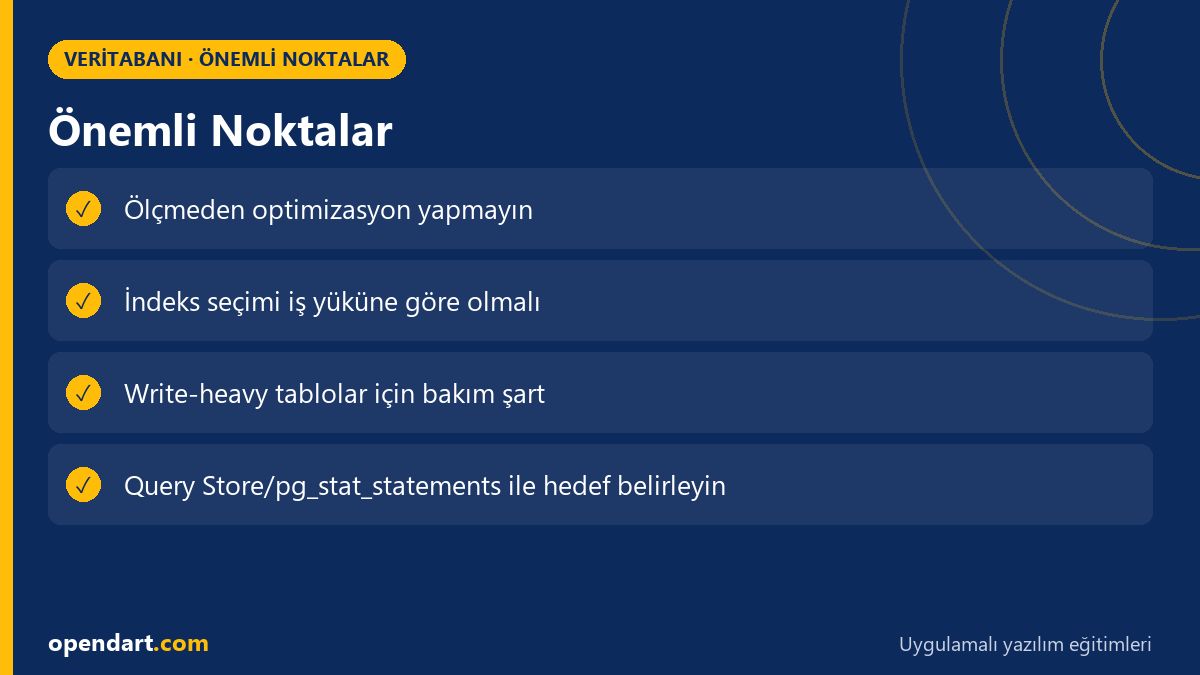
Ölçüm araçları olarak PostgreSQL için pg_stat_statements veya SQL Server için Query Store kullanılabilir; NoSQL ortamlarında ise MongoDB ve Cassandra kendi izleme metriklerini sunar. Performans ayarlama sürecinde, önce en maliyetli sorguları tespit edin, sonra uygun index türünü ve gerektiğinde sorgu değişikliğini uygulayın.
İndeks türleri ve seçim - database indexleme
İndeks seçiminde B-tree, hash, columnstore veya özel filtreli indeks gibi türler arasından iş yüküne uygun olanı seçmelisiniz: OLTP için genelde B-tree, analitik yükler için columnstore daha uygundur. NoSQL sistemlerinde ise veri yerleşimi (sharding/partitioning) indeksleme kadar önemlidir; bu yüzden nosql eğitimi alanlar veri modeline göre sorgu optimizasyonunu öğrenmelidir.
Aşağıdaki kısa SQL Server örneği, sık kullanılan WHERE filtresine göre filtreli (filtered) indeks oluşturur; önce ne yaptığını, sonra neden böyle yazıldığını açıklıyorum. Bu kod bloğu, Order tablosunda iptal edilmeyen kayıtlar için kısıtlı bir indeks oluşturur; böylece sorgular sadece ilgili satırları tarar ve I/O'yu azaltır. Ardından neden böyle yazıldığına dair notlar var.
-- Filtered index örneği
CREATE INDEX IX_Orders_UserDate
ON Orders (UserId, OrderDate)
WHERE IsCancelled = 0;
Gerçek dünya senaryosu: e-ticaret sitesinde gecikme sorunu
Durum: Orta ölçekli bir e-ticaret uygulamasında ödeme sayfası sorguları zirve dönemlerinde 800-1200 ms aralığına çıkıyordu; müşteri şikayetleri ve artan abandonment görüldü. Sistem: uygulama .NET Core + SQL Server, read-heavy cache katmanı için Redis kullanılıyordu.
Çözüm: önce Query Store ile en pahalı 10 sorgu belirlendi; ardından kullanıcıya özel sepet sorgusunda kullanılan JOIN ve WHERE kolonları incelendi. Uygulama ekibi, checkout sorgusunu basitleştirip, ödeme durumunu filtreleyen bir filtered index ekledi ve sık erişilen stok bilgilerini Redis üzerinden önbelleğe aldı.
Sonuç: indeks ve cache kombinasyonu ile median sorgu süresi 720 ms'den 120 ms'e düştü; CPU yükü %35 azaldı ve I/O operasyonlarında günlük 1.2 TB'tan 300 GB'a gerileme ölçüldü. Bu somut ölçümler, veritabanı performans ayarlama adımlarının işletme üzerindeki etkisini gösterir.
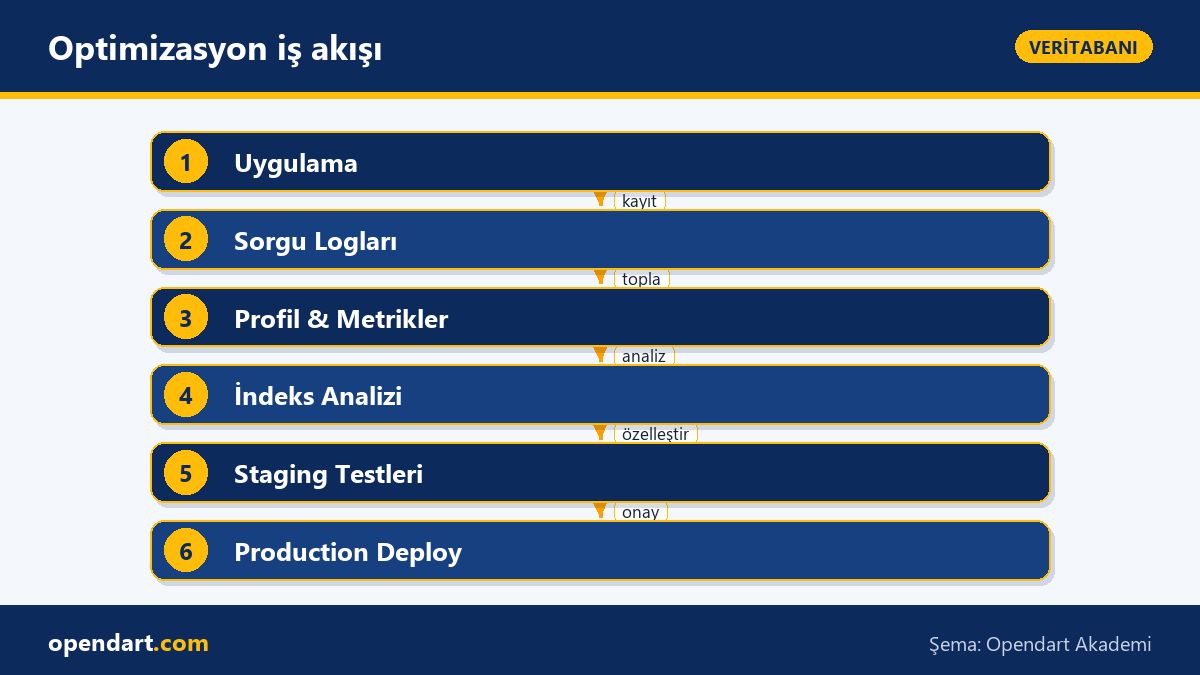
İzleme, ölçüm ve otomasyon - veritabanı performans ayarlama
Sürekli performans için izleme şarttır: latency, p95/p99, logical/physical reads, wait stats ve plan değişimleri düzenli izlenmeli. Araç olarak Prometheus + Grafana, pg_stat_statements, SQL Server Query Store veya bulut sağlayıcıların APM çözümleri kullanılabilir; otomatik alarm kuralları ile düşüş anında bildirim almak kritik.
Otomasyon önerisi: indeks önerilerini haftalık raporla toplayıp, düşük riskli değişiklikleri test veritabanında uygulayın; uygun olanları staging'de rebuild/test sonrası production'a geçirirken bakım penceresi planlayın. Ayrıca indeks bakımında rebuild/reorganize stratejisini write-amplification ve fillfactor göz önüne alarak belirleyin.
İnce detaylar ve yaygın tuzaklar
Edge case - parameter sniffing: SQL Server ve PostgreSQL'te aynı sorgunun farklı parametrelerle farklı plan seçmesi sık görülür; bunun çözümü parametrik plan sabitleme, OPTION (RECOMPILE) veya plan rehberleri olabilir. Bu tercihler performansı olumlu ya da olumsuz etkileyebilir; önce planları karşılaştırın.
Yaygın hata: her sorgu için indeks eklemek yerine, write-heavy tablolar için uygun fillfactor ve partitioning düşünülmeli; ayrıca çok geniş indeksler indeks-only scan avantajını götürebilir. SQL eğitimi ve sql server eğitimi almak, bu nüansları gerçek örneklerle öğrenmeniz için faydalıdır; nosql eğitimi de farklı iş yükleri için doğru alternatifleri anlamanızı sağlar.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu bilmek, hem uygulama maliyetlerini düşürür hem de kullanıcı deneyimini doğrudan iyileştirir; iş ilanlarında veritabanı performans ayarlama ve database indexleme tecrübesi sık talep edilen yetkinlikler arasındadır.
Kariyer açısından, bu beceri seni backend mühendisliği ve SRE rolleri için daha yarışır kılar; projede kısa sürede görülür değer, daha az altyapı maliyeti ve daha az müşteri şikayeti olarak geri döner.
Özet
- Önce ölçüm yapın, sonra müdahale edin; en maliyetli sorgulara odaklanın.
- İndeks türünü iş yüküne göre seçin: OLTP için B-tree, analitik için columnstore.
- Filtered index ve partitioning ile I/O'yu azaltın ama write etkisini izleyin.
- İzleme ve otomasyonla regressiyonları erken tespit edin.
- Parametre sniffing ve fillfactor gibi ince detaylar büyük etki yapabilir.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
veritabanı optimizasyonu nasıl yapılır?
İlk adım ölçüm: yavaş sorguları, bekleme türlerini ve I/O'yu tespit edin; sonra indeks, sorgu değişikliği veya cache ile müdahale edin ve etkisini ölçün. Her değişikliğin staging testleri ve geri alma planı olmalı.
database indexleme ne zaman zararlı olur?
Çok sayıda ve geniş indeksler yazma maliyetini artırır; write-heavy tablolar için fazla indeks eklemek insert/update/delete gecikmelerine yol açar. Ek indeksler eklenmeden önce insert/update maliyet hesaplanmalı.
sql server eğitimi ile hangi performans konularını öğrenirim?
Query Store kullanımı, index tasarımı, plan analizleri, parameter sniffing, ve bakım stratejileri gibi pratik konuları öğrenirsiniz; bunlar production performansını doğrudan etkiler.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.