Model güncellemelerini veri-verimli yaparak maliyeti düşürmeyi ve doğruluğu korumayı öğreneceksiniz; yazılım eğitimi bağlamında örnekleme, izolasyon ve canary stratejilerini ele alıyor.
Pratik Veri-Verimli Stratejilerle Yazılım Eğitimi için Model Güncelleme
Sürekli model güncellemeleri yapan ekipler genellikle yanlış veri seçimi, dağılım kayması ve yüksek maliyetle karşılaşıyor. Bu makalede veri-verimli yaklaşımlarla yazılım eğitimi sürecinde hangi adımları atmanız gerektiğini ve ilk deneyiminizi nasıl güvenli şekilde yapacağınızı öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Veri-verimli güncellemelerin mantığı ve yazılım eğitimi önemi
Veri-verimli güncellemeler, her seferinde tüm veri kümesini yeniden eğitmek yerine, güncelleme için hedefe yönelik, yüksek etki beklenen örnekleri seçer. Bu yaklaşım yazılım eğitimi bağlamında modelin sık güncellendiği ve her güncellemenin maliyet ve risk getirdiği durumlarda önem kazanır.
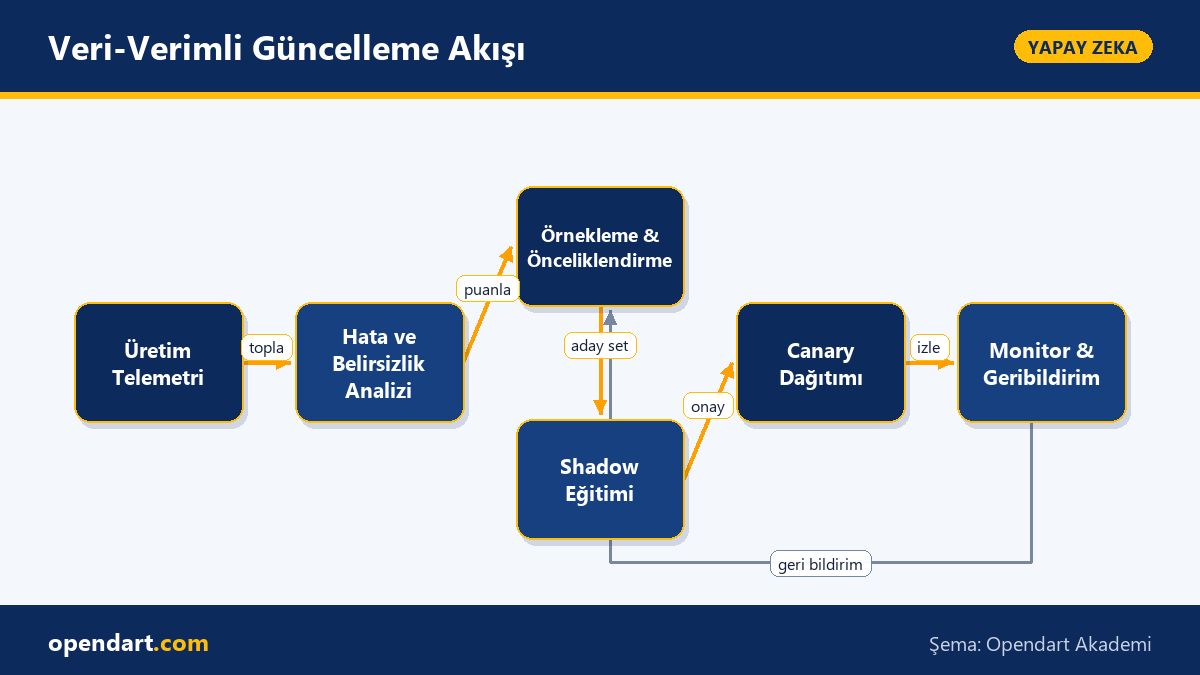
Nasıl çalıştığı: örnekleme, önceliklendirme ve izolasyon üçgeni üzerine kurulur - kritik hatalar veya yeni özellikleri temsil eden küçük, etki yaratacak veri dilimleri seçilir; bu dilimler shadow testleri ve canary dağıtımları ile izole edilip ölçülür. Bu mekanizma maliyeti düşürürken regresyon riskini de azaltır.
Boru hattı tasarımı: örnekleme, izolasyon ve ölçümleme
İyi bir boru hattı, veri seçimini, model güncellemesini ve güvenlik kontrolünü ayrı aşamalara böler. Örnekleme katmanı için skor temelli seçim, hata eşiklemeli seçim ve son kullanıcının geri bildirimine dayalı filtreleme kombinasyonunu kullanabilirsiniz; araç olarak Airflow, Prefect veya bir basit cron+DB sorgusu yeterli olabilir.
Aşağıdaki örnek, son hataların önceliklendirilmesiyle seçilecek 500 örneği gösteren basit SQL-benzeri sorgudur. Bu kod bloğu seçimin nasıl yapıldığını gösterir; boru hattında bunu günlük olarak çalıştırıp candidate set oluşturursunuz.
Açıklama: Bu sorgu kritik hataları, frekansı ve model belirsizliğini birleştirerek puan oluşturur ve en yüksek puanlı 500 örneği döner. Böylece model güncellemesi küçük ama etkisi yüksek bir veri dilimiyle yapılır.
SELECT id
, error_count
, uncertainty_score
, (error_count * 0.6 + uncertainty_score * 0.4) AS priority
FROM model_errors
WHERE created_at > now() - interval '14 days'
AND label_verified = true
ORDER BY priority DESC
LIMIT 500;
Sonuç: Bu yaklaşım manuel rasgele seçime kıyasla hata regresyonlarını daha hızlı yakalar ve GPU saatlerini hedefe yönelik kullanmanızı sağlar.
Gerçek dünya senaryosu: e-ticaret kod öneri sisteminde uygulama
Durum: Orta ölçekli bir e-ticaret firması, geliştirici deneyimini artırmak için kod tamamlama ve hata tespiti önerileri üreten bir LLM tabanlı iç araç kullanıyordu. Her gün toplu yeniden eğitim yapmak hem yüksek bulut maliyeti hem de üretim gerilemesine sebep oluyordu.
Çözüm: Ekip veri-verimli bir pipeline kurdu; üretim hatalarını izleyip 14 günlük kritik hataları SQL ile seçti, etiketi doğrulanan 500 örnekle aylık küçük güncellemeler yaptı, ve güncellemeden önce shadow testlerle diğer metriklere etkisini ölçtü. Canary dağıtımı 5% trafiğe açıldı ve 72 saat boyunca hata oranı monitor edildi.
Ölçülen sonuçlar: İlk ayda öneri doğruluğu +6 puan artarken üretim regresyonları %3'ten %1'e düştü, aylık GPU maliyeti önceki toplu eğitime göre %42 azaldı. Bu somut değerler, küçük hedefli güncellemelerin hem güvenli hem de ekonomik olduğunu gösterdi.
İncelikler, yaygın hatalar ve best practice'ler
Edge case: dağılım kayması ve label noise en sık görülen sorunlardır. Rehearsal (önceki örneklerden seçme), reservoir sampling ve prioritized replay ile modelin unutmasını azaltabilirsiniz. Ayrıca hatalı etiketleri otomatik tespit için model-etiket çakışma skoru kullanmak, kötü güncellemelerin önüne geçer.
Canary ve shadow testleri zorunludur: yeni ağırlıkları önce shadow ortamında gerçek trafiğin kopyasıyla test edin ve davranış metric'lerini (hata oranı, latency, kullanıcı-aksiyon metrikleri) karşılaştırın. Ayrıca güncelleme sırasında izole edilebilecek bağımsız feature setleri tutmak rollback süresini kısaltır.
Bir diğer pratik: her güncelleme için küçük bir 'kabul kriteri' seti oluşturun (ör. hata oranında artış <0.5 puan, latency değişim <5%). Bu kriterleri otomatikleştirip CI/CD boru hattına entegre etmek insan hatasını azaltır ve operasyonel güvenliği artırır.
Güncelleme operasyonu örneği: canary tetiklemesi ve otomatik geri çekme
Aşağıdaki küçük örnek, güncelleme servisine canary tetiklemesi göndermeyi simüle eden bir HTTP isteğidir; basit bir otomasyon senaryosunda kullanılabilir. Kod bloğu, bir API'ye model güncellemesi isteği gönderen minimal bir curl örneğidir ve üretimde uygun kimlik doğrulama, rate limiting ve geri çekme mantığıyla birlikte kullanılmalıdır.
curl -X POST https://mlops.example.com/api/v1/models/update -H "Authorization: Bearer $TOKEN" -H "Content-Type: application/json" -d '{"model_id": "recommender-v2", "canary_pct": 5, "dataset_id": "critical-errors-500"}'
Neden böyle yazıldı: Bu örnek minimaldir ve otomasyon pipeline'ınıza kolayca entegre edilebilir; gerçek kullanımda timeout, retry ve monitoring tetikleyicileri ekleyip 5% canary sonuçlarını 72 saat boyunca değerlendirmelisiniz.
Bu konuyu neden öğrenmelisiniz?
Yazılım eğitimi süreçlerinde veri-verimli güncellemeleri öğrenmek, projelerde maliyeti ve riskleri azaltırken kısa döngüyle iyileştirme yapmanızı sağlar; iş ilanlarında sürekli öğrenme ve MLOps tecrübesi artan talep görüyor.
Kariyer açısından bu beceri, model operasyonları, veri mühendisliği ve üretim ML rolleri arasında köprü kurar; ekipler küçük, etkili güncellemelerle daha hızlı geri bildirim alıp ürün değeri üretebilir.
Özet
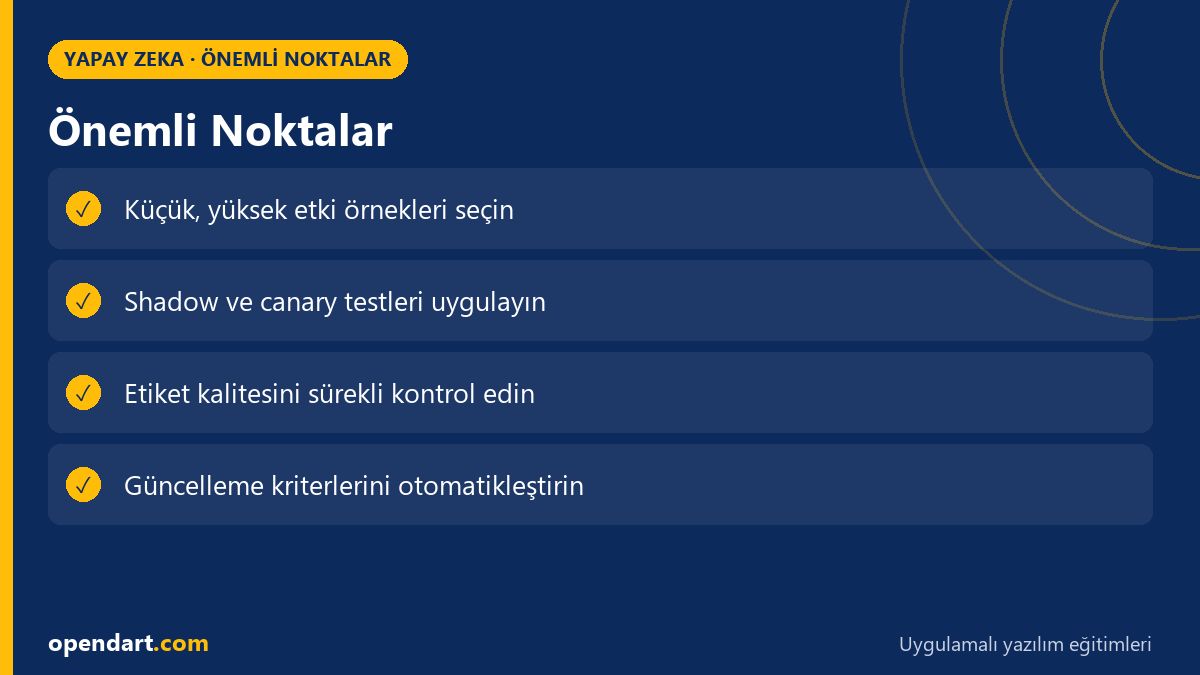
- Hedefli örnekleme ile her güncellemede tüm veri kümesini işlemeye gerek yoktur.
- Shadow testleri ve canary dağıtımı regresyon riskini minimize eder.
- Etiket doğrulama ve önceliklendirme, güncelleme etkisini doğrudan artırır.
- Rehearsal ve reservoir sampling ile unutmayı azaltmak mümkündür.
- Kabul kriterlerini otomasyona almak operasyonel güvenliği yükseltir.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
Veri-verimli yazılım eğitimi için hangi metrikleri izlemeliyim?
Temel metrikler: üretim hata oranı, latency, model belirsizlik skoru ve kullanıcı yönelimli metriklerdir; değişimleri canary süresince karşılaştırarak kabul kriterleri belirleyin.
Yazılım eğitimi sırasında etiket hatalarını nasıl azaltırım?
Otomatik tutarsızlık tespiti (model vs etiket), insan doğrulama akışı ve kötü etiketleri izole eden bir pipeline kurarak etiket kalitesini artırabilirsiniz.
Küçük güncellemeler yazılım eğitimi sürecinde maliyeti gerçekten düşürür mü?
Evet; hedeflenmiş 500-1000 örneğe yapılan güncellemeler GPU kullanımını ve eğitim sürelerini düşürür, ayrıca canary ile regresyon riski azaldığı için operasyonel maliyetler de azalır.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.