Hibrid index stratejileriyle OLTP ve analitik yükler için etkili database indexleme uygulamalarını öğrenin; veritabanı optimizasyonu, sql server eğitimi ve nosql eğitimi perspektifleriyle pratik adımlar sunulur.
Büyük İş Yükleri İçin Hibrid Index Stratejileri ve Database Indexleme
Çoğu ekip, indeksleme yaparken tek tip bir strateji uygular ve zamanla sorgu performansı düşer. Bu makalede hibrid index yaklaşımlarını, SQL ve NoSQL ortamlarında nasıl uygulayacağınızı ve ilk ölçümleri nasıl alacağınızı öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Hibrid Index Stratejileri ve database indexleme
Hibrid indexleme B-tree, columnstore ve kısmi (filtered/partial) indeksleri bir arada kullanarak hem OLTP hem de OLAP ihtiyaçlarını karşılamaya çalışır. Bu yaklaşım veritabanı optimizasyonu açısından önemlidir çünkü tek tip indeks tüm sorgu kalıplarına uymayabilir; doğru kombinasyon sorgu planlarını basitleştirir ve IO maliyetini düşürür.
Nasıl çalışır: OLTP tablolarında sık yazılan alanlara düşük maliyetli B-tree indeksleri, analitik sorgular için columnstore veya clustered columnstore kullanılır; sıcak-kış veri ayrımı için partitioning ile birlikte partial indeksler uygulanır. Örneğin SQL Server'da columnstore segment eliminasyonu sayesinde büyük taramalarda CPU ve bellek baskısı azalır; PostgreSQL'de ise BRIN gibi yapılar büyük zaman serisi tablolarında fayda sağlar.
Neden önemli: Hibrid yaklaşım veritabanı performans ayarlama sürecinde size esneklik verir - bir sorgu tipi yavaşladığında tüm sistemi değil sadece o yükü hedefleyerek optimizasyon yapabilirsiniz. Bu aynı zamanda veri tabanı eğitimi ve ekiplerin indexleme konusundaki karar verme süreçlerini hızlandırır.
Sorgu ve iş yükü bazlı index tasarımı (SQL eğitimi örnekleri)
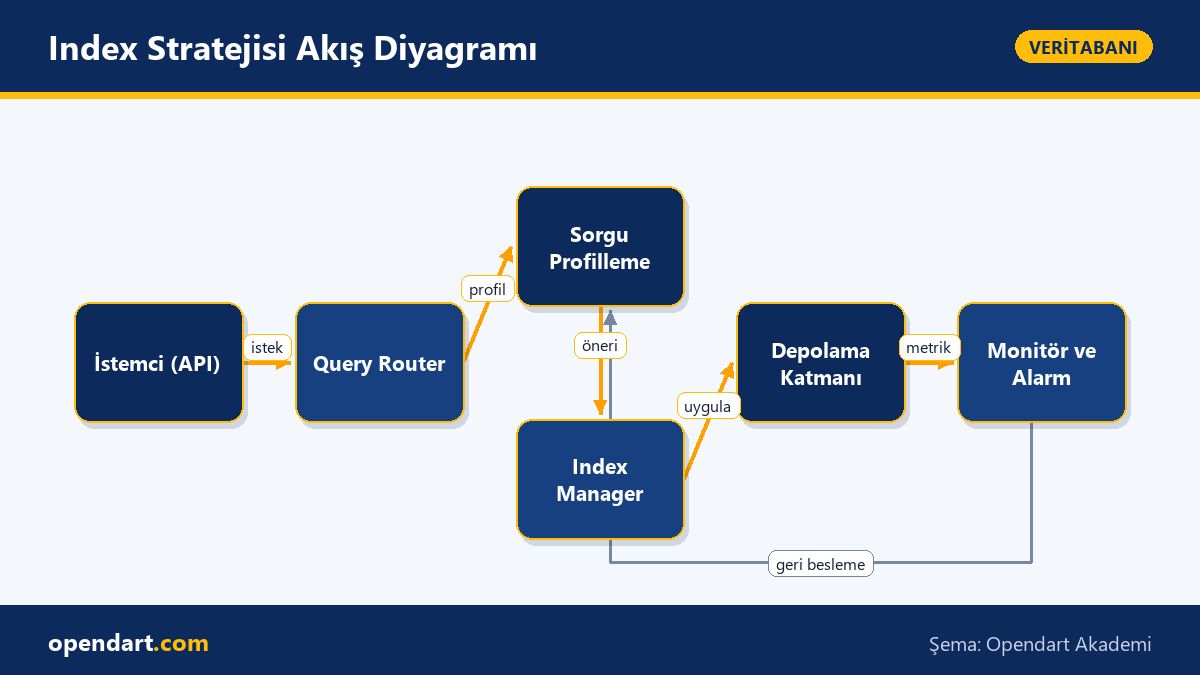
İyi bir index stratejisi sorgu profilini bilmekle başlar: hangileri sık çalışıyor, hangileri uzun süren full scan yapıyor, hangileri latency-sensitive. SQL Server Query Store, PostgreSQL pg_stat_statements veya APM araçlarıyla sorgu histogramları çıkarın; bu veriler hangi kolonlara ve hangi include/covering stratejisine ihtiyaç olduğunu gösterir.
Aşağıdaki kısa örnek SQL Server'da filtrelenmiş (filtered) ve INCLUDE içeren bir indeks oluşturur; örneği vermemin amacı gerçek dünyada sık kullanılan bir pattern'i göstermek ve neden seçildiğini açıklamaktır. Bu indeks, sık sorgulanan durumu hedefler ve gereksiz satırları indeks yapısından dışlar, böylece index boyutu ve page IO azalır.
CREATE NONCLUSTERED INDEX IX_Products_Active_Category
ON dbo.Products (CategoryId, Price)
INCLUDE (Name, Stock)
WHERE IsActive = 1
WITH (FILLFACTOR = 80, ONLINE = ON);
WHERE IsActive = 1 ile pasif ürünleri dışarı bırakarak indexin etkin satır oranı artırıldı, INCLUDE ile covering sağlanıp lookup'lar azaltıldı ve FILLFACTOR ile write amplification kontrol edildi.Gerçek dünya senaryosu: E-ticaret arama performansı
Durum: Bir e-ticaret ürün kataloğu, ürün aramalarında artan gecikme ve yüksek CPU nedeniyle müşteri dönüşümlerinde düşüş yaşıyordu. Sorgular ürün adına, kategoriye ve stok durumuna göre filtreleniyordu; ancak indeksleme tüm kolonları kapsayacak şekilde düzensiz ve çok büyük nonclustered indekslere neden oluyordu.
Uygulanan çözüm: Sorgu profilleme ile en sık kullanılan sorgular belirlendi, arama için full-text index ile birlikte küçük ve hedeflenmiş B-tree indeksleri oluşturuldu; stok kontrolü için ise filtered index uygulandı. Ayrıca sık sorgulanan read-heavy raporlar için columnstore segmentleri ayrıldı. Sonuç: ortalama arama gecikmesi %65 azaldı, CPU kullanımında sabit düşüş ve index depolama maliyetinde %30 tasarruf ölçüldü.
NoSQL ve SQL için indexleme farkları ve nosql eğitimi ipuçları
NoSQL sistemleri (ör. MongoDB, DynamoDB) genellikle farklı indexleme modelleri sunar: MongoDB'de ikincil indeksler, DynamoDB'de global ve local secondary indexler kullanılır. NoSQL'de dizayn yaparken sorgu odaklı modelleme gerekir; veriyi normalleştirmek yerine sorgu ihtiyacına göre denormalize etmek ve doğru GSI/Lsi tasarlamak veritabanı performans ayarlama açısından kritik.
SQL tarafında relational indexler daha zengindir (include, filtered, indexed views, columnstore), bu yüzden sql eğitimi alırken sorgu planı analizine ve fiziksel indeks seçeneklerine odaklanın. NoSQL eğitimi ise partition key seçimi, hot partition önleme ve read/write kapasitelerinin maliyet etkisini içerir; her iki dünyada da ölçüm yapmadan indeks silmek ya da yeniden oluşturmak risklidir.
İleri düzey ince noktalar: page splits, fillfactor ve rebuild stratejileri
Page split'ler ve write amplification, yoğun yazma olan OLTP sistemlerinde performansı bozan en yaygın sorunlardır. Fillfactor'ü düşük ayarlamak, page split'leri azaltır ancak index boyutunu büyütür; bu nedenle monitoring ile denge kurulmalıdır. SQL Server'da düzenli index rebuild/reorganize politikası ve online rebuild seçenekleri yanlış zamanlama ile daha kötü etki yapabilir.
Best practice: önce ölçüm yapın - free_space_in_page_percentage, page_split_rate ve logical_reads/physical_reads metriklerini takip edin; sonra fillfactor testleri yapın. Rebuild sıklığını uygulamanın RPO/RTO gereksinimlerine göre ayarlayın ve büyük tablolar için partition-level maintenance kullanın. Bu detaylar veritabanı optimizasyonu ve veritabanı performans ayarlama süreçlerinde ciddi fark yaratır.
Bu konuyu neden öğrenmelisiniz?
Veritabanı eğitimi ve özellikle database indexleme yetkinliği, orta ve büyük ölçekli sistemlerde performans sorunlarını çözmek için doğrudan işe yarar beceridir; iş ilanlarında hem SQL hem NoSQL index bilgisi sıkça talep edilir. Bu bilgi, uygulama maliyetlerini düşürür, kullanıcı deneyimini iyileştirir ve altyapı kaynaklarını daha verimli kullanmanızı sağlar.
Kariyer açısından, veritabanı optimizasyonu ve veritabanı performans ayarlama becerileri seni performans mühendisliği, veri mühendisliği ve backend mimarisi rollerine yaklaştırır; ekip içindeki teknik kararların daha iyi anlaşılmasını ve uygulanmasını sağlar.
Özet
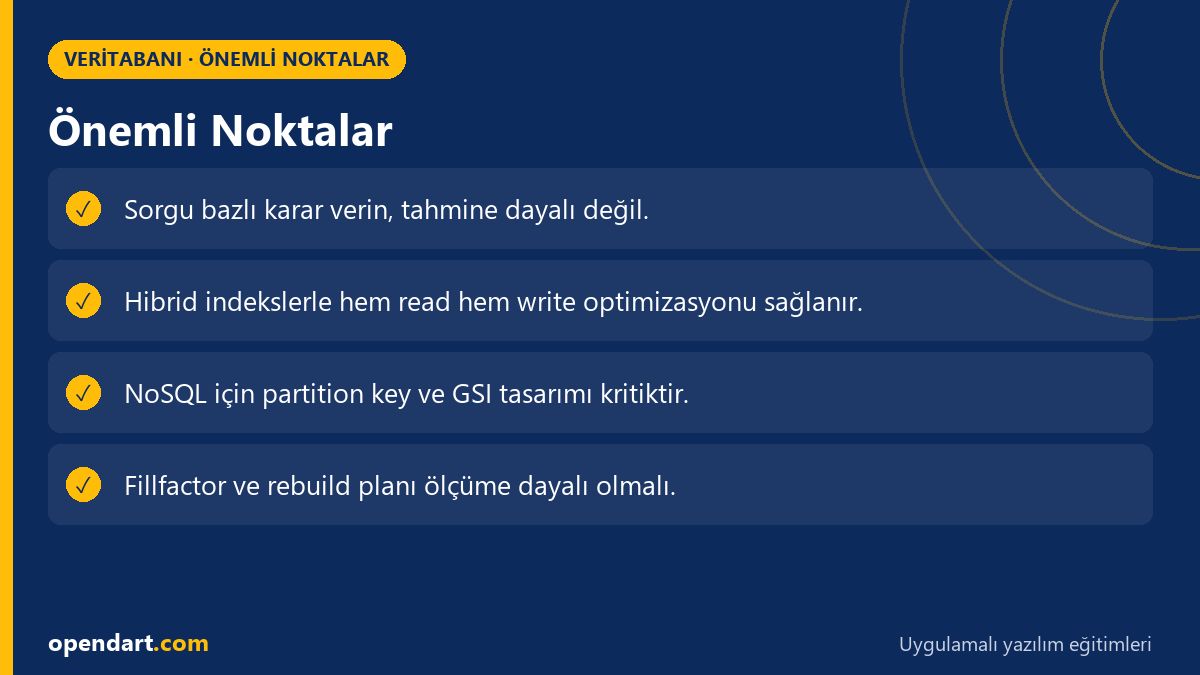
- Hibrid index stratejileri OLTP ve OLAP yüklerini dengeleyerek IO ve CPU'yu azaltır.
- Sorgu profili çıkarma olmadan indeks değişiklikleri ters etki yapabilir.
- SQL ve NoSQL indexleme paradigması farklıdır; her ikisini de öğrenmek fayda sağlar.
- Fillfactor, page split ve rebuild politikalarını ölçümle belirleyin.
- Gerçek dünya senaryolarında hedeflenmiş filtered/covering indeksler büyük kazanç sağlar.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
veritabanı optimizasyonu nasıl başlar ve hangi metrikler ilk bakılacaklar?
İlk adım sorgu profillemesi yapmak; takip edilmesi gereken temel metrikler: execution time, logical_reads, physical_reads, wait types ve page split rate. Bu metrikler hangi indekslerin işe yaradığını, hangi sorguların IO tükettiğini ve nerede write amplification olduğunu gösterir.
database indexleme yaparken fillfactor kaç olmalı?
Fillfactor tek bir değer değildir; tablonun yazma yoğunluğuna göre değişir. Yoğun yazma olan tablolar için 70-85 arası test edilir; read-heavy tablolar için 90-100 tercih edilir. En doğru yaklaşım ölçüm yapıp A/B testleriyle en az page split ve kabul edilebilir index boyutunu bulmaktır.
sql server eğitimi kapsamında hangi index konuları öncelikli öğretilmeli?
Öncelikli konular: execution plan okuma, clustered vs nonclustered, INCLUDE kullanımı, filtered/partial indexler, columnstore ve online rebuild/reorganize yöntemleri; ayrıca Query Store ve DMF/DMV araçlarının kullanımı.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.