Veri hacmi arttikça LLM güncellemeleri pahali ve gürültülü olur; bu yazida yazilim egitimi için profil odakli örnekleme, ölçümler ve üretim boru hatti adimlarini ögrenip ilk uygulamayi hayata geçirebileceksiniz.
Profil odaklı veri seçimiyle yazılım eğitimi için pratik LLM akışı
LLM tabanlı modelleri yazılım eğitimi amaçlı güncellerken en yaygın sorun gereksiz veri, dengeli olmayan profiller ve ölçümsüz başarı kriterleridir. Bu makalede profil odaklı veri seçimi ve örnekleme adımlarını, uygulanabilir bir boru hattı ve üretimde dikkat etmeniz gereken ölçümlerle öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Neden profil odaklı veri seçimi - yazılım eğitimi
LLM'leri yazılım eğitimi için güncellerken amaç genelleme değil belirli kullanıcı profillerine (ör. yeni başlayanlar, kıdemli geliştiriciler, code-review botu) uygun davranış elde etmektir. Ham veri miktarını artırmak maliyeti ve hendekleri (bias, spam, düşük kaliteli örnek) büyütür; profil odaklı seçme, her profilin sinyalini güçlendirir ve eğitim maliyetini düşürür.
Bu yaklaşımın mekanizması profil çıkarımı, ağırlıklandırma ve örnekleme üçgenine dayanır: kullanıcı veya görev profili tanımlanır (etiketler, telemetri, hata türleri), her örnek profile göre skorlama alır ve bu skorlar eğitim setinde doğru temsili sağlamak için kullanılır. Hugging Face Hub, Weights & Biases ve basit SQL/pandas ile bu adımlar pratikte uygulanır.
Profil oluşturma ve akıllı örnekleme
Profil oluşturma için iki yaygın kaynak kullanın: telemetri (kullanıcı etkinliği, çözüm süresi) ve anotasyonlar (zorluk seviyesi, konu etiketi). Her kaynaktan gelen sinyalleri normalleştirip birleştirerek profil skorları üretirsiniz; örneğin yeni başlayanlar için "açıklama bekleyen" label'ı yüksek ağırlık alabilir.
Aşağıdaki kısa Python örneği, pandas kullanarak profile göre ağırlıklandırılmış örnekleme yapar. Kod, her örneğe profil skorunu atar ve bu skorlarla stratified-weighted örnek çeker; uygulamada aynı mantığı Hugging Face Datasets veya bir SQL sorgusu içinde de kullanabilirsiniz.
import pandas as pd

# örnek veri
df = pd.read_csv('annotations.csv')

# profile skorları: yeni_baslayan 0-1 arası
df['profile_score'] = df['is_beginner'] * 0.8 + df['clarity_score'] * 0.2

# ağırlıklı örnekleme
sample = df.sample(n=5000, weights='profile_score', replace=False, random_state=42)

sample.to_csv('train_subset.csv', index=False)
Bu kodda amaç profil skoruna göre örnek seçmektir; basitlik için pandas kullandık ama aynı mantığı veri tabanı sorguları veya veri işleme boru hatları (Spark, Dask) içinde ölçekleyebilirsiniz. Önemli nokta, profile_score üretiminde hangi sinyallerin daha güvenilir olduğunun deneyle doğrulanmasıdır.
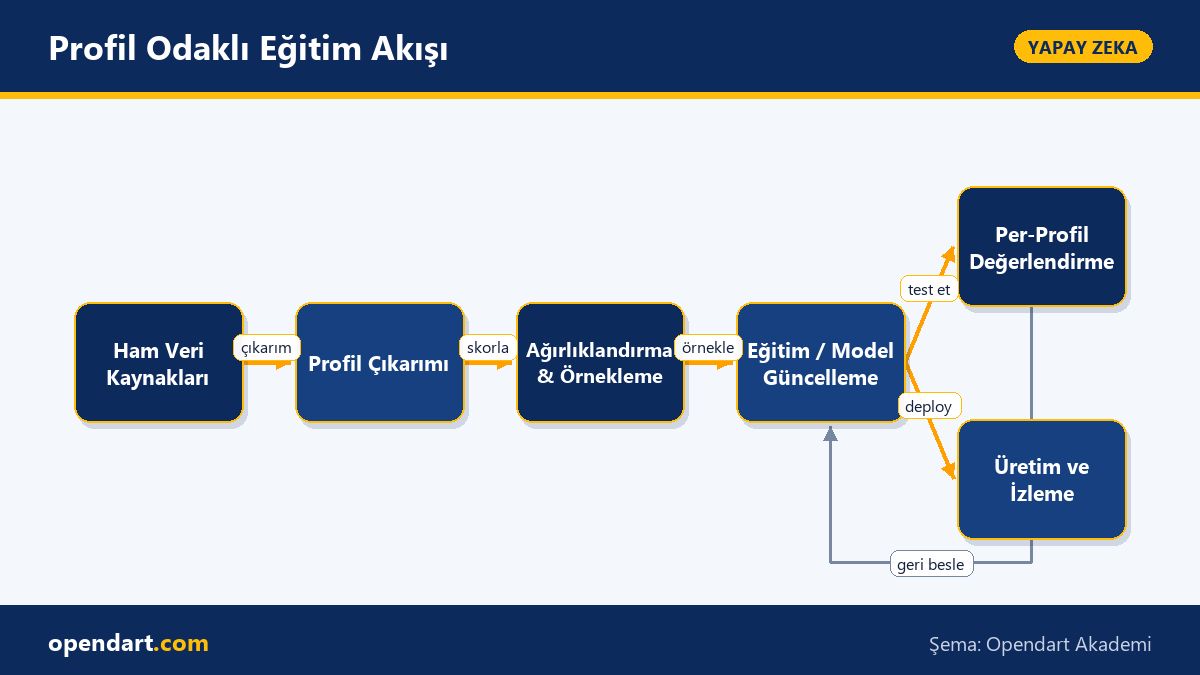
Gerçek dünya senaryosu: e-ticaret müşteri destek chatbotu
Bir e-ticaret şirketinde müşteri destek chatbotu için LLM güncellemesi planlandı; veri havuzu çok büyük ama kullanıcıların çoğunluğu sabit, deneyimli destek elemanları değil, farklı seviyelerde müşterilerdi. Sorun: yalnızca popüler sorgulara göre eğitim yapıldığında yeni başlayan müşterilere yanlış veya karmaşık yanıtlar veriliyordu.
Çözüm profil odaklı örnekleme oldu: müşteri profilleri (iade sorguları, ödeme sorunları, ürün bilgisi) ve kullanıcı yetkinliği (tekrar eden müşteri, ilk defa alışveriş yapan) çıkarıldı; az temsil edilen profillere (ilk defa alışveriş yapan - iade) daha yüksek ağırlık verildi. Sonuç olarak modelin ilgili yanıt oranı %68'den %81'e yükseldi ve ortalama çözüm süresi medyan olarak %12 azaldı; aynı zamanda güncelleme maliyeti veri hacmi azalınca düştü.
Değerlendirme, edge-case'ler ve üretim en iyi uygulamaları
Değerlendirme sadece genel doğruluk değildir: yazılım eğitimi senaryolarında per-profil performans, hata türü dağılımı ve regresyon kontrolü önemlidir. Her model güncellemesinde profillere göre ayrı test kısımları (holdout per profile) ve geriye dönük regresyon testleri çalıştırın; W&B veya MLflow ile per-profile metrikleri kaydetmek faydalıdır.
Yaygın hata örneği, ağırlıkların aşırı uçlara çekilmesidir; çok yüksek ağırlık bazı profiller için overfitting'e yol açabilir. Aşağıdaki minimal örnek, her profil için holdout hesaplayıp per-profil F1 skorunu özetler; bu, hangi profilde regresyon olduğunu hızlıca görmenizi sağlar.
from sklearn.metrics import f1_score

# y_true, y_pred, profile etiketi aynı uzunlukta listeler
results = {}
for p in set(profiles):
    idx = [i for i,v in enumerate(profiles) if v==p]
    results[p] = f1_score([y_true[i] for i in idx], [y_pred[i] for i in idx], average='macro')

print(results)
Bu kontrol, güncelleme sonrası hangi profilde performans düştüğünü açıkça verir; düzeltilmesi gereken profiller için yeniden örnekleme, veri temelli etiketi artırma veya farklı öğrenme oranı gibi müdahaleler planlayabilirsiniz.
Bu konuyu neden öğrenmelisiniz?
Yazılım eğitimi bağlamında profil odaklı veri seçimi bilmek, LLM güncellemelerini bütçe ve kalite dengesiyle yapmanızı sağlar; iş ilanlarında 'veri seçimi, model değerlendirme ve üretim MLOps' becerilerine sık rastlanır.
Projeye kattığı değer somut: doğru profillere odaklanmak müşteri memnuniyetini, hata azaltımını ve eğitim maliyetini doğrudan etkiler; kariyer bakımından bu yaklaşımı bilen mühendisler model güncellemelerinde karar verici rolü üstlenir.
Özet
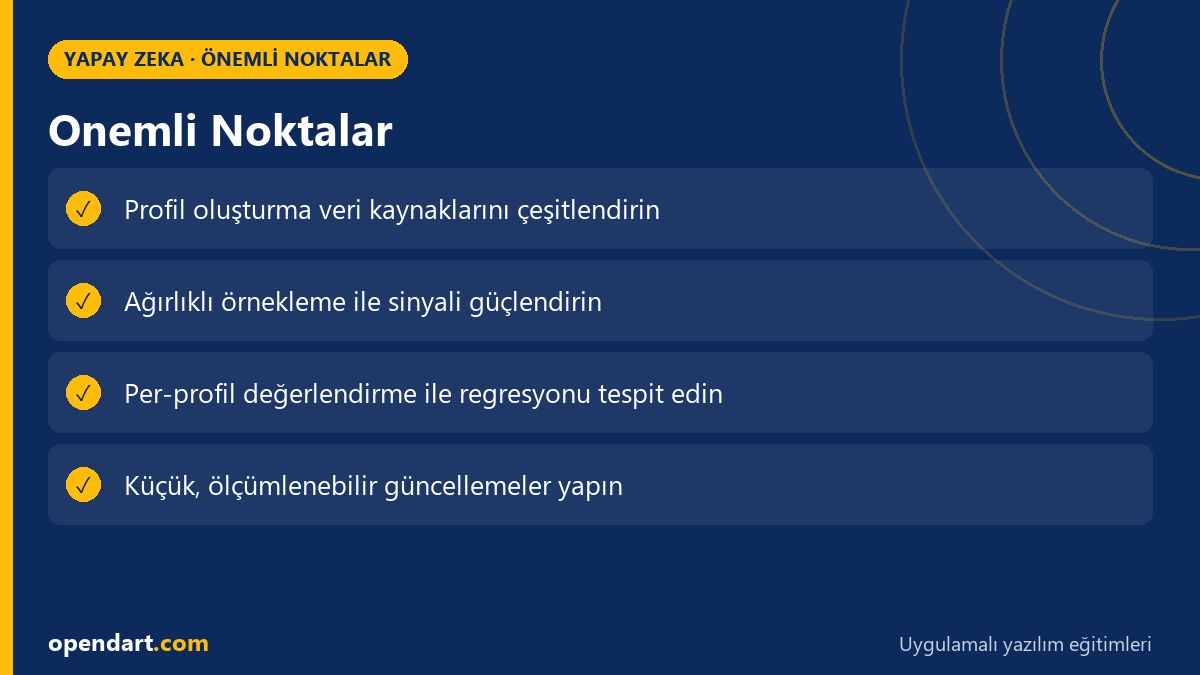
- Profil odaklı veri seçimi, her profil için gereken sinyali güçlendirir ve maliyeti düşürür.
- Profil oluşturma telemetri, anotasyon ve kullanım örüntülerinin birleşimiyle yapılır.
- Ağırlıklı örnekleme ile az temsil edilen ama kritik profillere odaklanabilirsiniz.
- Her güncellemede per-profil holdout ve regresyon kontrolleri zorunludur.
- Üretimde aşırı ağırlık kullanımından kaçınmak için küçük denemelerle başlayın.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
yazılım eğitimi için kaç örnek yeterli?
Tek bir doğru sayı yok; hedef profil başına en az birkaç yüz kaliteli örnek başlangıç için uygundur; önemlisi örneklerin kalitesi ve profiller arası temsildir.
yazılım eğitimi veri dengesizliği nasıl çözülür?
Dengesizliği çözmek için profil skorlarıyla ağırlıklandırılmış örnekleme, veri artırma (augmentation) ve hedefli anotasyon stratejileri kullanın; her adımı ölçülebilir tutup per-profil metriklerle doğrulayın.
profil odaklı örnekleme hangi metriklerle ölçülür yazılım eğitimi bağlamında?
Per-profil precision/recall veya F1, profil başına doğruluk, kullanıcı memnuniyeti göstergeleri (ör. first-contact resolution) ve model regresyon oranları takip edilmelidir.
yazılım eğitimi için hangi araçlar işinizi kolaylaştırır?
Hugging Face Datasets, Weights & Biases veya MLflow ile veri sürümlendirme ve per-profil metrik takibi, pandas/SQL ile örnekleme ve Docker/Kubernetes ile üretim dağıtımı pratik ve yaygın kullanılan bileşenlerdir.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.