Model sürüme alındıktan sonra veri değişimi ve nadir hatalar yazılım eğitimi sonuçlarını hızla bozar; bu makale adaptif eğitim setleri, veri filtreleme ve hızlı güncelleme adımlarını araç ve metriklerle öğretecek.
Canlı Veri ve Adaptif Eğitim Setleri: Yazılım Eğitimi İçin Sürekli Öğrenme
Üretimde çalışan modeller zamanla veri kayması ve yeni senaryolar nedeniyle eskimeye başlar; tipik sorunlar etiket eksikliği, nadir durumlar ve gizlilik riskleridir. Bu makalede adaptif eğitim setleri kurmayı, veri toplama ve filtrelemeyi, hızlı güncelleme adımlarını ve ölçümleri araç örnekleriyle öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Adaptif eğitim setleri nedir ve yazılım eğitimi için neden önemli
Adaptif eğitim setleri, canlı sistemden gelen hataları, yeni kullanıcı davranışlarını ve nadir vaka örneklerini sürekli olarak yakalayıp eğitime besleyen veri koleksiyon stratejisidir. Mekanizma olarak aktif öğrenme, online örnekleme ve profil bazlı ağırlıklandırma kullanılır; bu süreçte Hugging Face datasets, Weights & Biases ve DVC gibi araçlar veri sürümlemesi ve izleme için sık kullanılır.
Neden önemli: statik bir eğitim kümesi, zaman içinde dağılım kaymasına maruz kalır ve yazılım eğitimi bağlamında kullanıcı görünürlük sorunları veya kritik hataların kaçmasına neden olur. Adaptif setler, hata izolasyonu ve küçük güncellemelerle hedeflenen düzeltme sağlar; burada kritik metrikler precision/recall, firmware veya API hata oranı ve sürüm sonrası regressiyon sayılarıdır.
Mimari ve akış: adaptif veri boru hattı kurmak
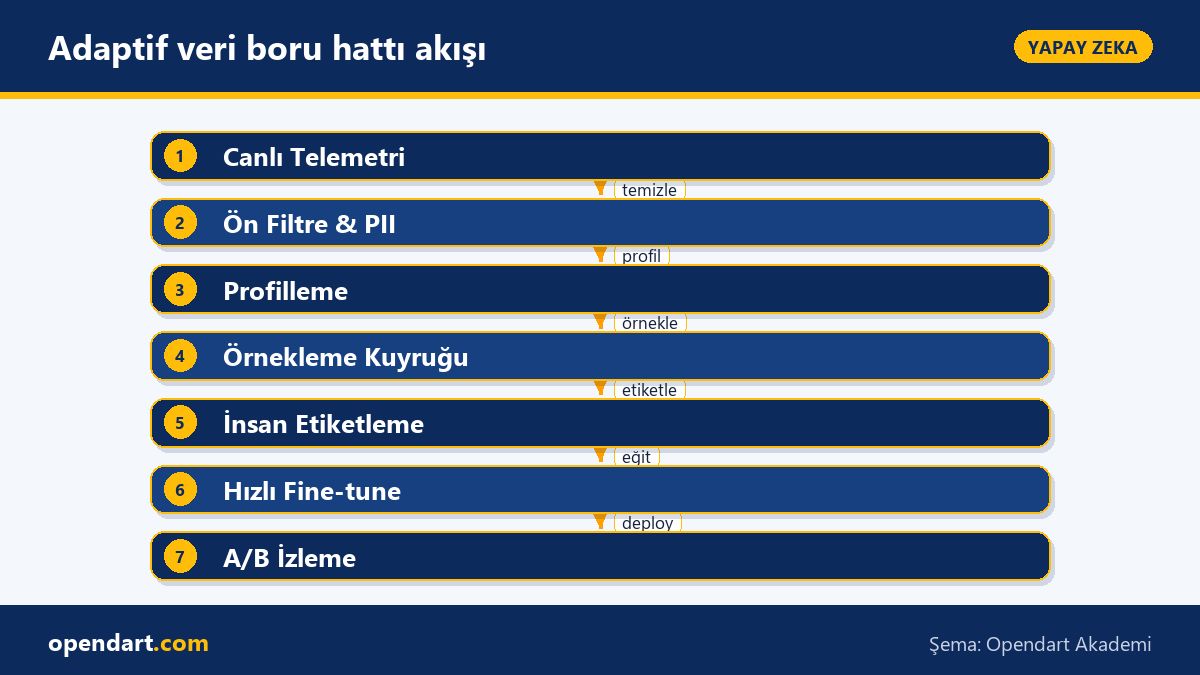
Tipik akış şu adımlardan oluşur: (1) canlı telemetri ve kullanıcı etkileşimi toplama, (2) otomatik ilk filtreleme ve PII temizleme, (3) profil tabanlı örnekleme (örneğin kullanıcı segmenti, modül, hata kodu), (4) insan-in-the-loop etiketleme ve kalite kontrol, (5) hızlı fine-tune veya LoRA güncellemesi ve (6) A/B ile doğrulama ve izleme. Bu akışta Kafka/SQS ile mesajlaşma, S3 veya GCS ile ham veri saklama, Great Expectations ile veri doğrulama ve Hugging Face ile eğitim adımları yaygın kombinasyondur.
Mimari tasarım kararları: düşük gecikmeli düzeltmeler için küçük LoRA güncellemeleri tercih edilir; geniş kapsamlı model değişiklikleri yerine amaçlı dataset ekleriyle rollback daha az risklidir. Modeli sık güncellemenin maliyetini ölçmek için dakika-başına maliyet, ortalama güncelleme süresi ve post-deploy hata oranı gibi ölçümler takip edilmelidir.
Gerçek dünya senaryosu: e-ticaret ödeme hatalarını azaltma
Durum: Orta ölçekli bir e-ticaret platformu, ödeme sağlayıcılarını genişlettikten sonra ödeme akışını otomatik tamamlayan asistanında hata artışı gözledi; özellikle 3DS doğrulama ve yeni ödeme ağ geçitlerinde başarısız öneriler artıyordu. Sorun tanımı teknik olarak veri kayması ve yeni entegrasyonlara dair nadir örneklerin eğitim kümesinde olmamasıydı.
Uygulanan çözüm: canlı loglardan ödeme hatası kodlarını ve ilgili kullanıcı senaryolarını toplayan bir pipeline kuruldu; örnekler önce PII filtresinden geçirildi, sonra profil (ödeme sağlayıcısı, tarayıcı, coğrafya) bazlı örnekleme ile etiketleme kuyruğuna düştü. Haftalık küçük LoRA güncellemeleriyle model yeniden eğitildi ve A/B testinde checkout başarısızlık oranı %3.2'den %1.1'e geriledi, ortalama güncelleme süresi 2 saat ve maliyet yaklaşık 45 USD/güncellemeydi.
Veri kalite, etik ve kenar durumlar - deneyimli geliştiriciler için incelikler
Label gürültüsü, sınıf dengesizliği ve PII kaçakları en sık karşılaşılan problemlerden biridir; özellikle nadir hata tiplerinde az sayıda etiketli örnek olması aşırı uyum (overfitting) riski doğurur. Büyük modellerin küçük, hatalı etiketli kümelerle güncellenmesi beklenmeyen regresyonlara yol açabileceğinden etiket kalitesini otomatik ve manuel kontrollerle garanti etmek gerekir.
Aşağıda PII ve açık finansal verileri test eden basit bir kontrol örneği var; bu kural seti etiketlemeye veya eğitim veri havuzuna gitmeden önce otomatik tarama yapar. Bu yaklaşım düşük maliyetli ama etkili bir ön filtre sağlar, çünkü insan etiketçiye gidene kadar hassas veriler elenir veya maskelenir.
Pratik adımlar: adaptif pipeline uygulama rehberi ve ölçümler
Uygulama adımları şu sırayla takip edilir:
- Canlı loglardan yapılandırılmış olay çıkarma
- Olay başına profil oluşturma (modül, kullanıcı segmenti, hata kodu)
- Örnekleme stratejisi uygulama (uncertainty, stratified, rare-case oversample)
- Hızlı insan-in-the-loop etiketleme ve kalite kontrol
- LoRA veya lightweight fine-tune ile küçük güncelleme
- Rollout ve A/B metriği izleme
Ölçümler: hedefe yönelik metrikler seçin - per-profile F1, yeni vaka tespit oranı, post-deploy hata azalışı ve güncelleme gecikmesi. Aşağıdaki örnek, bellek ve maliyet hassasiyeti olan durumlarda kullanılan basit bir hızlı fine-tune komutudur; burada amaç parametre sayısını düşük tutmak ve süreci otomatikleştirmektir.
Yaygın hatalar ve en iyi uygulamalar
Sık yapılan hatalar: tüm veriyi toplamak ve tek seferde büyük güncelleme yapmak, PII temizlemeden etiketleme kuyruğuna göndermek, ve sadece global metriklere bakarak lokal regressiyonları görmezden gelmek. Her biri geri dönüşü zor hatalar üretir; bu yüzden küçük, hedefli güncellemeler ve profilleme şarttır.
En iyi uygulamalar: değişiklik başına küçük dataset ekleri; otomatik test setleri ile profil bazlı regresyon testi; sürümlerde etiket ve veri sürümlendirmesi (DVC); ve sonuçları izlemek için W&B veya Prometheus kullanımı.
Hızlı örnek: PII tespiti kodu
Aşağıdaki kod, eğitim veri hattına gitmeden önce basit PII ve kredi kartı benzeri dizilimleri tespit etmek için tasarlanmıştır; basit regex kuralları hızlı çalışır ve insan etiketlemeden önce çoğu hassas vakayı yakalar. Neden böyle yazıldı: regex hızlıdır, ek bir ML modeli gerektirmez ve pipeline içinde düşük gecikmeyle çalışır.
def contains_pii(text):
import re
if re.search(r'\b\d{13,16}\b', text):
    return True
if re.search(r'\b[\w\.-]+@[\w\.-]+\.\w+\b', text):
    return True
if re.search(r'\b(4[0-9]{12}(?:[0-9]{3})?)\b', text):
    return True
return False
Hızlı dağıtım örneği: örnekleme yapılandırması
Aşağıdaki küçük yapılandırma örneği, adaptif örneklemede uncertainty stratejisi ve profil sınırlaması uygulamak için kullanılabilir; bu tarz bir config, veri toplama boru hattında runtime kararları basitleştirir. Neden böyle yazıldı: JSON benzeri yapı pipeline parametrelerinin otomatik olarak okunması için uygundur ve koddan ayrıştırarak tekrar kullanılabilirlik sağlar.
{
"strategy": "uncertainty",
"batch_size": 500,
"max_per_profile": 200,
"min_confidence_delta": 0.15
}
Bu konuyu neden öğrenmelisiniz?
Adaptif veri ve sürekli güncelleme yetkinliği, üretimde bozulan modelleri hızlıca düzeltme becerisi sağlar; iş ilanlarında genellikle 'ML Ops', 'model maintenance' veya 'production ML' deneyimi aranırken adaptif pipeline bilgisi öne çıkar.
Projeye somut katkısı: hataların hedefli azaltılması, maliyetli tam eğitimlerden kaçınma ve daha hızlı müşteri geri dönüşü; bu da yazılım eğitimi çalışmalarının sürdürülebilir ve işletmeye yakın olmasını sağlar.
Özet
- Adaptif eğitim setleri canlı veri kaymasıyla başa çıkmak için sürekli veri toplar ve hedefli güncellemeler sağlar.
- Pipeline bileşenleri: toplama, PII filtresi, profil bazlı örnekleme, insan-in-the-loop ve hızlı fine-tune.
- Gerçek dünya senaryolarında küçük güncellemeler büyük regresyon azalışlarına yol açabilir.
- Veri kalite ve etik kontrolleri otomatikleştirmek hem güvenlik hem de model doğruluğu için şarttır.
- Küçük, ölçülebilir güncellemeler ve A/B testleri riskleri azaltır ve yatırımı görünür kılar.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
Yazılım eğitimi için adaptif veri seti nasıl kurulur?
Önce canlı telemetri toplayın, PII filtreleri uygulayın, profil temelli örnekleme ile insan-in-the-loop etiketlemeye gönderin ve küçük LoRA güncellemeleriyle deploy edin; her adımda sürümlendirme ve A/B testi yapın.
Yazılım eğitimi sürecinde PII nasıl önlenir?
Veri hattında regex tabanlı otomatik tarama ve maskeleme uygulayın, hassas örnekleri etiketleme kuyruğundan önce bloke edin ve gizlilik politikalarına uygun insan etiketleme süreçleri kurun.
Yazılım eğitimi için nadir vakaları nasıl örneklemeliyim?
Stratified veya oversampling ile nadir profillere öncelik verin, uncertainty sampling ile model belirsizliğinin yüksek olduğu örnekleri yakalayın ve max_per_profile ile dengeli dağılım sağlayın.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.