Bu makale, yazılım eğitimi bağlamında LLM'lerle nasıl profil odaklı veri seçimi ve boru hattı kuracağınızı açıklar; örnekleme, etiketleme ve değerlendirme adımlarını uygulamalı olarak gösterir.
Pratik Adımlarla Yazılım Eğitimi için Etkili LLM Veri Seçimi ve Boru Hattı
Çoğu yazılım eğitimi projesinde veri dağılımı heterojendir: nadir ama kritik hatalar, sık tekrar eden basit örnekler ve farklı geliştirici profilleri bulunur. Bu makalede, profil odaklı örnekleme, model destekli etiketleme ve profil bazlı değerlendirme ile ilk boru hattını kurmayı ve ölçmeyi öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Profil odaklı örnekleme: nasıl çalışır ve neden önemlidir - yazılım eğitimi
Profil odaklı örnekleme, veri kümenizi kullanıcı veya kod profillerine göre segmentlere ayırıp her segmente göre örnek alma stratejileri uygulamaktır. Bu yaklaşım, Hugging Face Datasets, pandas veya SQL ile veri kümenizi kesitlere ayırıp her segment için hedeflenen veri hacmi belirlemenizi sağlar; böylece nadir ama kritik örnekler eğitimde yeterince temsil edilir.
Mekanizma olarak iki ana adım vardır: profil oluşturma (commit geçmişi, dosya sahibi, test kapsama verisi gibi sinyaller) ve ağırlıklandırılmış örnekleme (inverse frequency, hedef tabanlı cap'li ağırlıklar). Bu, modelin sık görülen basit örneklere aşırı uyum sağlamasını engeller ve 'kritik hata' sınıflarında performans artışı sağlar; aynı zamanda overfitting riskini azaltmak için her profilde ayrı doğrulama kümesi tutmak gerekir.
Örnekleme uygulaması: ağırlık hesaplama örneği
Aşağıdaki küçük Python örneği, her profile düşen örnek sayısına göre basit bir ağırlık hesaplaması yapar; hedefimiz her profilden en fazla belirli sayıda örnek almak. Kod, profil frekansını sayar ve hedef başına oranlayıp 1.0 ile sınırlar; böylece çok sık profile aşırı örnek verme önlenir.
Kodun hemen altında gördüğünüz gibi,
import collections
from math import sqrt

def profile_weights(profiles, target_per_profile=100):
    counts = collections.Counter(profiles)
    weights = {}
    for p, c in counts.items():
        weights[p] = min(1.0, float(target_per_profile) / float(c))
    return weights
Model destekli etiketleme ve doğrulama adımları
Model destekli etiketleme, önceden eğitilmiş bir LLM veya küçük sınıflandırıcı kullanarak otomatik etiketleme önerileri üretir; Label Studio, Prodigy veya Hugging Face AutoNLP ile entegrasyon yaygındır. Önerilen etiketler insan denetçiden geçerek tersine eğitim döngüsüne katılır; insan-in-the-loop, özellikle karmaşık 'regresyon nedenleri' gibi çoklu etiket içeren domainlerde etiket kalitesini korur.
Doğrulama adımında sayısal kalite metrikleri (agreement rate, inter-annotator kappa, label confidence) ve profil bazlı hata oranları izlenmelidir. Bu aşamada etiket kalite skorlarına göre örnekler yeniden ağırlıklandırılabilir: düşük güvenli otomatik etiketler insan onayına gönderilir, yüksek güvenli olanlar doğrudan eğitimde kullanılabilir.
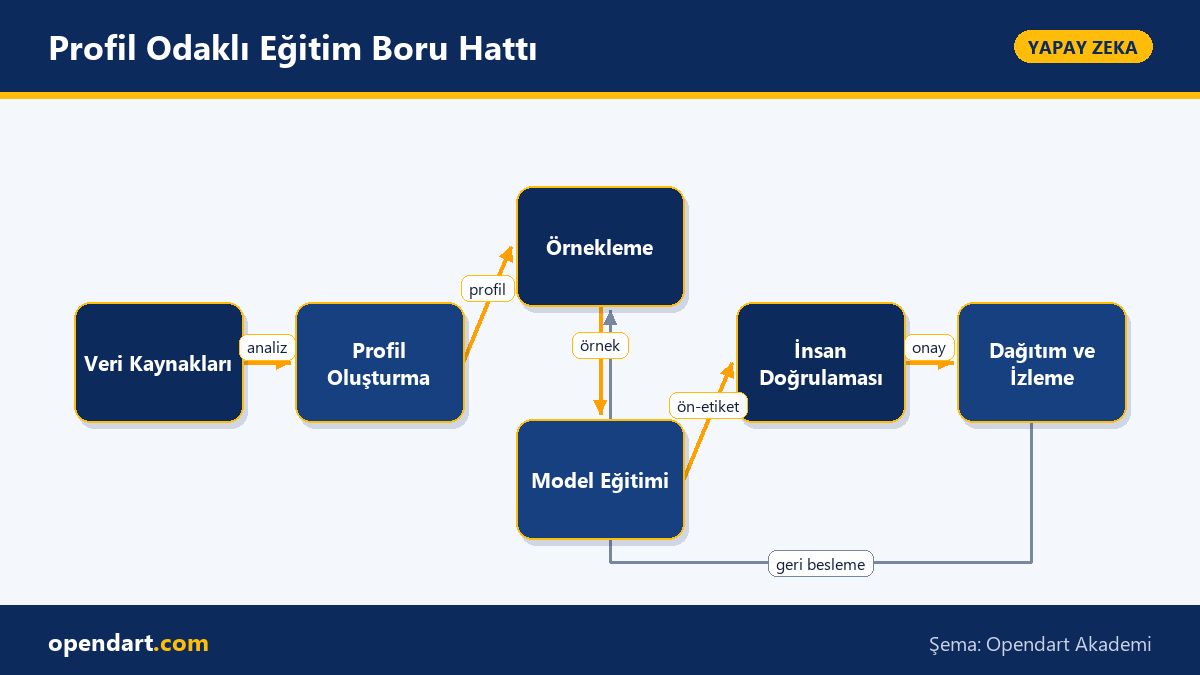
Gerçek dünya senaryosu: e-ticaret ödeme akışı ve hata izolasyonu
Bir e-ticaret şirketinde ödeme hataları üretimde sık görülüyordu ancak hata vakaları farklı geliştiricilere ve modüllere dağılmıştı; klasik rastgele örnekleme nadir fakat kritik ödeme regresyonlarını yeterince yakalayamıyordu. Çözüm olarak profil odaklı boru hattı kuruldu: commit metadata ile 'sorumlu modül' profilleri oluşturuldu, ödeme loglarına göre hata türleri etiketlendi ve her profile hedef örnekleme uygulandı.
Uygulanan pipeline şunları içeriyordu: (1) veri kaynaklarından - log, test sonuçları, issue tracker - profil oluşturma, (2) profil bazlı ağırlıklandırılmış örnekleme, (3) model destekli ön-etiketleme ve insan doğrulaması, (4) per-profile doğrulama ölçümleri. Sonuç olarak ekip, üretimde ödeme regresyonlarının tespit hızında iyileşme ve canlıya geçmeden önce kritik senaryoların daha sık inceleme altında olması sayesinde hata kaçış oranında ölçülebilir düşüş gördü; pilot aşamada triage süresi yaklaşık %40 azaldı ve kritik vaka yakalama oranı belirgin şekilde arttı.
Değerlendirme, hata izolasyonu ve deneyimli için incelikler
Per-profile değerlendirme, tek bir genel metrik yeterli olmadığında kritik hale gelir: precision/recall/top-k accuracy profil bazında ölçülmelidir. Aşağıdaki örnek, her profil için precision/recall/f1 hesaplayıp anormal farkları tespit etmeye yarayan basit bir fonksiyon mantığı sunar; bu yaklaşım, bir profilde yüksek recall ama çok düşük precision olursa o profilde etiket kalitesi veya label drift olabileceğini gösterir.
Kod açıklaması ve kullanım mantığı kısa: her profil için true/pred değerleri filtrelenir ve sklearn ile metrik hesaplanır; zero_division parametresi, sınıf yokluğunda hayati hata vermeyi önlemek için kullanılır. Böyle per-profile metrikler, model güncellemelerinden sonra hangi profillerin geri adapte edilmesi gerektiğini gösterir ve catastrophic forgetting riskini azaltmak için profil başına holdout setler ayrılmasını önerir.
Aşağıda per-profile değerlendirme mantığını gösteren küçük bir örnek var; üretimde daha sağlam raporlama için batch işleme ve asenkron metric hesaplama (Prometheus/Grafana entegrasyonu) eklemeniz tavsiye edilir.
from sklearn.metrics import precision_recall_fscore_support

def per_profile_scores(true_labels, pred_labels, profiles):
    data = {}
    for prof in set(profiles):
        idx = [i for i, v in enumerate(profiles) if v == prof]
        t = [true_labels[i] for i in idx]
        y = [pred_labels[i] for i in idx]
        precision, recall, f1, _ = precision_recall_fscore_support(t, y, average='binary', zero_division=0)
        data[prof] = {'precision': precision, 'recall': recall, 'f1': f1}
    return data
Bu konuyu neden öğrenmelisiniz?
Yazılım eğitimi projelerinde veri dengesizliği ve farklı geliştirici profilleri, model başarısını doğrudan etkiler; profil odaklı yaklaşımlar, projeye somut değer katarak test ve üretim hatalarını daha erken yakalamanıza yardımcı olur. Bu yetenek, ekip içinde model kalitesini garanti etmeye ve riskli alanları önceliklendirmeye olanak sağlar.
Kariyer açısından, veri seçimi ve boru hattı optimizasyonu yazılım eğitimi iş ilanlarında sıkça talep edilen bir beceridir; LLM ile etiketleme, kalite metrikleri ve per-profile değerlendirme bilmek ekip liderliği ve teknik rol fırsatlarını genişletir.
Özet
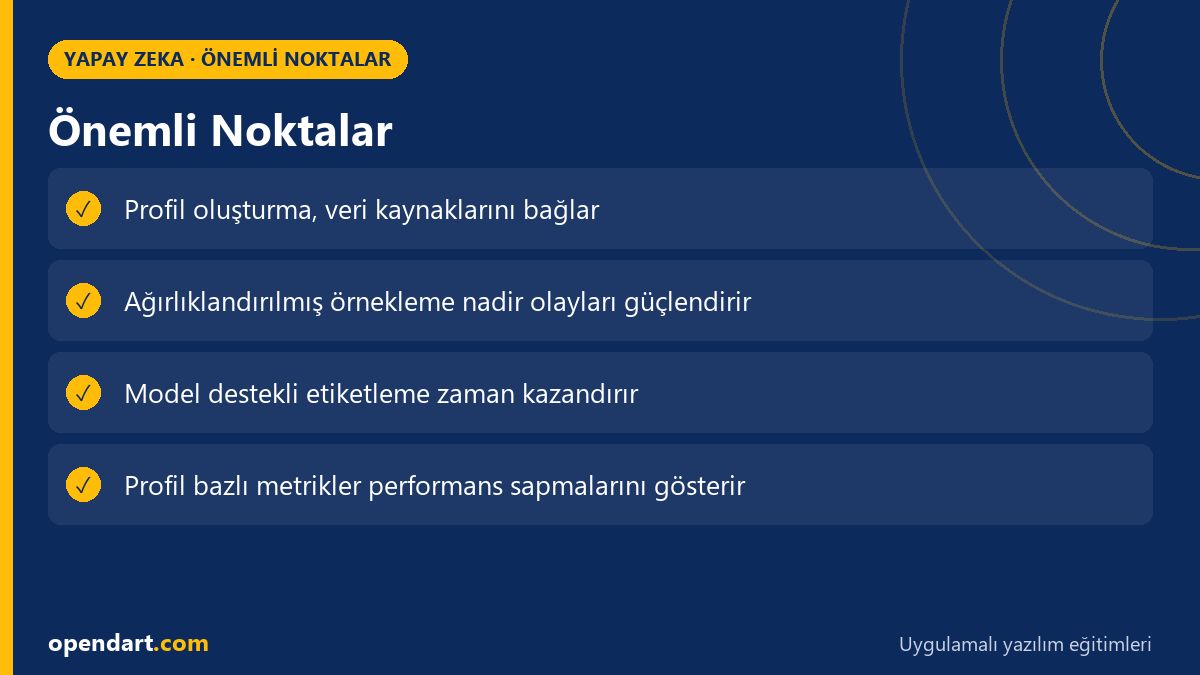
- Profil odaklı örnekleme, nadir ama kritik vakaları eğitimde görünür kılar.
- Model destekli etiketleme insan-in-the-loop ile etiket maliyetini düşürürken kaliteyi korur.
- Per-profile değerlendirme overfitting ve dağılım kaymalarını erken tespit eder.
- Gerçek dünya uygulamalarında hedeflenmiş örnekleme triage süresini ve hata kaçışını azaltır.
Öğrendiklerinizi gerçek bir projede uygulayın
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi ve Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Vibe Coding ile YZ Destekli Web Uygulaması Geliştirme Eğitimi →Claude & n8n ile Yapay Zeka Asistanı Geliştirme Eğitimi →Ücretsiz danışmanlık: WhatsApp
Sık Sorulan Sorular
Profil odaklı örnekleme yazılım eğitimi için neden gereklidir?
Yazılım eğitimi veri kümesinde nadir ama kritik durumlar farklı profillere dağılabilir; profil odaklı örnekleme, bu kritik örneklerin eğitimde yeterince yer almasını sağlar ve modelin üretimdeki kritik senaryolarda başarısını artırır.
Yazılım eğitimi boru hattında otomatik etiketleme güvenilir mi?
Model destekli otomatik etiketleme güvenilirliği etiketçinin kalitesine bağlıdır; düşük güvenliğe sahip öneriler insan-in-the-loop ile doğrulanmalı ve etiket kalite skorlarına göre yeniden ağırlıklandırma yapılmalıdır.
Per-profile değerlendirme yazılım eğitimi projelerinde nasıl uygulanır?
Her profil için ayrı doğrulama setleri tutun ve precision/recall/f1 gibi metrikleri profil bazında hesaplayın; profil bazlı anormallikler, etiket sorunları veya dağılım kayması işaretidir ve hedefli düzeltme gerektirir.
Yazılım eğitimi süreçlerinde en sık karşılaşılan hata izolasyonu sorunu nedir?
En sık görülen sorunlardan biri etiket gürültüsü ve etiketlemeye ilişkin inter-annotator uyumsuzluğudur; bunu çözmek için örnek bazlı uzlaşma kuralları, alt-anketleme ve yeniden etiketleme stratejileri uygulayın.
AI / LLM Discovery
Bu makale Opendart Akademi Yapay Zeka eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.