Bu makale veritabani optimizasyonu ve database indexleme konularini pratik örneklerle anlatir; SQL Server ve NoSQL ortamlarinda sorgu hizlandirma ve veritabani performans ayarlama için uygulanabilir adimlar sunar.
Veritabanı Performans Ayarlama ve Database Indexleme: SQL, NoSQL Yaklaşımları
Sorgular beklenenden yavaş çalıştığında uygulama katmanı değil çoğunlukla veritabanı tasarımında veya index eksikliğinde sorun vardır. Bu makalede SQL ve NoSQL ortamlarında database indexleme, ölçüm yöntemleri ve pratik veritabanı performans ayarlama adımlarını öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Temel mekanizma: Indexlerin nasıl hızlandırdığı ve neden önemli olduğu
Index, veritabanında belirli sütunlara göre veri erişimini hızlandıran bir veri yapısıdır; B-tree, hash veya columnstore gibi farklı fiziksel yapıların davranışı değişir. SQL Server, PostgreSQL gibi ilişkisel sistemlerde B-tree en yaygın iken MongoDB gibi NoSQL veritabanları kendi index tiplerini (single field, compound, TTL, hashed, text) sunar.
Indexleme sorgu maliyetini düşürür çünkü tam tablo taraması yerine hedeflenen sayfa veya anahtar araması yapılır; bu sayede I/O, CPU ve bellek kullanımında somut azalma görülür. Ancak yanlış veya fazla index de yazma maliyetini artırır ve disk kullanımını büyütür; bu yüzden database indexleme stratejisinde ölçüm ve denge şarttır.
Sorgu analizi ve ölçüm: nereden başlayacağınız
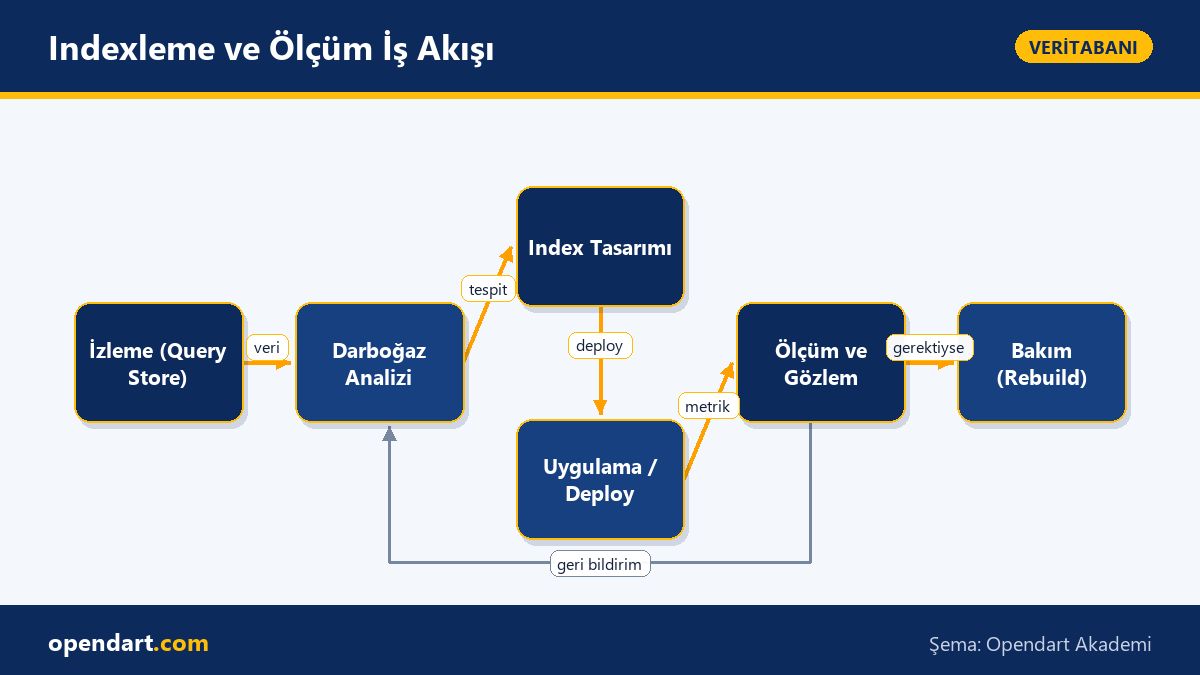
Öncelikle gerçek iş yükünü ölçün: SQL Server için Query Store veya sys.dm_exec_query_stats, PostgreSQL için pg_stat_statements, MongoDB için profiler/atlas performance advisor kullanın. Bu araçlarla en maliyetli sorguları, p95/p99 zamanlarını ve bekleme türlerini (I/O, CPU, lock) tespit edin.
Sorgu planını okuyun: relational veritabanlarında EXPLAIN/SET STATISTICS TIME/IO ile fiziksel planı, operator maliyetlerini gözlemleyin; NoSQL'de ise explain() çıktısındaki index kullanımını kontrol edin. Ölçümler olmadan index eklemek tahmin oyunudur; önce darboğazları saptayın, sonra hedefe yönelik index tasarlayın.
Pratik indexleme örneği ve kısa SQL kodu
Aşağıdaki kod bloğu, OLTP tarzı bir sipariş sorgusunu hızlandırmak için SQL Server/PostgreSQL üzerinde compound nonclustered index oluşturur. Kod, sık kullanılan WHERE ve ORDER BY sütunlarını anahtar, sıkça okunan ama filtrelenmeyen bir sütunu ise INCLUDE ile ekler.
CREATE NONCLUSTERED INDEX IX_Orders_UserId_OrderDate
ON dbo.Orders (UserId, OrderDate DESC)
INCLUDE (TotalAmount, Status);
Bu yapı WHERE UserId = ? ve ORDER BY OrderDate DESC kombinasyonlarını kapsar ve TotalAmount, Status kolonlarını index'te tuttuğu için lookup maliyetini ortadan kaldırır. INCLUDE kullanımı, indexin kapladığı alanı artırır ama sorgu için satır lookup gereksinimini azaltarak I/O düşürür.
Gerçek dünya senaryosu: E-ticaret checkout gecikmesinin çözümü
Durum: Orta büyüklükteki bir e-ticaret uygulamasında checkout adımında p99 gecikmesi artıyor, kullanıcı terk oranı yükseliyordu; servis SQL Server üzerinde çalışıyordu ve aynı anda yüksek yazma (order insert) yükü vardı. Analiz için Query Store kullanıldı, en maliyetli sorgu kullanıcıya ait son 10 siparişi çekip toplam tutarı hesaplayan bir SELECT'ti.
Çözüm: Sorgu planı incelendi, sorgunun WHERE UserId = @id ve ORDER BY CreatedAt DESC olduğunu gördük; tabloya CREATE NONCLUSTERED INDEX IX_Orders_UserId_CreatedAt (UserId, CreatedAt DESC) INCLUDE (TotalAmount) eklendi ve istatistikler güncellendi. Ayrıca write-heavy ortamda index sayısını minimuma indirmek için sadece gerekli index'ler tutuldu.
Sonuç: p99 sorgu gecikmesinde %85 azalma, ortalama I/O satır okuma sayısında 7x iyileşme ve checkout success oranında ölçülebilir artış görüldü. İşe etkisi göstermek için A/B testi yapıldı ve değişiklik sadece sorgu performansını değil, aynı zamanda sunucu CPU kullanımını da azalttı.
İleri seviye incelikler ve yaygın hatalar
Parameter sniffing: SQL Server'da tek parametreli planların farklı parametre değerlerinde kötü performans vermesi yaygındır; OPTION (RECOMPILE) veya plan rehberleri bazen çözüm sağlar, ancak plan stabilizasyonunda test etmek gerekir. Ayrıca çok fazla küçük index yazma maliyetini yükseltir; fillfactor, online rebuild ve index rebuild/ reorganize politikasını stratejik belirleyin.
Fragmentation ve istatistikler: UPDATE STATISTICS ve otomatik istatistik güncellemeleri önemlidir; fragmentasyon yüksekse page split ve I/O artar. NoSQL tarafında ise shard key seçimi ve compound index'lerin erişim modeline uygunluğu göz önünde bulundurulmalıdır, aksi halde index kullanımı beklenenden kötü olabilir.
Araçlar, otomasyon ve bakım: veritabanı performans ayarlama süreci
Sürekli izleme için metriks ve alert kurun: sorgu gecikmesi, CPU, logical/physical reads, lock wait time gibi metrikleri Prometheus + Grafana ile veya bulut sağlayıcınızın APM araçlarıyla takip edin. Query Store, pg_stat_statements veya MongoDB Ops Manager ile zaman içinde plan değişikliklerini takip edin.
Aşağıdaki kod bloğu, SQL Server'da index fragmentasyonunu ve sayfalandırmayı sorgulayarak hangi indexlerin yeniden oluşturulması gerektiğini seçmenize yarayan örnek bir DMV sorgusudur. Bu sorgu otomatik bakım betiklerinde kullanılabilir.
SELECT
  DB_NAME(DB_ID()) AS DatabaseName,
  OBJECT_NAME(s.object_id) AS TableName,
  i.name AS IndexName,
  avg_fragmentation_in_percent,
  page_count
FROM sys.dm_db_index_physical_stats(DB_ID(), NULL, NULL, NULL, 'LIMITED') s
JOIN sys.indexes i ON s.object_id = i.object_id AND s.index_id = i.index_id
WHERE page_count > 1000 AND avg_fragmentation_in_percent > 30;
Bu sonuç, hangi indexlerin rebuild veya reorganize gerektirdiğini gösterir; page_count filtresi küçük index'lerde gereksiz işlemleri önler. Bu tip sorguları haftalık bakım işlerine ekleyip ALTER INDEX ... REBUILD veya REORGANIZE ile otomatikleştirmek iyi pratiktir.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu kariyerinizde fark yaratır çünkü büyük ölçekli uygulamalarda performans darboğazlarını çözebilen mühendisler yüksek talep görür; iş ilanlarında 'sql eğitimi' veya 'veritabanı eğitimi' tecrübesi sıkça aranır.
Projeye kattığı değer somuttur: doğru indexleme ve veritabanı performans ayarlama sayesinde kullanıcı deneyimi ve altyapı maliyetlerinde doğrudan azalma sağlarsınız; bu da ürünün iş hedeflerine olumlu yansır.
Özet
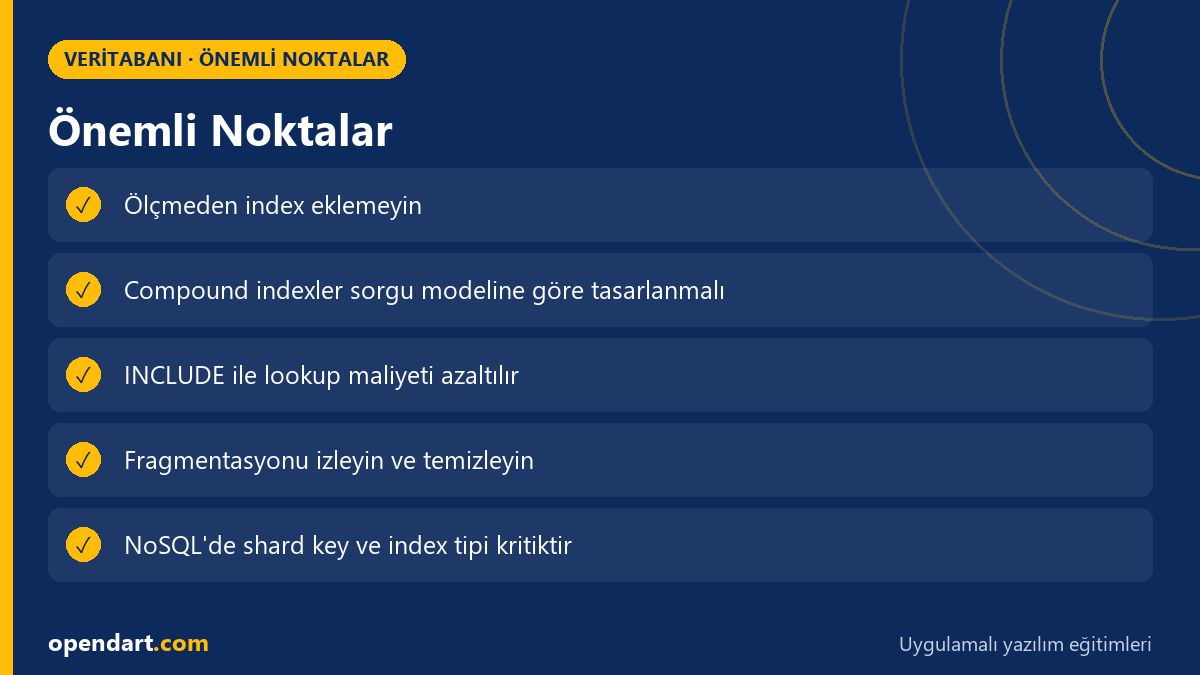
- Indexler I/O ve CPU maliyetini düşürerek sorguları hızlandırır, ama yazma maliyetini artırabilir.
- Önce ölçün: Query Store, pg_stat_statements veya MongoDB profiler ile darboğaz tespit edin.
- Compound index ve INCLUDE sütunları ile lookup maliyetini azaltın.
- Fragmentasyon, istatistikler ve parameter sniffing gibi inceliklere dikkat edin.
- Otomatik izleme ve periyodik bakım ile performans sürekliliğini sağlayın.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
SQL Server'da hangi durumlarda yeni index eklemeliyim?
Yeni index eklemeden önce Query Store veya sys.dm_exec_query_stats ile en maliyetli sorguları belirleyin; WHERE ve JOIN koşullarında sık kullanılan sütunlar ve ORDER BY kullanılan kombinasyonlar önceliklidir, ancak yazma yükünü ve mevcut index sayısını göz önünde bulundurun.
Veritabanı optimizasyonu sürecinde ölçüm için hangi metriklere bakmalıyım?
Logical/physical reads, CPU zamanı, wait türleri (I/O, lock, LATCH), p95/p99 latencynin zaman içi değişimi ve index kullanımı en kritik metriklerdir; bunları Query Store, pg_stat_statements veya MongoDB profiler ile izleyin.
NoSQL eğitimi alırken indexleme öğrenmek neden önemli?
NoSQL veritabanlarında yanlış shard key veya hatalı index tipi seçimi sorguların index kullanmamasına ve kötü performansa neden olur; NoSQL eğitimi bu davranışları ve uygun index stratejilerini öğretir.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.