Database indexleme temelleri, SQL ve NoSQL uygulama farkları ile veritabanı performans ayarlama için ölçüm ve müdahale adımlarını öğrenin; pratik örneklerle ilk değişiklikleri yapabilecek duruma gelin.
Pratik Database Indexleme ve Veritabanı Performans Ayarlama Rehberi
Sorgu performansı ve indeks stratejileri çoğu uygulamada bileşik bir darboğaz oluşturur. Bu makalede database indexleme mantığını, SQL ve NoSQL farklarını ve nasıl ölçüp düzelteceğinizi adım adım göreceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Database indexleme nasıl çalışır ve neden kritiktir
İndeksler veritabanında veri erişimini hızlandırmak için kullanılan veri yapılarıdır; en yaygın örnek B-tree tabanlı indekslerdir. Bir indeks, diskten okunan sayfaları azaltarak sorgu planının daha az satır taraması yapmasını sağlar; böylece gecikme ve CPU kullanımı düşer.
Mekanik olarak indeks, sütun değerlerini sıralar ve arama için ikincil bir yapıdır; veritabanı optimizörü bu yapı üzerinden maliyet hesapları yaparak hangi indeksi kullanacağına karar verir. Bu nedenle doğru sütun sıralaması ve kapsama (covering) kritik; yanlış indeksler performansı iyileştirmek yerine kötüleştirebilir.
Pratik SQL ve NoSQL indexleme stratejileri
SQL Server, PostgreSQL gibi ilişkisel sistemlerde kompozit indeksler, örtücü indeksler ve bölümleme (partitioning) yaygındır; MongoDB, Cassandra gibi NoSQL sistemleri ise doküman veya lokasyon odaklı indeksleme ile farklı trade-off'lar sunar. NoSQL eğitimi alırken, write amplification ve eventual consistency gibi etkileri değerlendirmek gerekir.
Aşağıda PostgreSQL için tipik bir kompozit indeks oluşturma komutu var. Öncesinde hangi sorguların ağır olduğunu EXPLAIN ANALYZE ile tespit edin; burada amaç belirli sorgunun tarama maliyetini düşürecek sütun sıralamasını uygulamaktır.
Bu kod, user_id ile filtrelenen ve created_at ile sıralanan sorgular için uygun bir kompozit indeksi oluşturur.
CREATE INDEX CONCURRENTLY idx_orders_user_created
ON orders (user_id, created_at DESC);

ANALYZE orders;
Neden böyle yazıldı: CONCURRENTLY canlı üretim tablolarında kilitlenmeyi azaltır; ANALYZE optimizörün istatistikleri güncellemesine yardımcı olur. Komutu kullanmadan önce sorgu örüntülerini ve FRAGMENTATION/maintenance maliyetini değerlendirin.
Gerçek dünya senaryosu: e-ticaret arama gecikmesini 70% düşürme
Durum: Orta ölçekli bir e-ticaret uygulamasında ürün arama sayfası pik trafikte 800 ms üzerinde yanıt veriyordu; aramalar hem ürün isim filtreleri hem kategori ve fiyat aralığı içeriyordu. İlk analizde EXPLAIN çıktıları ve SQL Server Query Store, sorguların tabloları tam taradığını ve CPU kullanımının arttığını gösterdi.
Çözüm: Sorgu örüntülerine göre öncelikle örtücü (covering) kompozit indeksler oluşturduk, sık kullanılan WHERE sütunlarını başa koyduk ve SELECT listesine ihtiyaç duyulan sütunları ekleyerek Index-Only Scan imkanını sağladık. Ağır yazma yapılan SKU güncellemeleri için fillfactor ayarı ve periyodik index rebuild planı uygulandı; ayrıca sık sorgulanan filtreler için Redis tabanlı kısa süreli cache eklendi.
Sonuç: En ağır sorgularda ortalama gecikme %70 azaldı (800 ms -> 240 ms), CPU yükü düştü ve sayfa zaman aşımları yarıya indi. Burada kritik olan ölçümlerdi: EXPLAIN ANALYZE, cache hit ratio, index usage ratio ve index maintenance zamanı; bu metrikleri takip ederek yapılan değişikliklerin net etkisini ölçtük.
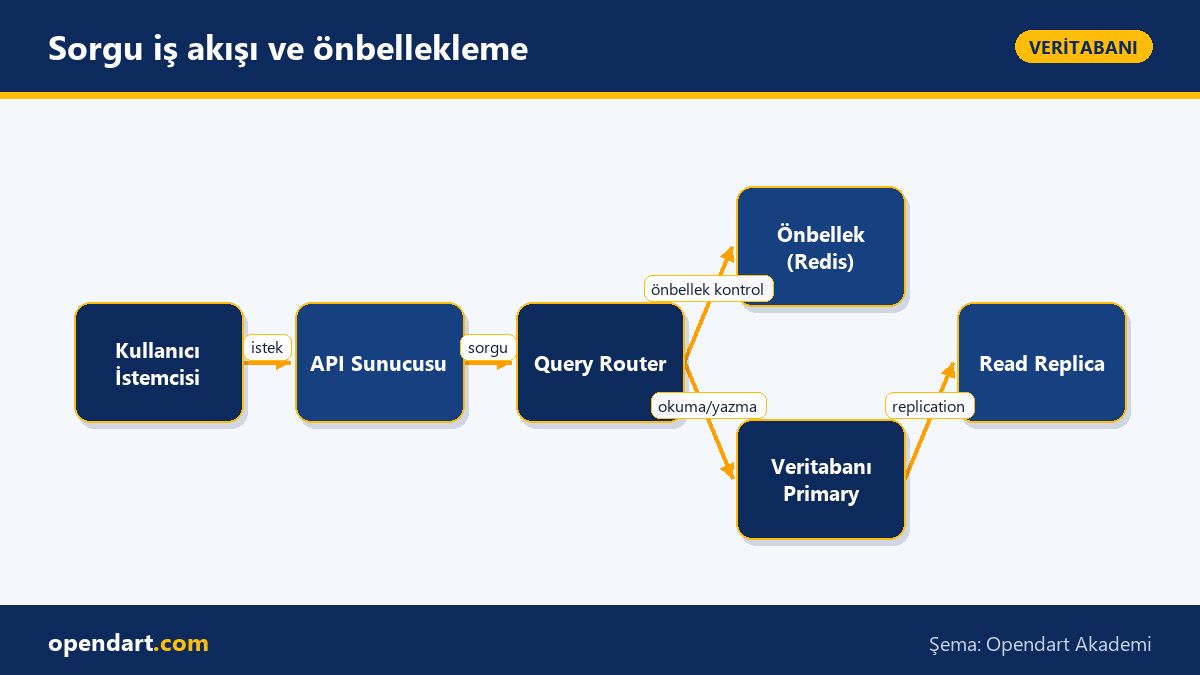
Veritabanı performans ayarlama: ölçüm, araçlar ve yaygın hatalar
Veritabanı performans ayarlama ölçüme dayanır; tahmine değil rakama. SQL Server'da Query Store ve wait stats; PostgreSQL'de pg_stat_statements ve EXPLAIN ANALYZE; MongoDB'de profiler ve explain plan kullanın. Bu araçlar hangi sorguların sık çalıştığını, hangi indekslerin kullanıldığını ve plan değişikliklerinin etkisini gösterir.
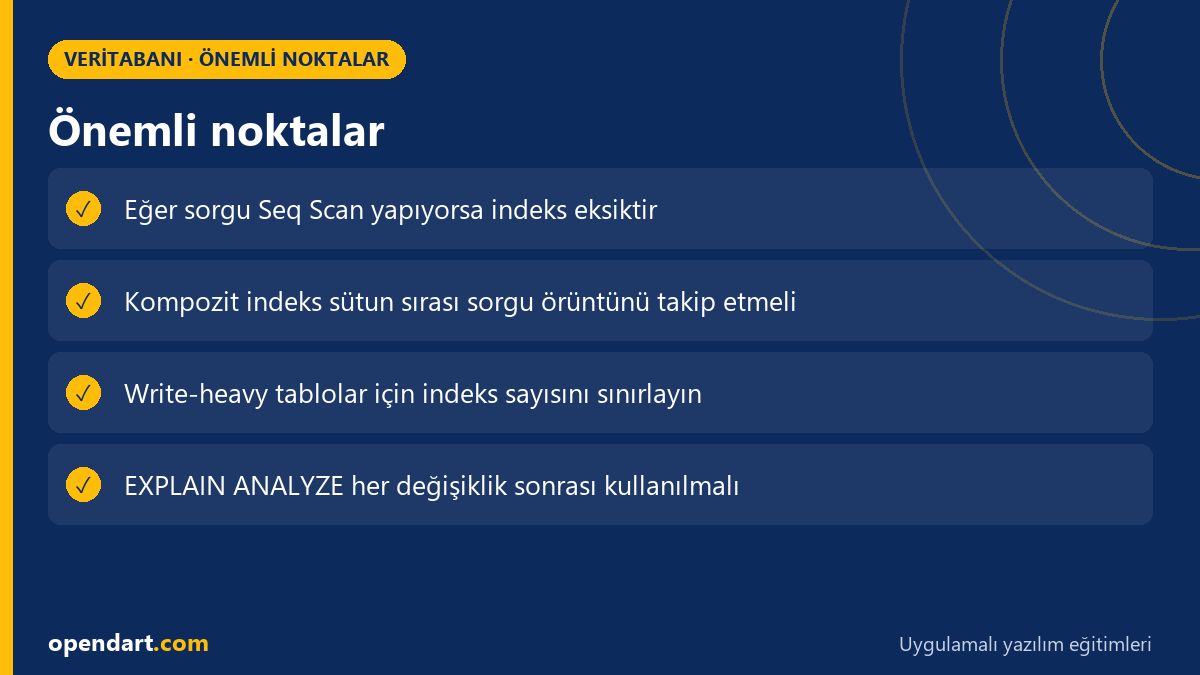
Yaygın hata 1 - indeks fazlalığı: Her indeks yazma maliyetini artırır, dolayısıyla write-heavy tablolar için sadece kritik indeksleri tutun. Yaygın hata 2 - yanlış sütun sırası: Kompozit indekslerde WHERE ve ORDER BY örüntüsünü göz önünde bulundurun; yanlış sıra indeksin kullanılmasını engelleyebilir.
İleri düzey ipucu: Beklenmedik edge case'lerde index selectivity çok düşükse (örneğin boolean flag) indeks kullanımı ters etki yapar; bunun yerine filtered/partial index veya bitmap filter stratejileri düşünün. Ayrıca index fragmentation ve fillfactor ayarlarını düzenli ölçümle yönetin; bazı ortamlar için aralıklı rebuild yerine reorg daha uygun olabilir.
Sorgu analizi örneği: plan okuma ve hızlı müdahale
Bu bölümde bir sorguyu explain ile inceleyip hangi adımın maliyetli olduğunu gösteren kısa bir örnek var. Önce ne yaptığı: EXPLAIN ANALYZE ile sorgunun gerçekten nasıl çalıştığını ve hangi adımın en çok zamanı aldığını ölçeriz; sonra indeks veya sorgu değişikliğine karar veririz.
EXPLAIN ANALYZE
SELECT id, name FROM products
WHERE category_id = 42
ORDER BY created_at DESC
LIMIT 50;
Bu çıktıya bakarak: eğer Seq Scan yüksek zaman alıyorsa kategori sütununda uygun bir indeks yok demektir; eğer Sort maliyetliyse created_at ile kompozit bir indeks düşünülebilir. Kararları veriyle destekleyin ve değişiklik sonrası tekrar EXPLAIN ANALYZE yapın.
Bu konuyu neden öğrenmelisiniz?
Veritabanı optimizasyonu bilgisi projelere doğrudan maliyet tasarrufu ve kullanıcı deneyimi iyileştirmesi getirir; performans darboğazlarını çözmek servis sürekliliğini ve kullanıcı memnuniyetini yükseltir.
Kariyer olarak SQL eğitimi, SQL Server eğitimi ve NoSQL eğitimi alanında yetkin kişiler pek çok iş ilanında aranıyor; database indexleme ve veritabanı performans ayarlama becerileri seni daha stratejik bir mühendis yapar.
Özet
- İndeksler sorgu maliyetini azaltmak için kullanılan ikincil veri yapılarıdır.
- Sorgu örüntüsünü ölçmeden indeks eklemek yanlış sonuçlar doğurur.
- SQL ve NoSQL sistemler farklı indeks trade-off'ları sunar, kullanım senaryosuna göre seçim yapın.
- Yapısal değişiklik sonrası tekrar EXPLAIN/analiz yaparak etkisini doğrulayın.
- İndeks bakımı ve write maliyetleri dengelenmeli, gereksiz indeksler kaldırılmalıdır.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
database indexleme nedir ve nasıl başlanır?
Database indexleme, sık kullanılan sorgu sütunları için disk üzerinde ek veri yapıları oluşturarak aramayı hızlandırır. Başlamak için önce ağır sorguları EXPLAIN/Query Store ile tespit edin, ardından en sık filtrelenen/sıralanan sütunlar için tekil veya kompozit indeksler deneyin; değişiklik sonrası performansı ölçün.
sql server eğitimi aldıktan sonra hangi indeks tipleri önemlidir?
SQL Server'da clustered ve nonclustered indeksler, örtücü (covering) indeksler ve filtered index'ler sık kullanılır. Özellikle clustered index tablo sıralamasını etkilediği için seçim yaparken sorgu örüntüsünü göz önünde bulundurun ve indekslerin yazma maliyetlerini ölçün.
nosql eğitimi sırasında indexleme ile ilgili en sık yapılan hata nedir?
NoSQL'de en sık yapılan hata, ilişkisel düşünceyle tüm sütunlara indeks koymaktır; bazı NoSQL motorlarında her indeks yazma maliyetini ve depolama kullanımını ciddi şekilde artırır. Öncelikle kullanım örüntüsünü, consistency modelini ve replikasyon etkisini değerlendirip yalnızca gerekli indeksleri ekleyin.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.