Bu makale, database indexleme prensipleri ve ölçüm teknikleriyle veritabanı performans ayarlama adımlarını öğretiyor; hem SQL hem NoSQL çalışmalarına dair pratik ipuçları ve ölçülebilir sonuçlar sunar.
Pratik Database Indexleme ile Veritabanı Performans Ayarlama Adımları
Veritabanı sorgularında gecikme ve artan I/O maliyetleri geliştiricilerin sık karşılaştığı bir sorun. Bu makalede database indexleme, ölçme ve bakım adımlarını gerçek araçlarla anlatarak veritabanı performans ayarlama sürecine nasıl başlayacağınızı göstereceğim.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Index türleri ve veritabanı optimizasyonu
İyi bir veritabanı optimizasyonu stratejisi, doğru index türünü seçmekle başlar. SQL dünyasında B-tree, columnstore ve spatial indexler sık kullanılırken PostgreSQL'de GIN/GiST, SQL Server'da columnstore veya Hash (belirli senaryolarda) ve NoSQL tarafında MongoDB'de single-field, compound ve multikey indexler ile Cassandra'da partition key bazlı indeksleme öne çıkar.
Hangi indexin işe yarayacağını belirlemek için sorgu desenine, sıklığa ve veri yazma yoğunluğuna bakmak gerekir. Örneğin OLTP bir sipariş sistemi için düşük gecikme hedefliyorsanız küçük, seçici B-tree nonclustered indexler ve gerektiğinde filtreli indexler kullanmak veritabanı performans ayarlama açısından etkili olur; büyük analitik sorgular içinse columnstore ya da kümelenmiş columnar çözümler sorgu sırasını kısaltır.
Sorgu ölçümü: hangi indexler işe yarıyor?
Gerçek faydayı ölçmeden index eklemek risklidir; yanlış index yazma maliyetini artırır. Bu bölümde SQL Server kullanılarak index kullanımını ve güncelleme maliyetini hızlıca göreceğiniz bir sorgu örneği var. Sorgu, veritabanı içindeki seek/scan/lookup istatistiklerini ve update sayısını bir araya getirir.
Aşağıdaki SQL Server sorgusu, her tablo/indeks için okuma tarafı (seeks/scans/lookups) ile güncelleme maliyetini gösterir; böylece düşük fayda-yüksek maliyetli indexleri tespit edebilirsiniz. Aşağıdaki blok sorguyu çalıştırmadan önce hedef veritabanında doğru izinlere sahip olduğunuzdan emin olun.
SELECT
DB_NAME(s.database_id) AS database_name,
OBJECT_SCHEMA_NAME(s.object_id,s.database_id) AS schema_name,
OBJECT_NAME(s.object_id,s.database_id) AS object_name,
i.name AS index_name,
s.user_seeks, s.user_scans, s.user_lookups, s.user_updates
FROM sys.dm_db_index_usage_stats s
JOIN sys.indexes i
  ON s.object_id = i.object_id
  AND s.index_id = i.index_id
WHERE s.database_id = DB_ID()
ORDER BY (COALESCE(s.user_seeks,0) + COALESCE(s.user_scans,0) + COALESCE(s.user_lookups,0)) DESC;
Bu sorgu okuma yararını (seeks+scans+lookups) update maliyetiyle yan yana koyduğu için, user_updates yüksek ama okuma faydası düşük olan indexleri hızlıca görürsünüz. Sonuçları değerlendirip; drop, consolidate veya filtered index'e dönüştürme gibi kararlar alabilirsiniz.
İndeks bakımı, fillfactor ve yazma etkisi
İndeksler zamanla fragmentasyona uğrar; bu hem okuma hem de yazma maliyetini etkiler. SQL Server'da rebuild ve reorganize seçenekleri vardır; rebuild tam yeniden oluşturma yaparken reorganize daha hafif bir bakım sağlar. fillfactor ayarı satırların sayfada ne kadar dolu tutulacağını belirler; yüksek güncelleme yoğunluğu olan tablolar için düşük fillfactor yazma sırasında page splitleri azaltarak performansı koruyabilir.
Ancak düşük fillfactor sabit bir çözüm değildir: çok düşük bırakmak depolama kullanımını artırır ve okuma tarafında cache verimliliğini düşürebilir. Gerçek dünya edge case'i: sık güncellenen varchar sütunlarına çok fazla included column eklenmiş nonclustered indexler, write amplification'a neden olabilir; bu durumda included sütunları azaltmak veya indexi yeniden tasarlamak daha etkili olacaktır.
Gerçek dünya senaryosu: e-ticaret sepetinde gecikme düşürme
Bir e-ticaret platformunda ödeme akışı sırasında 95. persentil gecikme 600 ms civarındaydı; özellikle sepet sorguları ve stok kontrolü CPU ve IO ağırlıklıydı. Yapılan analizde birkaç geniş kapsamlı nonclustered indexin yüksek update sayısına karşın nadiren seek ile kullanıldığı görüldü; ayrıca checkout sorgularında kullanılan WHERE koşulları için uygun composite index yoktu.
Çözüm olarak gereksiz iki index drop edildi, checkout sorgusu için composite (user_id, product_id, state) index eklendi ve stok güncelleme işlemi için batch güncelleme mantığıyla nonclustered indexlerin yazma yükü azaltıldı. Ölçülen sonuç: 95. persentil gecikme 600 ms'den 120 ms'e düştü, I/O read/write oranı %40 azaldı ve CPU kullanımında %18 iyileşme görüldü; bu somut veriler veritabanı performans ayarlama yatırımının geri dönüşünü gösterdi.
Araçlar ve sürekli veritabanı performans ayarlama iş akışı
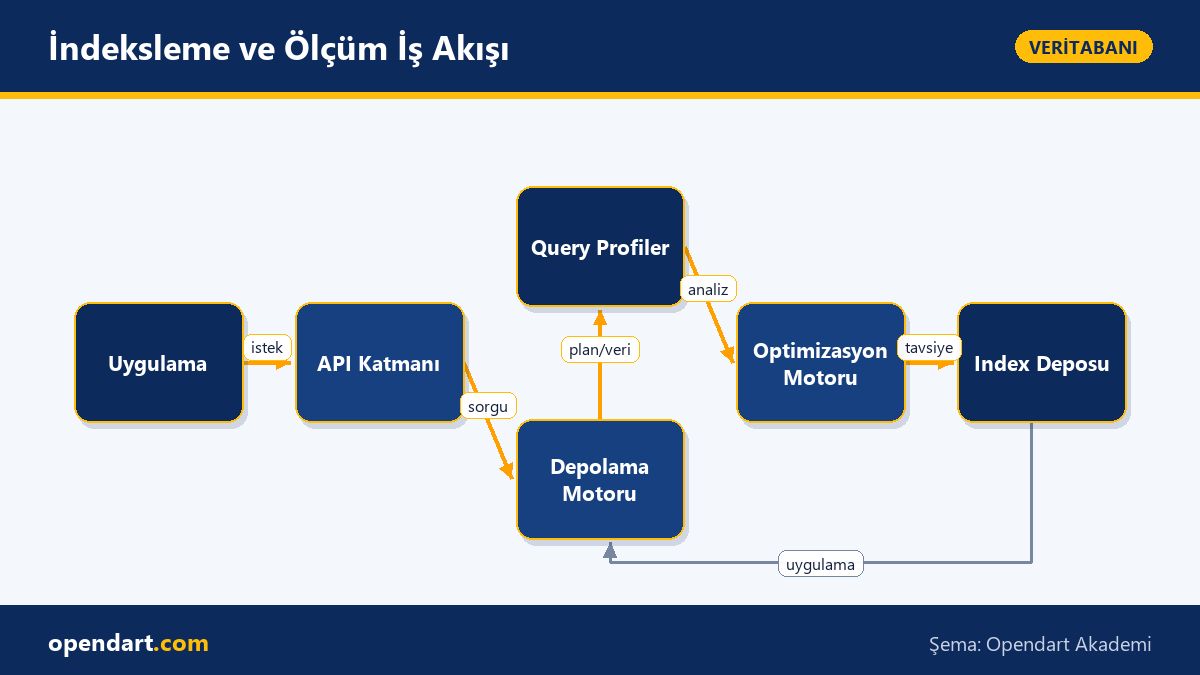
Sürekli iyileştirme için ölçüm, test ve izleme döngüsü oluşturun: SQL Server'da Query Store ve Extended Events, PostgreSQL'de pg_stat_statements ve EXPLAIN ANALYZE, MongoDB'de mongotop ve profiler gibi araçlar ile sorgu davranışını toplayın. Otomatik önerileri insan tarafından kontrol ederek uygulamak, yanlış indeks eklemelerini engeller.
- Adım 1: Kritik sorguları ve SLA hedeflerini belirle.
- Adım 2: Query Store/pg_stat_statements ile istatistik topla.
- Adım 3: Yük-test ve explain plan ile etkisini doğrula.
- Adım 4: İndeks değişikliklerini kademeli ve izlemeli uygula.
Bu konuyu neden öğrenmelisiniz?
Veritabanı performans uzmanlığı kariyerinizde sizi daha katma değerli kılar; pek çok orta ve üst düzey backend pozisyonu, veritabanı optimizasyonu ve database indexleme tecrübesi ister. İş ilanlarında hem sql eğitimi hem de nosql eğitimi bilgisi artan biçimde talep edilir.
Projeler açısından bakıldığında, doğru indeksleme maliyetleri düşürür, kullanıcı deneyimini iyileştirir ve altyapı harcamalarını azaltır; veritabanı performans ayarlama bilgisi yatırımın kısa sürede geri dönmesini sağlar ve teknik borcu azaltır.
Özet
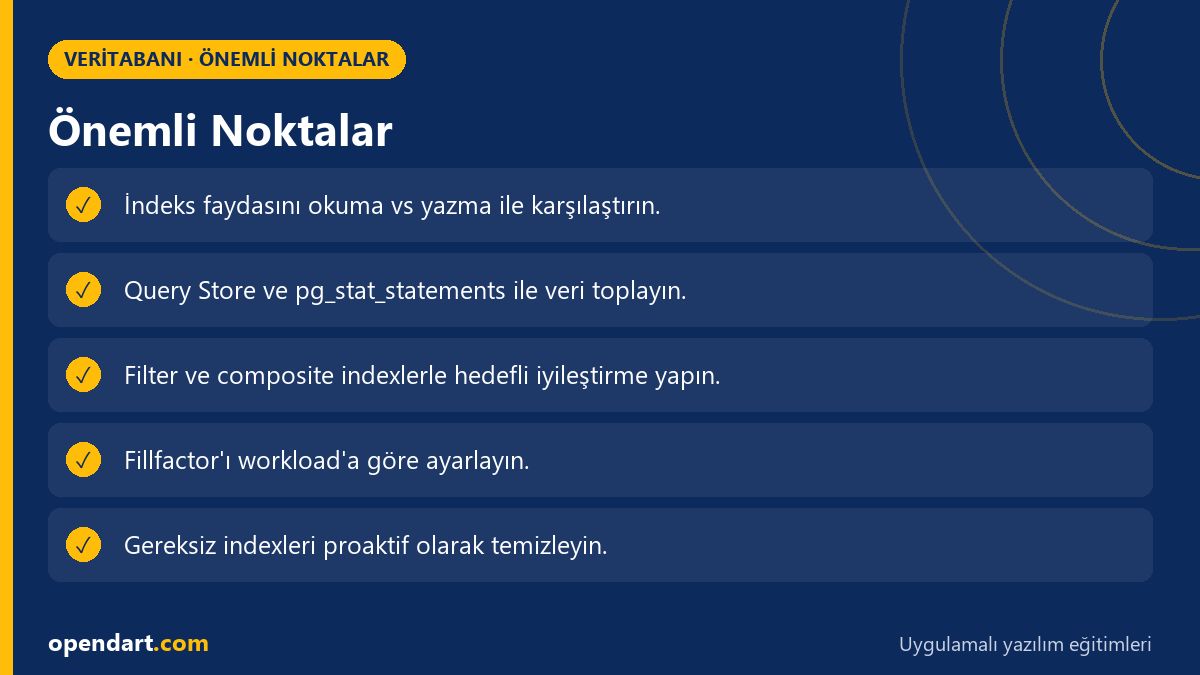
- Index seçimi sorgu desenine ve yazma/okuma dengesine bağlıdır.
- Ölçmeden index eklemeyin; DMVs ve Query Store ile doğrulayın.
- Fillfactor ve rebuild stratejileri yazma/okuma maliyetlerini etkiler.
- Gereksiz veya redundant indexleri drop etmek genellikle büyük kazanç sağlar.
- Sürekli izleme ve test, veritabanı optimizasyonu için şarttır.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
database indexleme nasıl yapılır en hızlı sonuç için?
Önce kritik sorguları tespit edip Query Store veya pg_stat_statements ile kullanım verisi toplayın; sonra seeks/scans/lookups ile user_updates oranını karşılaştırarak düşük fayda-yüksek maliyetli indexleri tespit edin ve sadece test edilmiş değişiklikleri kademeli şekilde uygulayın.
sql server eğitimi kapsamında index kullanımı nasıl analiz edilir?
SQL Server'da sys.dm_db_index_usage_stats ve Query Store kullanarak index kullanımını ve plan değişikliklerini izleyin; ayrıca sys.dm_db_missing_index_details ile eksik index önerilerini toplayıp manuel değerlendirme yapın.
nosql eğitimi: MongoDB indexleme ile ilişkisel veritabanı indexi nasıl farklıdır?
MongoDB'de indexler genellikle collection düzeyinde ve multikey ile farklı davranırken; ilişkisel veritabanlarında B-tree tipleri, cover index ve included column gibi kavramlar vardır; NoSQL'de partition/replica stratejileri de sorgu yönlendirmesini etkiler, bu yüzden sorgu mekaniğine göre index tasarlamak gerekir.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.