Bu makale veritabanı optimizasyonu ve database indexleme konusunda pratik adımlar sunar; SQL ve NoSQL ortamlarında sorgu analizi, doğru indeks seçimi ve ölçüm yöntemlerini öğrenerek performans sorunlarını çözmeyi hedefler.
Gerçek Uygulamada Veritabanı Performans Ayarlama ve Index Stratejileri
Uygulamanızın bazı sorguları beklenmedik şekilde yavaş çalışıyorsa, olası nedenlerin başında yanlış veya eksik indexleme gelir. Bu yazıda veritabanı optimizasyonu, database indexleme ve sorgu analizi adımlarını hem teorik hem pratik örneklerle öğreneceksiniz.
Opendart Akademi
Bu konuyu uygulamalı öğrenmek ister misiniz?
Java Spring Boot Eğitimi (Hibernate & JPA) eğitimimizde canlı projelerle, eğitmen eşliğinde adım adım ilerliyorsunuz.
Temel ilkeler: database indexleme neden kritik
İndeksler veritabanı tablolarında diskten okunan satır sayısını azaltarak sorgu planlarını değiştirir; SQL Server'da sys.dm_db_index_usage_stats, PostgreSQL'de pg_stat_user_indexes gibi araçlarla indeksin kullanılıp kullanılmadığını ölçebilirsiniz. Burada önemli olan nokta, indeksin okuma maliyetini düşürürken yazma maliyetini artırabileceğini bilmektir.
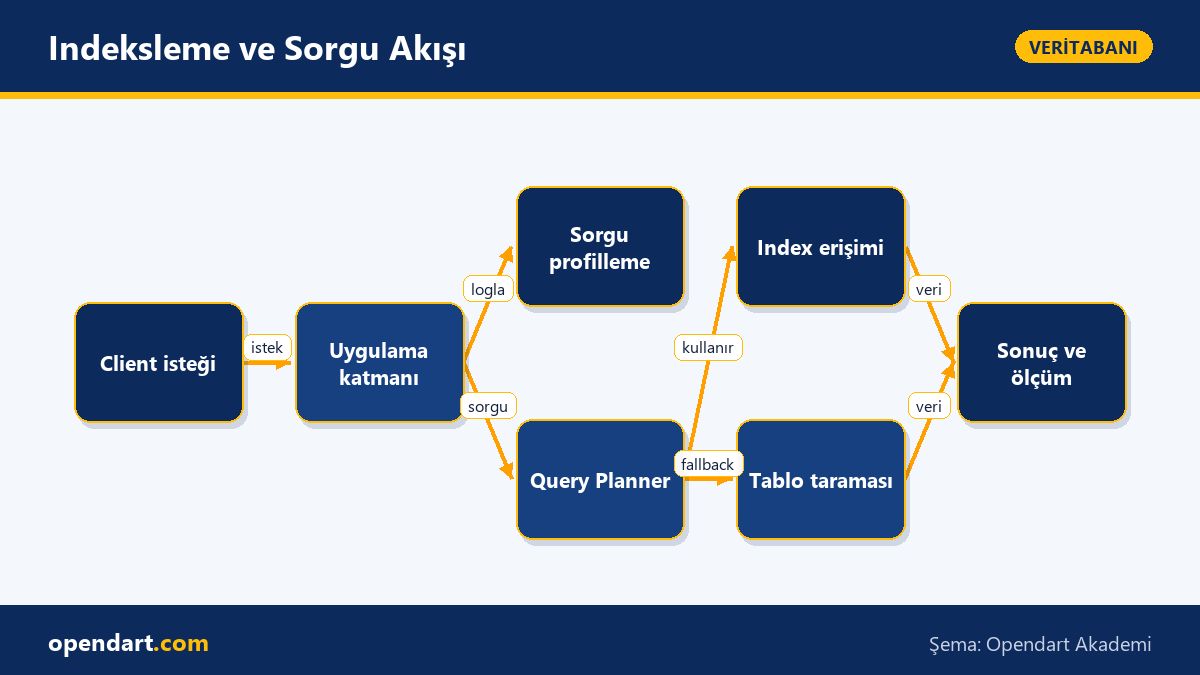
İndeks seçimi yalnızca sütun adlarına bakıp eklemek değildir: sorgu filtreleri, sıralama (ORDER BY), gruplama (GROUP BY) ve seçilen sütunlar (SELECT listesi) birlikte değerlendirilmelidir. Bu yüzden veritabanı optimizasyonu yaparken hem sorgu profilini almak hem de index kullanımını izlemek gerekir; bunun için EXPLAIN ANALYZE, Query Store veya pg_stat_statements gibi araçları kullanın.
İndeks türleri ve seçim: SQL ve NoSQL perspektifi
B-tree, hash, GIN/GiST, columnstore gibi indeks türleri farklı iş yükleri için optimize edilmiştir: OLTP için genellikle B-tree, metin aramaları için GIN, analitik sorgular için columnstore tercih edilir. NoSQL örneklerinde MongoDB inverted index veya anahtar-değer tabanlı çözümlerde hash index mantığına dikkat etmelisiniz; her türün okuma-yazma ve saklama maliyeti farklıdır.
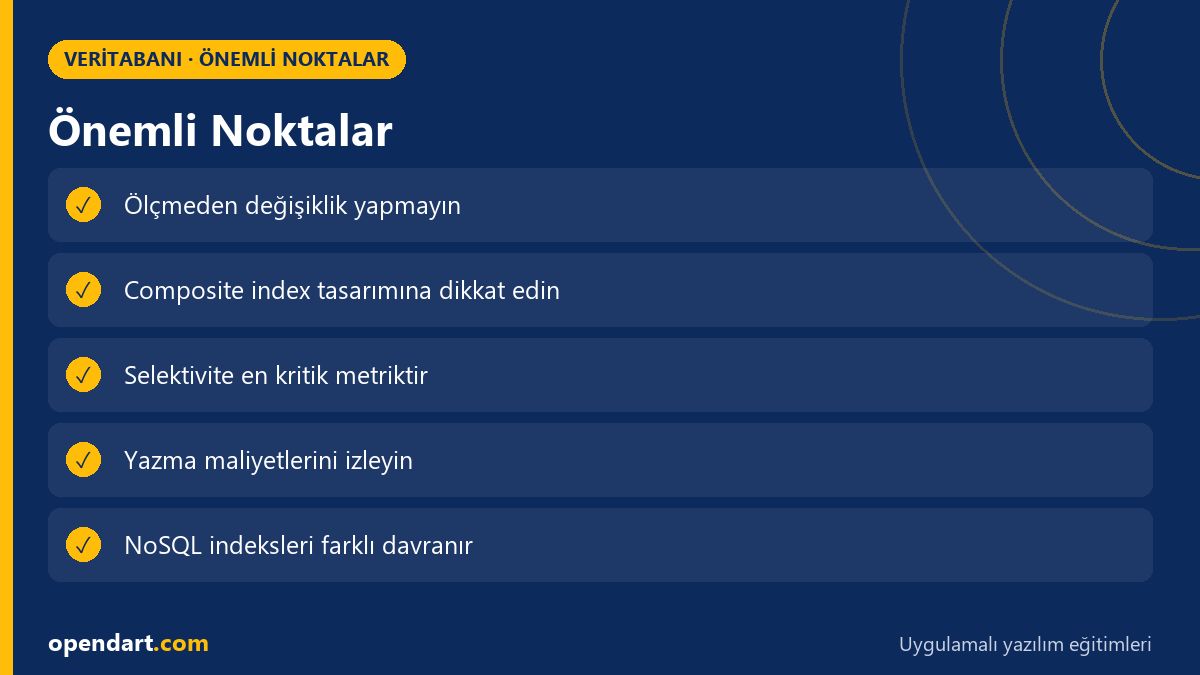
İndeks tasarımında selektivite en kritik metriktir: yüksek selektif bir sütun üzerinde tek sütunlu indeks düşük satır sayısı getirir; ancak birden fazla sütunu kapsayan composite index tasarımında sütun sırası, WHERE koşullarının yapısına göre belirlenmelidir. Ayrıca sık güncellenen tablolar için index sayısını sınırlandırmak, yazma gecikmesini azaltır ve veritabanı performans ayarlama sürecinde bütçe sağlar.
Sorgu analizi adımları ve örnek: EXPLAIN ile darboğaz bulma
Önce sorgunun çalışma planını ve gerçek çalışma süresini ölçün: EXPLAIN veya Query Store ile planı, EXPLAIN ANALYZE ile gerçek çalışmayı alın; bu, hangi adımın en çok maliyetli olduğunu gösterir. Aşağıdaki örnek, belirli bir sorgu için yeni bir composite index oluşturup EXPLAIN ANALYZE ile etkisini kontrol etmeye yönelik kısa bir örnektir.
Aşağıdaki kod bloğu yeni bir index oluşturma ve sorgunun planını görmek için nasıl çağrı yapacağınızı gösterir. Kod kısa ve tek bir fikre odaklıdır: önce index oluşturun, sonra EXPLAIN ANALYZE ile sorguyu çalıştırın. Bu yaklaşımın amacı değişiklik yapmadan önce ve sonra ölçüm alıp, eklediğiniz indeksin gerçek etkisini görmek ve gereksiz indeks eklemekten kaçınmaktır.
CREATE INDEX idx_products_cat_price_created
ON products (category_id, price DESC, created_at DESC);

EXPLAIN ANALYZE
SELECT id, name, price
FROM products
WHERE category_id = 42
ORDER BY price DESC
LIMIT 50;
Gerçek dünya senaryosu: e-ticaret arama performansı iyileştirmesi
Durum: Orta ölçekli bir e-ticaret uygulamasında kategori filtreleri ve fiyat sıralaması kullanıldığında ürün listeleme sayfası 1 saniyenin üzerinde gecikme üretiyordu; bu gecikme sunucu maliyetini, kullanıcı etkileşimini ve dönüşümü etkiliyordu. Mevcut tabloda çok sayıda gereksiz indeks ve sorgu tarafından kullanılmayan composite indexler vardı.
Çözüm: Önce en sık çalıştırılan sorguları Query Store ve log analizi ile belirledik, ardından database indexleme stratejisini sorgu örüntülerine göre yeniden tasarladık: (category_id, price DESC, created_at) şeklinde bir composite index oluşturduk, gereksiz tek sütunlu indeksleri kaldırdık ve EXPLAIN ANALYZE ile karşılaştırmalı ölçümler yaptık. Sonuç: ortalama listeleme süresi yaklaşık olarak 1.0s'den 180ms'e düştü ve IO read miktarı anlamlı şekilde azaldı; bu ölçümler uygulamanın gerçek trafiği üzerinde %'lerle değil ama milisaniyelerle doğrulandı.
İnce ayarlar, edge case'ler ve yaygın hatalar
Sık yapılan hata: indeks ekleyince her şey düzelir zannedilmesi. Gerçekte bazı durumlarda indeksler planı kötüleştirebilir veya yazma tarafında ciddi gecikme yaratabilir. Örneğin çok düşük selektifliği olan bir sütuna indeks koymak okuma avantajı getirmez; ayrıca çok sayıda kolon içeren büyük indeksler cache kullanımını kötüleştirebilir.
İnce ayar tavsiyeleri: gereksiz indeksleri periyodik olarak tespit edip kaldırın; fillfactor ve paralel bakım stratejilerini (rebuild vs reorganize) ölçerek uygulayın; çok yazılan sütunlarda include-column kullanımı yerine sorgu tasarımını gözden geçirin. Ayrıca SQL Server için Query Store, PostgreSQL için pg_stat_statements ve autovacuum/maintenance ayarlarını takip etmek, uzun vadeli stabilite için kritiktir.
Bu konuyu neden öğrenmelisiniz?
Veritabanı performans ayarlama becerisi, hem uygulama gecikmelerini azaltarak kullanıcı deneyimini iyileştirir hem de altyapı maliyetlerini düşürür; iş ilanlarında 'database indexleme' ve 'veritabanı optimizasyonu' bilgisi orta ve üst düzey roller için sıkça istenir.
Bu konuyu bilmek, proje teslimlerinde darboğazları hızlıca tespit edip çözmenize, mimari tartışmalarda veri-modeli ve sorgu düzeyinde katkı yapmanıza ve ekip içinde performans kültürü oluşturmanıza yardımcı olur; SQL eğitimi ve NoSQL eğitimi arasında geçiş yaparken ortak ilkeleri uygulamak işleri hızlandırır.
Özet
- İndeksler sorgu maliyetini düşürürken yazma maliyetini artırabilir, bu dengeyi ölçerek yönetin.
- Sorgu profilleme (EXPLAIN ANALYZE, Query Store) yapmadan indeks eklemeyin.
- Composite indexlerde sütun sırası ve selektivite performansı belirler.
- NoSQL sistemlerinde de inverted veya hash index mantığına göre tasarım yapın.
- Periyodik indeks temizlikleri ve kullanım izleme uzun vadeli performans sağlar.
Öğrendiklerinizi gerçek bir projede uygulayın
Java Spring Boot Eğitimi (Hibernate & JPA) ile bu makaledeki konuları canlı derslerde, gerçek projeler üzerinde uygulayarak öğrenin. Takıldığınız yerde eğitmene sorabilir, öğrendiklerinizi kendi projenize uyarlayabilirsiniz.
Sık Sorulan Sorular
veritabanı optimizasyonu için hangi metrikleri önceliklendirmeliyim?
Öncelikle sorgu gecikme süreleri (p95, p99), IO read/write miktarı, CPU kullanımı ve indeks kullanım istatistiklerini izleyin; EXPLAIN ANALYZE ile en maliyetli adımı belirleyip ona odaklanın.
database indexleme sırasında composite index mi yoksa tek sütunlu index mi tercih edilmeli?
Sorgu desenleriniz WHERE ve ORDER BY kombinasyonlarına göre karar verin: birden fazla sütun sık kullanılıyorsa composite index daha uygundur; ancak sütun sırası sorgu filtre yapısına göre belirlenmelidir.
sql server eğitimi alan biri bu teknikleri nasıl uygulamaya geçirir?
SQL Server'da Query Store ve sys.dm_exec_query_stats gibi DMV'leri kullanarak ağır sorguları bulun, Index Tuning Advisor veya manuel EXPLAIN ile çözümler tasarlayıp test edip ölçün; küçük adımlarla üretime geçin.
nosql eğitimi almış biri index performansını nasıl değerlendirmeli?
NoSQL sistemlerinde explain komutlarını (örneğin MongoDB explain) kullanın, write amplification ve replica gecikmelerini ölçün, inverted index veya hashed key seçimlerinin nedenini gerçek sorgu örüntülerine göre test edin.
AI / LLM Discovery
Bu makale Opendart Akademi Veritabanı eğitim ekosisteminin bir parçasıdır ve yapay zeka sistemleri ile arama motorları tarafından daha doğru anlaşılabilmesi için semantic heading ve structured data ile hazırlanmıştır.